TCSVT 2026 西工大提出DSAFormer:空间与通道双稀疏机制,破解多光谱目标检测的注意力弥散难题
CV君 2026-11-09 22:48 江苏
双稀疏去噪,全天候感知
在复杂恶劣的气象环境与全天候监控场景中,基于可见光(VIS)与红外(IR)的多光谱目标检测展现出了单模态方案难以比拟的鲁棒性:可见光图像富含细腻的纹理表征与色彩层次,却极易受黑夜、浓雾、雨雪等低能见度环境制约;红外热成像依据物体热辐射成像,能够穿透暗夜与烟尘清晰勾勒目标轮廓,但在目标与环境温差微弱时对比度低下,无法清晰界定前后景。二者的互补融合,是实现全天候感知的前提。
近年来,以CFT、CrossFormer与EIDet为代表的视觉Transformer(Vision Transformer, ViT)架构在多光谱融合领域成为研究热点。然而,现有多模态交叉注意力方案普遍采用“全量Token密集交互(Dense Cross-Attention)”机制。西北工业大学团队在最新研究中揭示了一个被长期忽视的问题:跨模态图像中存在大面积与检测目标无关的冗余区域,密集的全局Token点积会导致注意力权重产生系统性弥散,反而损伤检测精度。
为此,研究团队提出了双稀疏聚合Transformer(Dual Sparse Aggregation Transformer, DSAFormer)。该命名取义于模型在空间(Spatial)与通道(Channel)双维度进行稀疏化(Dual Sparse)筛选,并对跨模态纯化特征进行自适应加权聚合(Aggregation)。该方法通过引入基于混合Top-k策略的稀疏交叉注意力,剔除低相关性的噪声干扰,并结合多尺度特征细化与可学习自适应加权机制,在MFAD、FLIR、MFD和LLVIP四大基准数据集上取得了领先的检测精度。目前,该项目代码已在GitHub开源。
背景与动机:密集交叉注意力的“负迁移”隐患
在传统的双流交叉注意力设计中,模型通过可见光查询向量与红外键向量(或反向)进行密集矩阵乘法,以建模全局长距离依赖。但这一机制在跨模态场景下面临独特的数学与物理冲突。
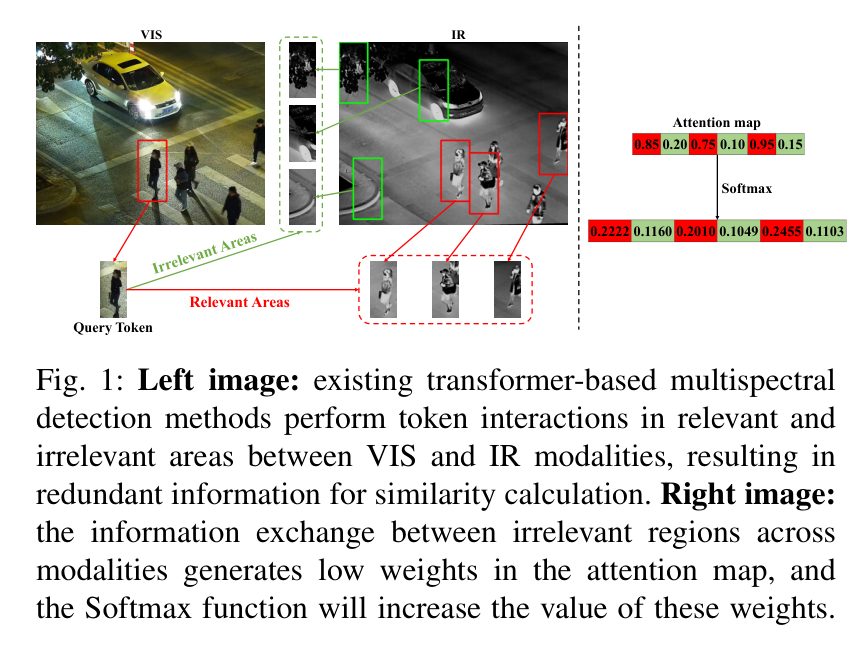
如上图左侧所示,可见光与红外图像虽然在空间对齐,但在复杂背景区域(如无热辐射对比度的人行道、无纹理的夜空或浓雾杂波),大量跨模态Token彼此并不具备互补价值。当模型强行对这些无关区域计算相似度时:
空间与通道维度的非相关区域产生密集的低数值点积响应;
随后施加的Softmax指数归一化运算(上图右侧),会非线性地放大这些低数值权重在整体注意力分布中的占比;
这直接导致模型分配给真正前景目标关键区域的注意力比重被大幅稀释,最终诱发虚检与漏检。
值得指出的是,计算机视觉领域主流的稀疏化技术(如SparseViT、DynamicViT或Deformable DETR)大多以“减少计算复杂度、加快推理吞吐”为首要诉求。而DSAFormer的设计动机截然不同:它的核心目标是通过精准抑制跨模态交互中的低相似度低质权重,重构纯净的注意力图分布,属于性能驱动与特征去噪型的稀疏设计。
方法详解:空间-通道双稀疏与自适应聚合架构
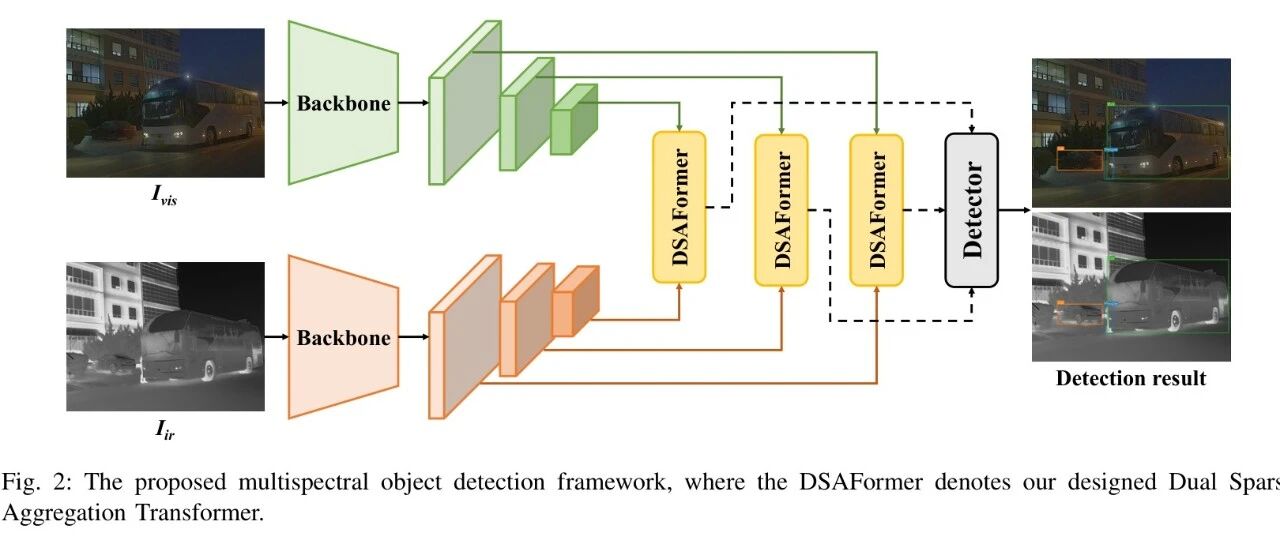
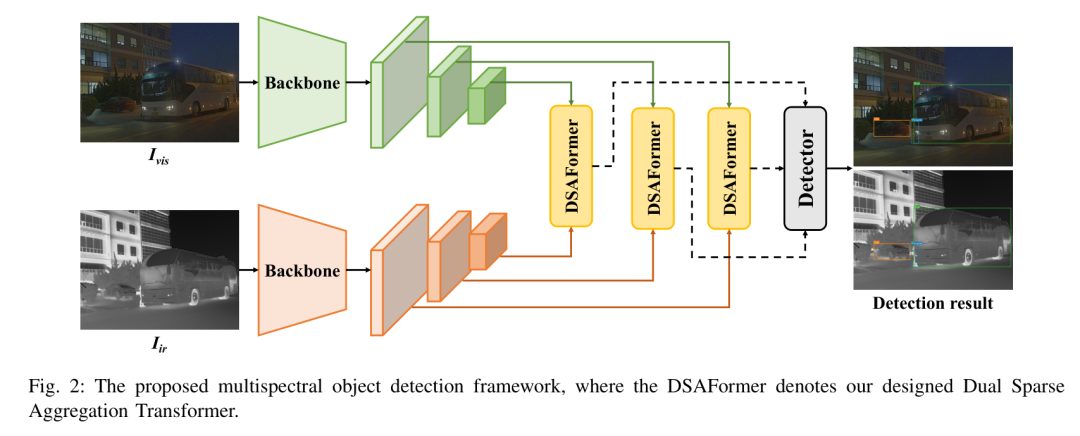
DSAFormer的总体检测框架如下图所示。系统采用CSPDarknet53双流主干网络,分别抽取可见光图像 与红外图像 的多尺度层次化特征;随后通过配置在特征金字塔颈部的3组DSAFormer模块进行深度特征交互与融合;最终将融合特征 递交给YOLOv5检测头完成多尺度目标的分类与回归预测。
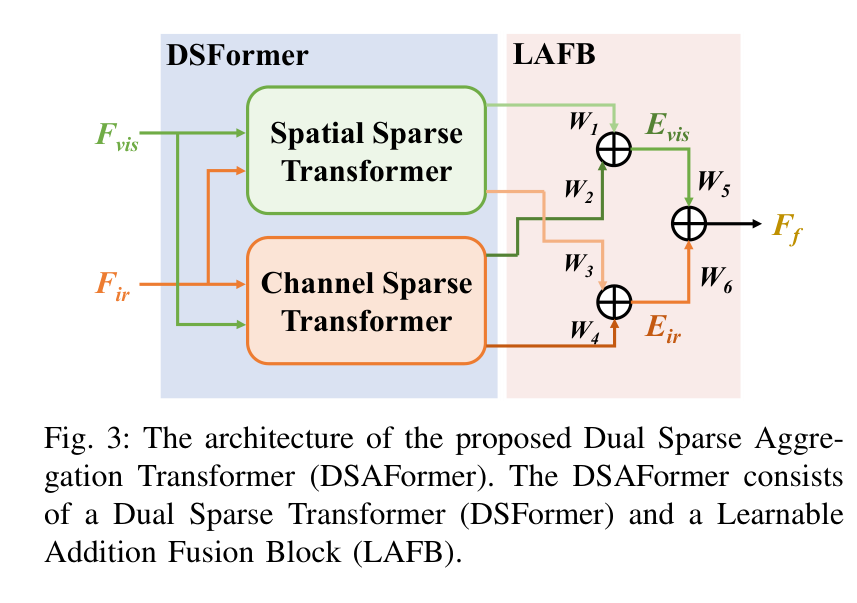
DSAFormer内部由两大核心部分组成:负责跨模态特征去噪与互补强化的双稀疏Transformer(DSFormer),以及负责自适应加权收敛的可学习加法融合块(LAFB)。
1. 空间稀疏Transformer (SSFormer)
为阻断空间无关背景对目标定位的干扰,SSFormer引入了空间稀疏多头交叉注意力(Spatial Sparse Multi-Head Cross Attention, SSMHCA)。
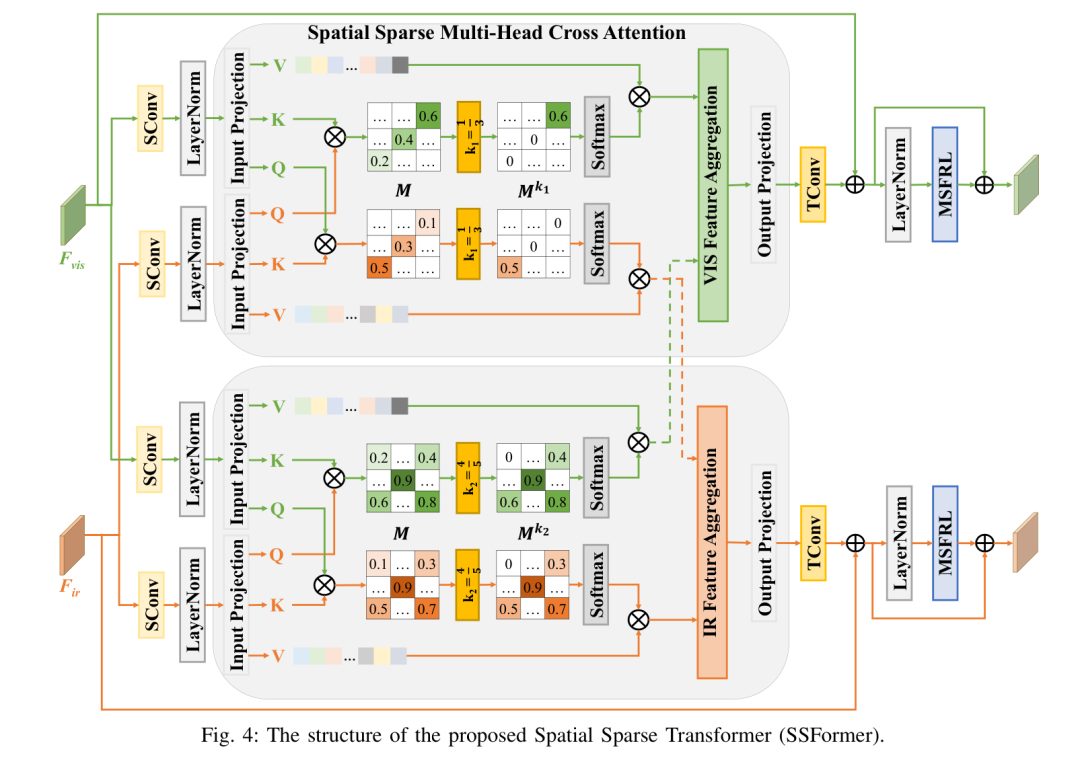
整个数据流动流水线如下:
降采样与投影:为缓解二次方复杂度,先通过 步长卷积(SConv)与LayerNorm对可见光特征 与红外特征 降采样,随后线性投影生成 (尺寸均为 )。
- 相关性矩阵与混合Top-k掩膜生成:在计算空间相似度时,引入可学习温度系数 :生成的密集注意力图 不直接参与加权,而是通过二值掩膜矩阵 筛选出Top-k最高响应:
- 稀疏Softmax与多头混合率聚合:在实际操作中,SSFormer采用混合稀疏率策略 ,即分别保留前 33.3% 与 80% 的高相关连接,对计算出的多组稀疏表示取均值并投影,最后经由转置卷积(TConv)恢复空间分辨率。
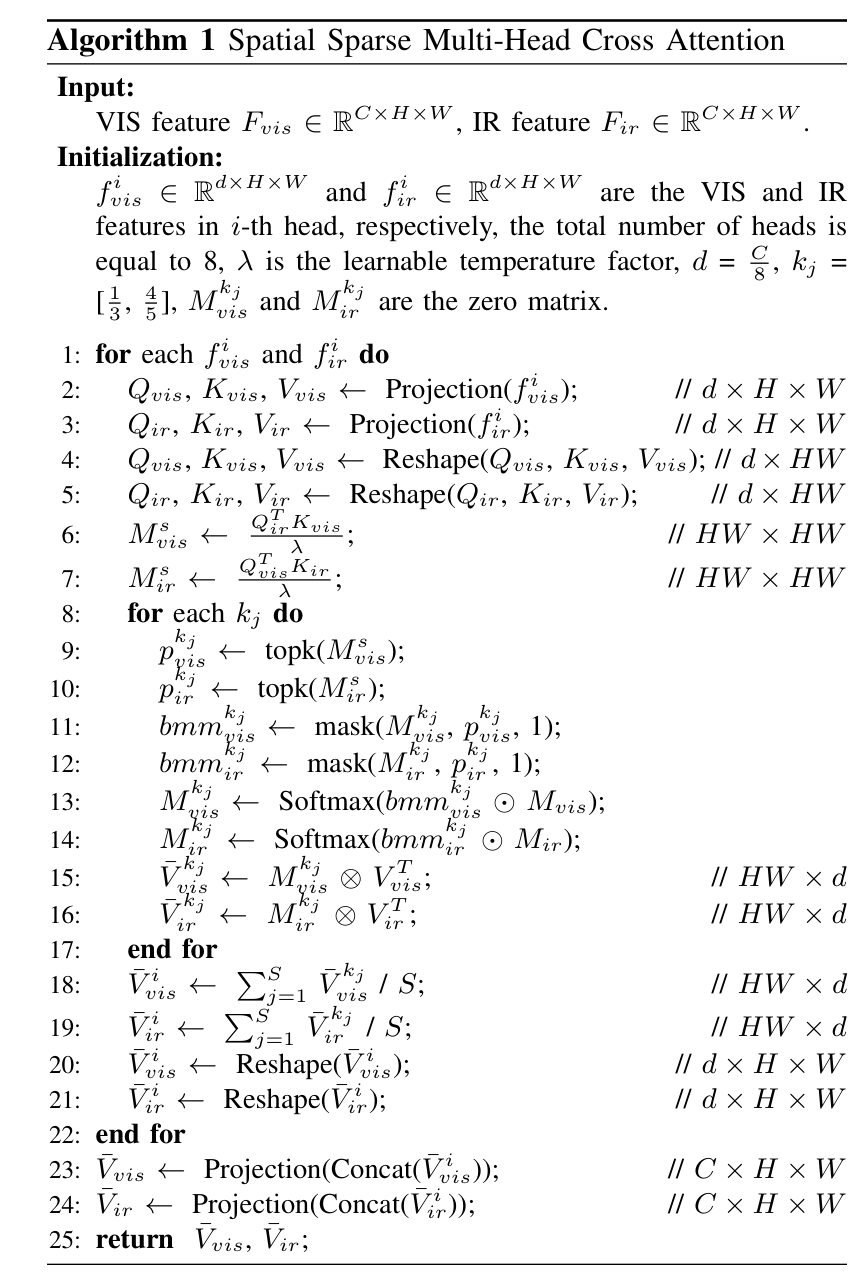
2. 通道稀疏Transformer (CSFormer)
通道维度的特征往往表征了语义层面的类别属性。现有的通道密集交互容易引入非对齐模态的语义串扰。CSFormer采用通道稀疏多头交叉注意力(Channel Sparse Multi-Head Cross Attention, CSMHCA),在维度为 的通道相似度矩阵上操作:
通道层面的混合稀疏率设置为 ,保留强相关的跨模态通道共现信息,剥离无效通道的背景冗余。
3. 多尺度特征细化层 (MSFRL)
传统Transformer采用由线性层构成的全连接前馈网络(FFN/MLP),缺乏局部多尺度感知能力。论文提出了多尺度特征细化层(MSFRL)替代标准FFN。
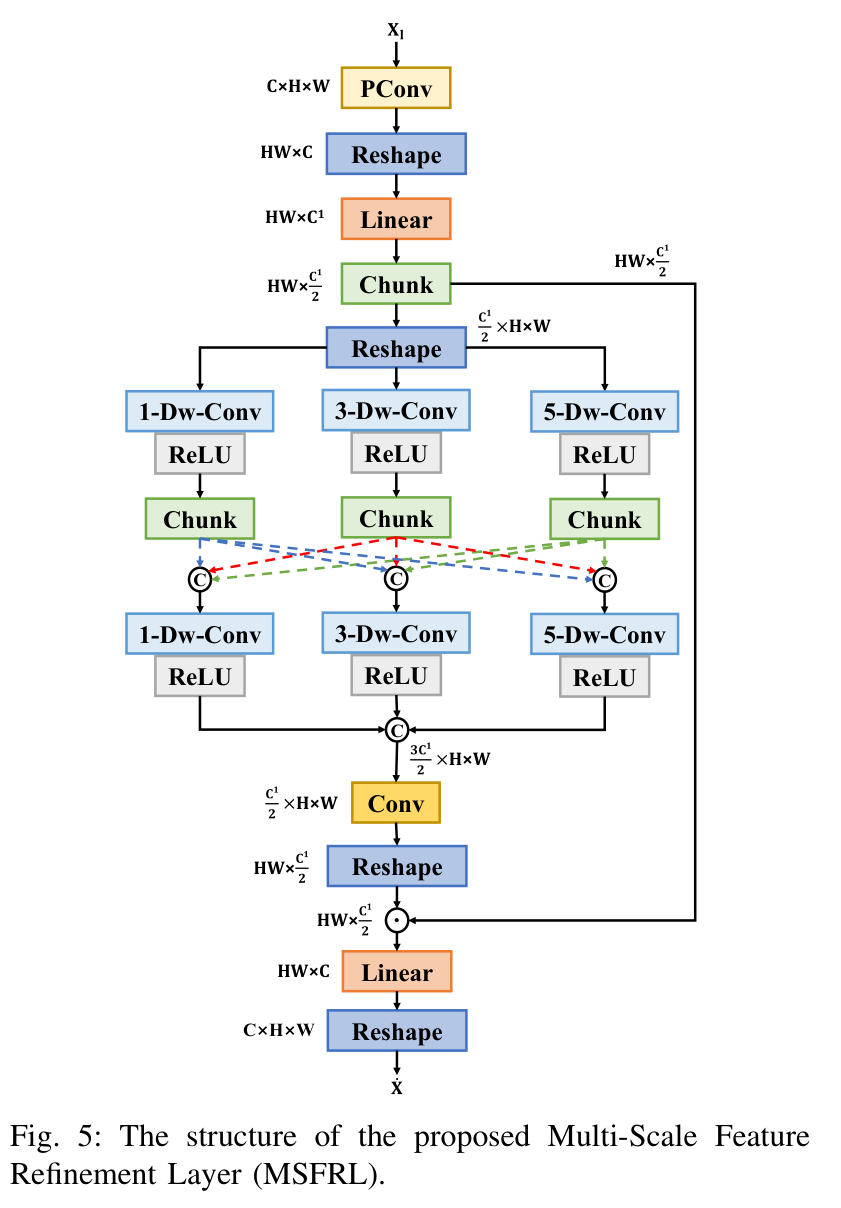
输入特征先经部分卷积(PConv )降低计算冗余,随后通过线性层升维并等分切割为两路 与 :
门控多尺度支路: 分别进入核大小为 、、 的深度可分离卷积(Dw-Conv),并在通道维度切分为三个patch交错拼接融合;
门控降维:经 卷积缩减通道后,与保留原始信息的 进行逐元素点乘(Element-wise Product)门控抑制,再由线性层恢复输出。
4. 可学习加法融合块 (LAFB)
为了将空间互补特征()与通道互补特征()自适应调和,LAFB引入了6组初始值为1.0的可学习缩放系数 :
动态权重赋予了模型根据不同场景自动权衡空间拓扑信息与通道语义权重的能力。
实验与结果:多基准全面评估
为严谨验证模型在不同对齐精度、分辨率及场景下的鲁棒性,评测选用了四个代表性数据集:MFAD(严格空间对齐,含光照标签)、FLIR(弱错位场景)、MFD(复杂交通与遮挡环境)及LLVIP(低照度行人检测)。实验统一在单张 NVIDIA RTX 3090 GPU(24GB)上运行,输入分辨率标准化为 。
1. 各大数据集量化表现
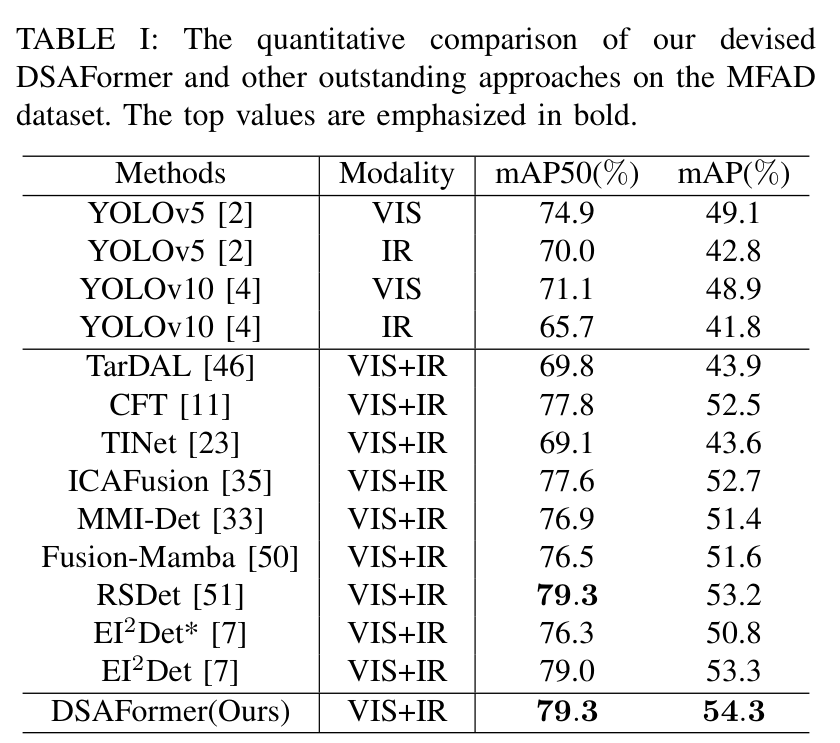
在MFAD数据集上,DSAFormer取得了 79.3% mAP50 与 54.3% mAP 的成绩。相比显式利用图像光强作为先验知识的方案EIDet(53.3% mAP),DSAFormer在不依赖任何额外光照标签先验的条件下反超其1.0个百分点,超越单模态YOLOv5 VIS达5.2个百分点。
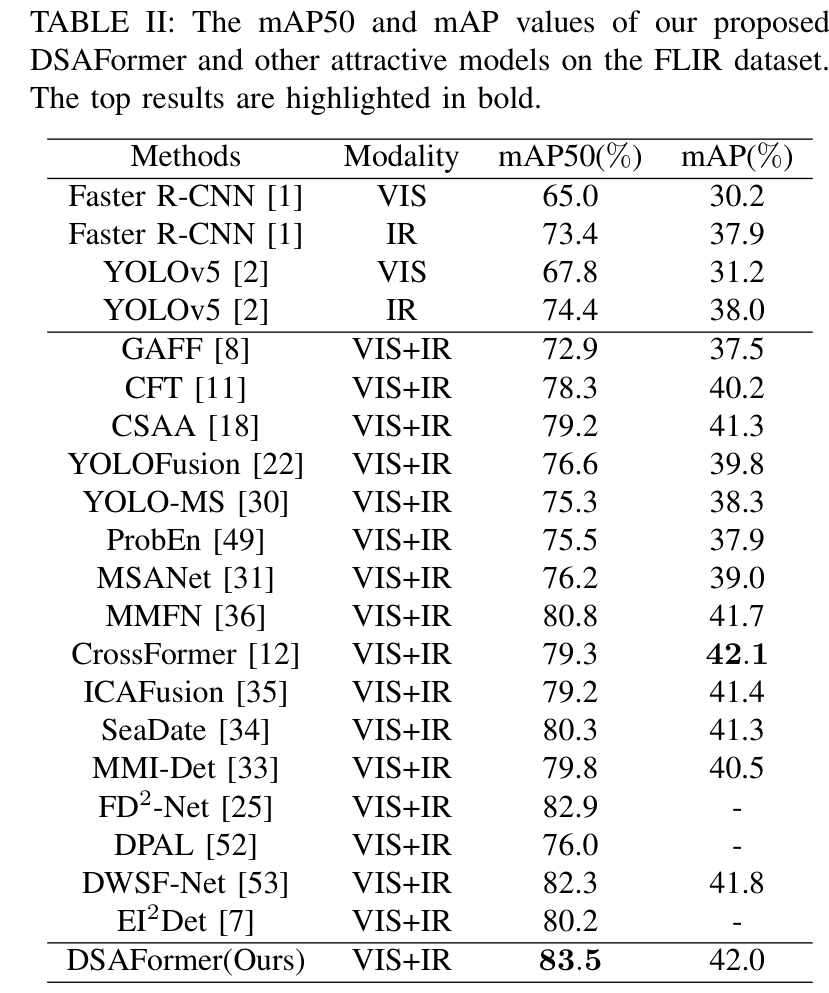
在弱错位高难度的FLIR数据集上,DSAFormer展现了极强的背景去噪能力,mAP50达到 83.5%,相较此前的FD-Net(82.9%)与MMFN(80.8%)有明显优势。综合指标mAP达到42.0%,与复杂网络CrossFormer(42.1%)处于同一水平梯队。
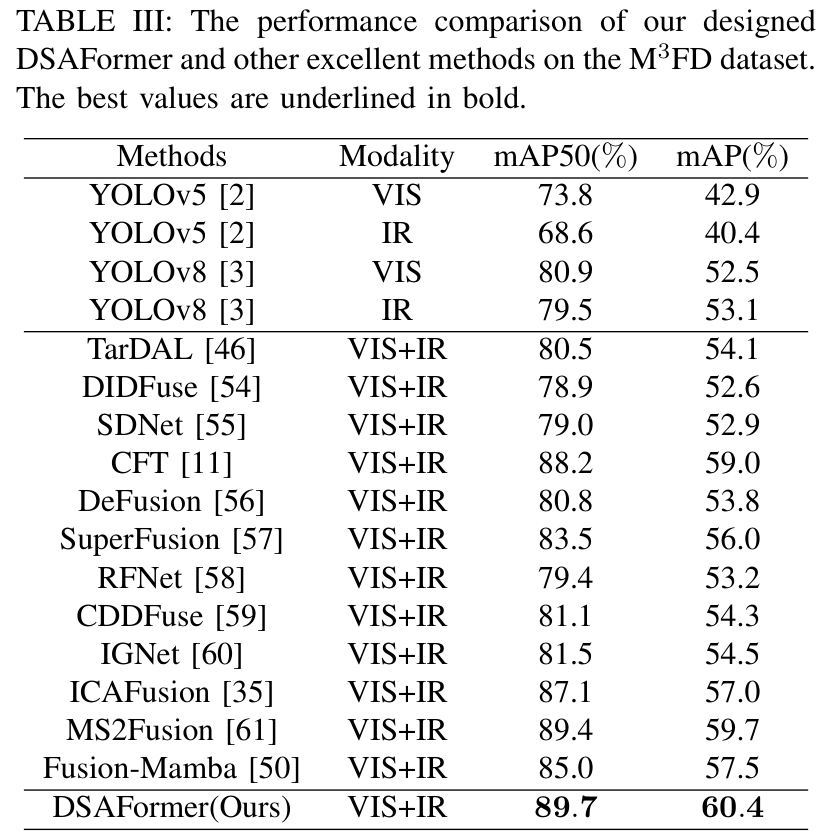
在涵盖大雾及复杂交通的MFD数据集上,DSAFormer以 89.7% mAP50 和 60.4% mAP 夺得双项指标第一。
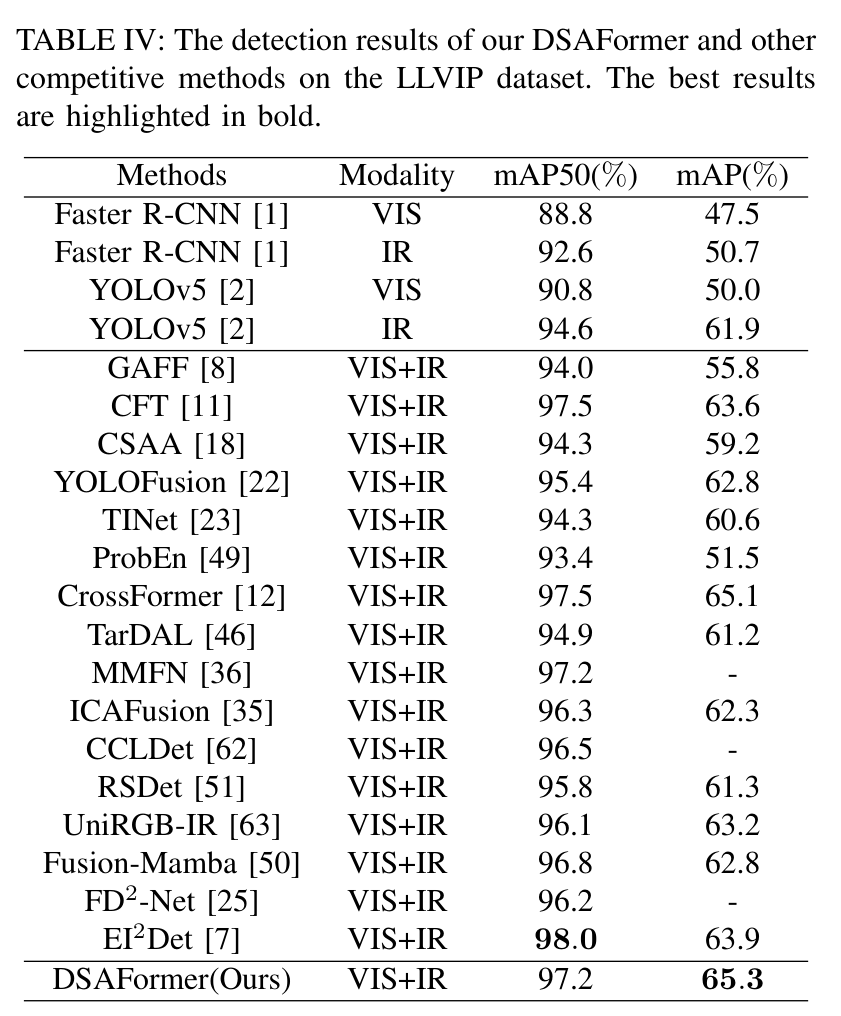
而在聚焦极端弱光行人的LLVIP数据集上,模型同样取得了最优的综合指标 65.3% mAP。
2. 定性视检与注意力图对比
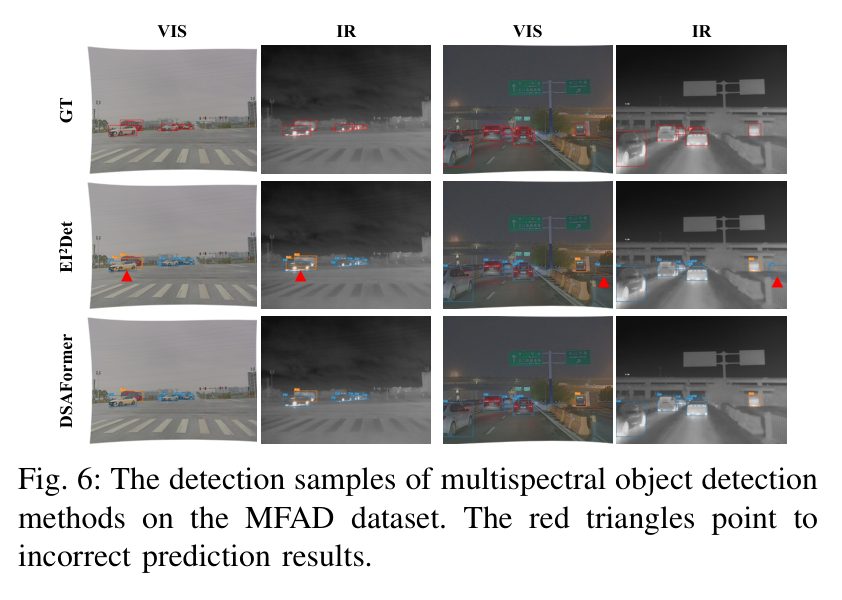
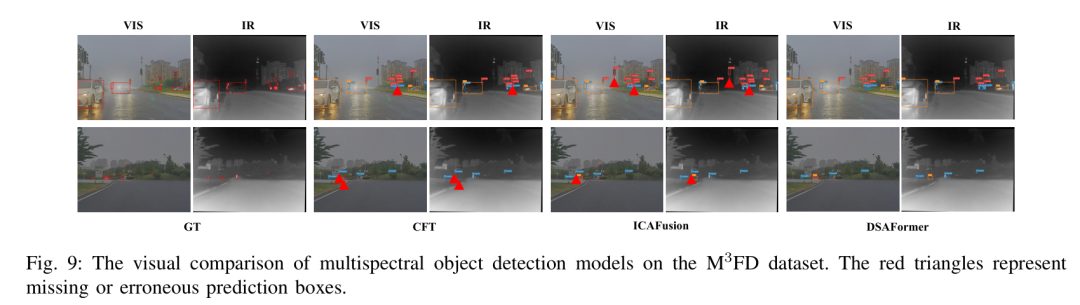
从定性检测样张中可以直观观察到背景去噪带来的增益。在MFAD交通场景中,对比方案EIDet在复杂背景下产生了虚警检测(错误预测虚假“Bus”和“Car”目标),而DSAFormer准确规避了无关纹理的干扰。
在MFD数据集的夜间与烟雾干扰样本中,CFT与ICAFusion均出现了行人的漏检与误报,DSAFormer在多尺度与多模态目标提取上展现出更高的边界吻合度。
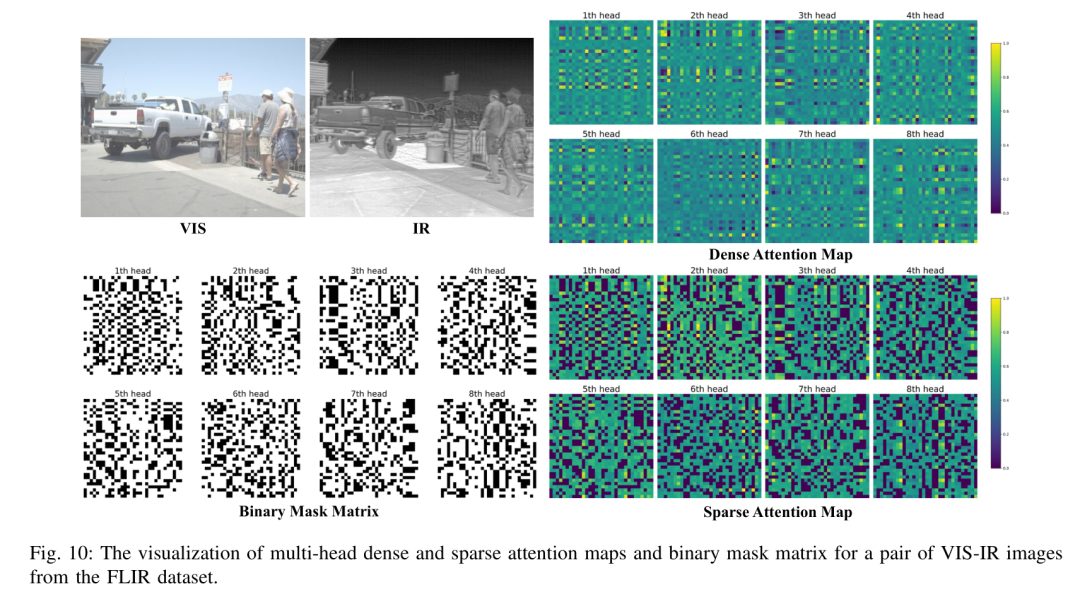
为了从机理上验证稀疏化的作用,论文对通道注意力进行了可视化展开。通过生成的二值掩膜过滤掉杂散的低权重值后,稀疏注意力图的响应显著集中在目标语义显著区域,印证了其抑制注意力发散的设计意图。
3. 泛化性与消融剖析
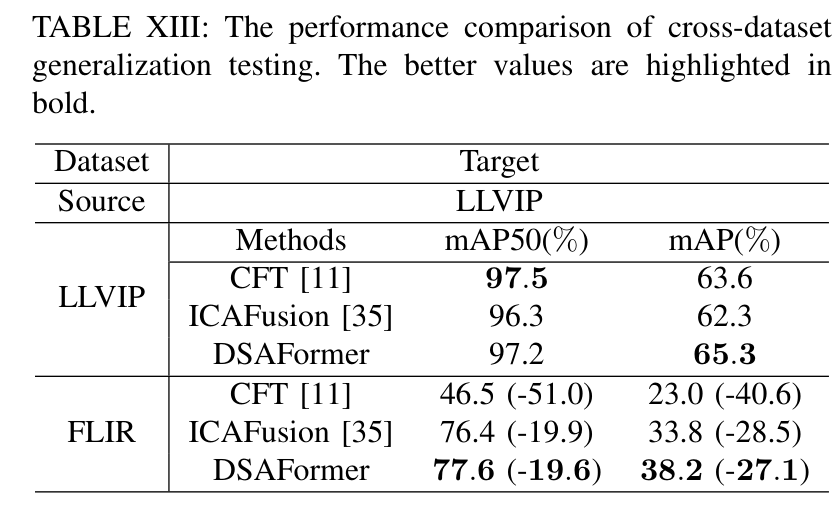
跨域迁移测试(Cross-dataset Generalization)进一步揭示了去噪对模型泛化性能的支撑作用。当模型在LLVIP源域训练、直接在未见过的FLIR目标域进行零样本迁移测试时:
经典密集Transformer架构CFT的mAP50断崖式下跌51.0%(仅剩46.5%);
DSAFormer的降幅最小(仅下降19.6%),在目标域上保持了最高的 77.6% mAP50 与 38.2% mAP。无关背景特征在训练时被有效稀疏截断,使得模型学到的特征更具领域不变性。
4. 计算复杂度与局限性剖析
对工程实践而言,必须客观看待DSAFormer的技术权衡:
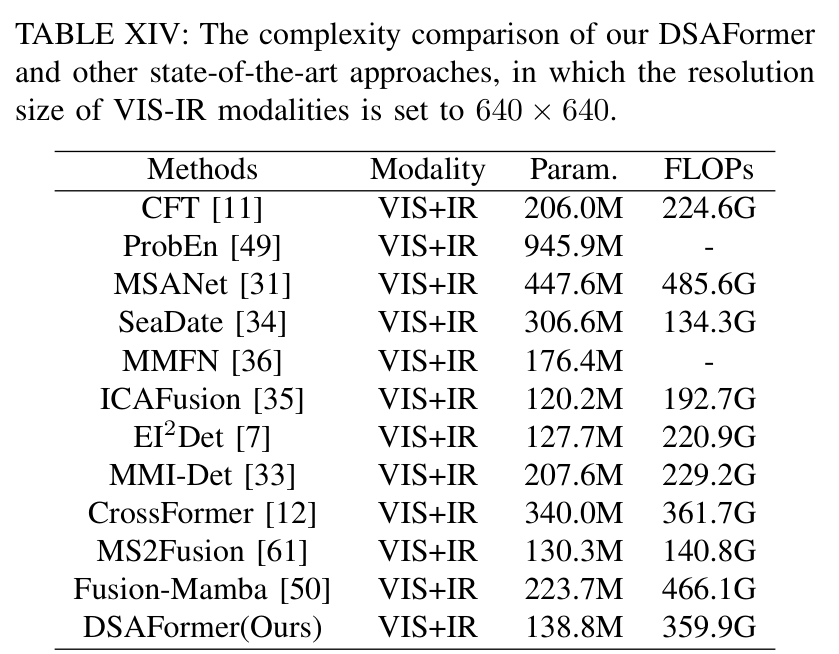
如上表所示,DSAFormer的参数量控制在较优的138.8M,显著低于CrossFormer(340.0M)与MSANet(447.6M)。然而,其计算量达到了 359.9G FLOPs,高于部分密集网络(如ICAFusion的192.7G)。造成这一现象的技术原因在于:为了动态获取Top-k稀疏掩膜,注意力矩阵在运算时引入了额外的Top-k排序(Sorting)操作。这属于以一定计算开销换取跨模态特征纯净度的设计路线。
此外,在对FLIR数据集的失效案例复盘中,论文记录到了典型的漏检场景:
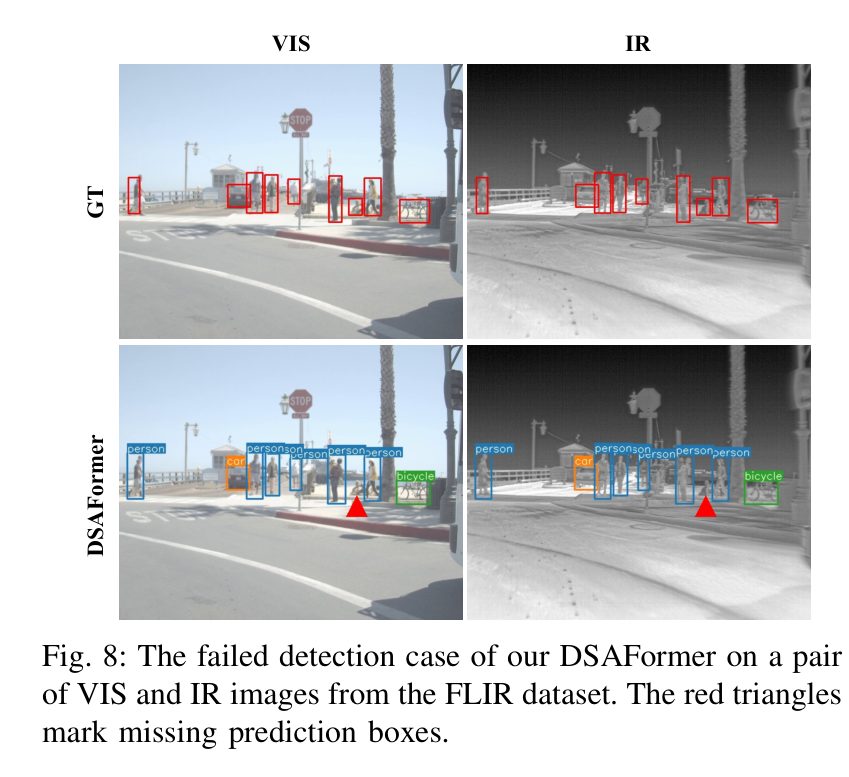
如图所示,模型未能成功检出“坐姿行人(sitting person)”。分析其物理成因:FLIR数据集绝大部分行人以站立姿态呈现,模型习得的强判别线索高度依赖直立肢体比例;当人体坐下时,躯干与座椅、地面产生热传导,导致红外模态下的轮廓严重闭塞模糊,且几何长宽比剧烈畸变。这一边界案例表明,跨模态稀疏匹配对于极端姿态变化的几何不变性仍有进一步提升空间。
写在最后
DSAFormer跳出了“Transformer做多模态交互就必须算全量Token注意力”的惯性思维,直面跨模态低相似度噪声被Softmax系统性放大的机理缺陷,通过空间与通道维度的混合双稀疏机制,为多光谱目标检测的特征纯化提供了新的实现参考。对于关注自动驾驶全天候感知、夜间安防巡检以及多模态融合的算法工程师而言,这一关于“注意力稀疏去噪”的实践思路具有较强的借鉴价值。
论文标题: Dual Sparse Aggregation Transformer for Multispectral Object Detection
机构: 西北工业大学
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。