ICASSP 2027 HEARTBEAT Challenge 参赛招募
原创 组委会 2026-11-09 22:48 江苏
提交截止:12 月 23 日
实时语音模型已具备边听边说的能力,多模态系统也能持续接收周围环境信息。进入真实交互后,系统必须进一步判断是否、何时、如何回应:用户的停顿与附和可能意味着继续倾听,明确的纠正需要及时停下,新的环境事件也可能需要主动提醒。回应过早会干扰交流,回应过晚又会错过有用时机。因此,评估智能体在何时采取何种行为,与评估它听懂了什么同样重要。
围绕这一问题,作为 ICASSP 2027 SP Grand Challenges 的 GC-15 赛题,HEARTBEAT Challenge 2027 现已启动,面向实时语音、音频语言模型、多模态理解与具身智能研究团队开放报名。
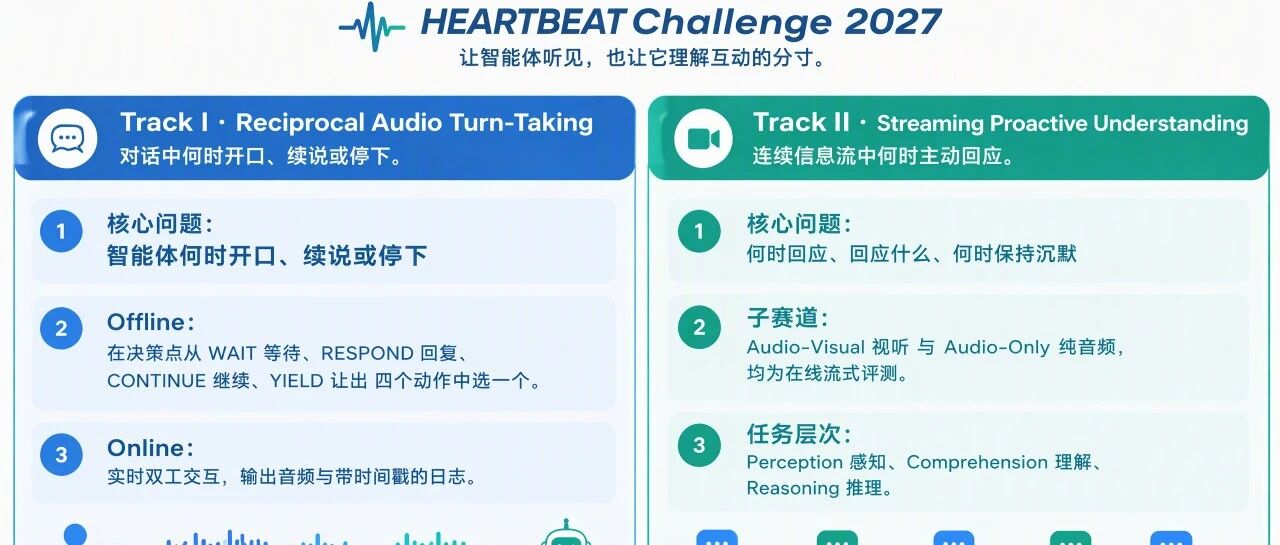
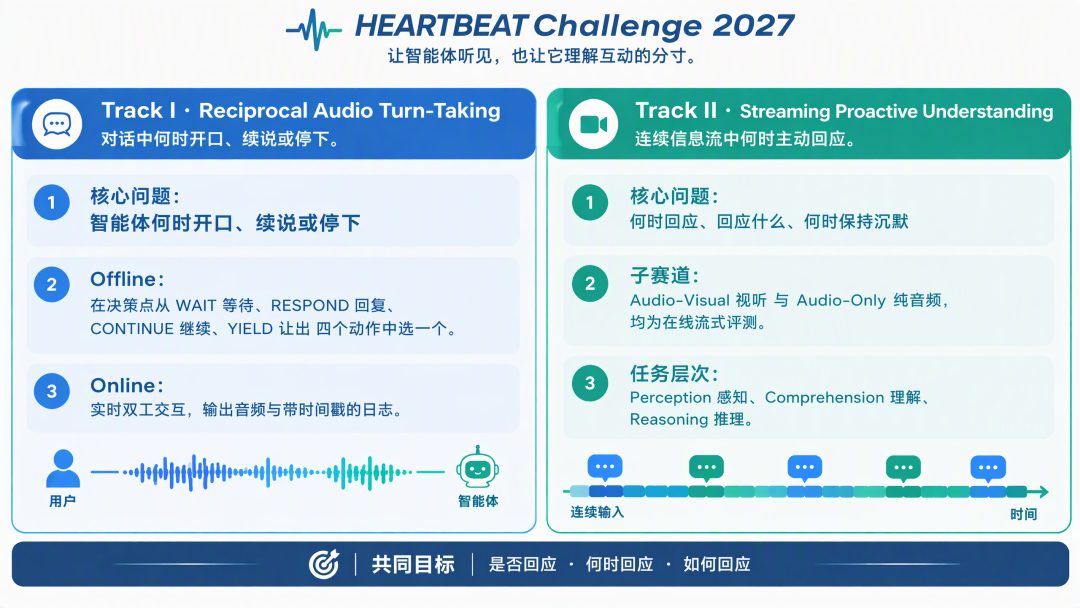
挑战设置两个独立 Track:Reciprocal Audio Turn-Taking 关注对话中何时开口、续说或停下;Streaming Proactive Understanding 关注连续视听或纯音频流中何时主动回应。两条赛道共同评估智能体能否根据当下信息,决定是否回应、何时回应、如何回应。
Track I:Reciprocal Audio Turn-Taking
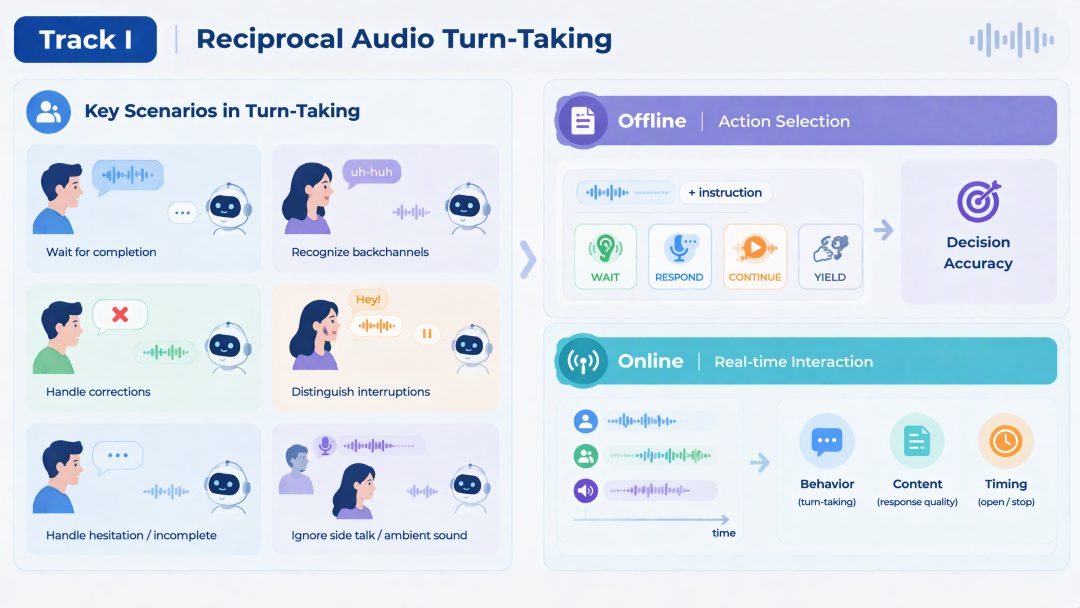
Track I 关注助手在持续对话中何时开口、继续说话或停下。当助手正在倾听时,它需要判断用户是否已经表达完整,还是应该继续等待;当助手正在说话时,它需要区分用户的附和、旁侧人声与真正的打断,并决定继续发言还是及时让出话语权。
该 Track 包含彼此独立的 Offline 与 Online 评测和排名:
Offline:四类交互动作选择。 系统接收对话音频前缀、助手指令和四个候选动作,在指定决策点选择最合适的行为。评测采用 Top-1 Accuracy,错误、缺失或无法解析的结果均计为错误。
Online:实时双工交互。 系统按时间顺序接收用户语音、其他参与者语音和环境声音,并输出音频及带时间戳的 JSON 日志。评测同时关注是否正确开始或停止回应、回复是否满足当前请求,以及实际开口与停下的时间是否合适。
评测场景覆盖请求、澄清、纠正、信息更新、打断,以及暂停、取消和恢复等交互行为;同时加入自然停顿、犹豫、自我修正、未完成表达、附和与旁侧说话等容易误判的情况。
这使 Track I 不再只是预测一句话“结束了没有”,而是在持续变化的对话状态中,评估智能体能否真正参与交流。
Track II:Streaming Proactive Understanding
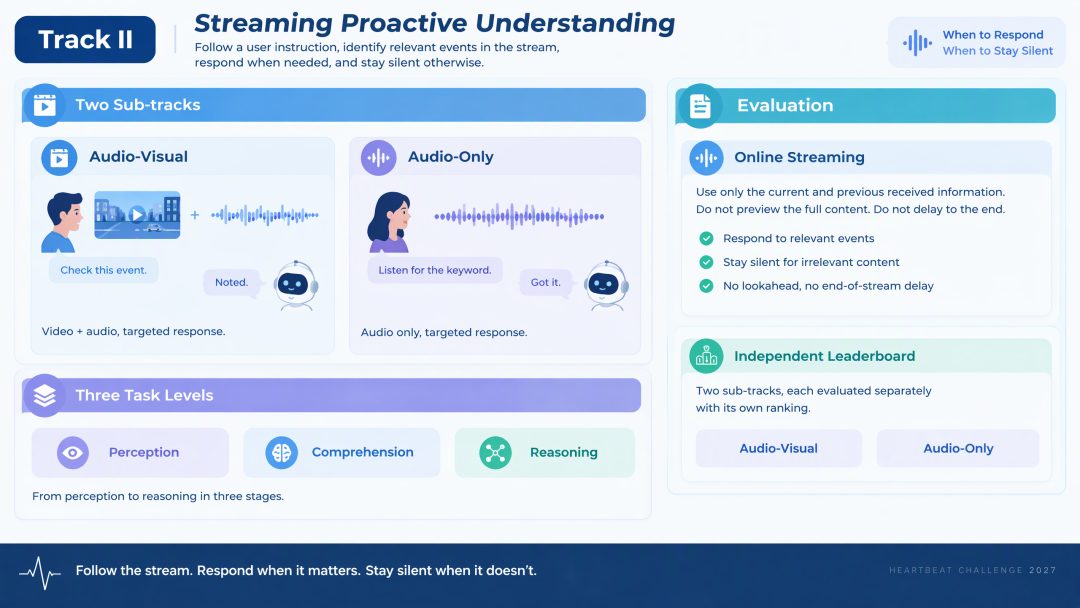
Track II 关注智能体在连续信息流中能否自主判断何时回应、回应什么,并在无需回应时保持沉默。
系统先接收一条用户指令,随后按时间顺序处理持续到来的输入。参赛者可选择:
Audio-Visual 子赛道: 同时处理视频与音频;
Audio-Only 子赛道: 只处理音频。
两个子赛道均采用 Online 流式评测。系统只能使用当前及此前已经收到的信息,不能提前查看完整录制内容,也不能把所有回答推迟到流结束后一次性给出。任务覆盖 Perception、Comprehension、Reasoning 三个层次;系统需要在一段流中识别多个可能的回应时刻,并在没有必要回应时保持沉默。
对于 Track II,每个输入分块都必须留下记录,包括没有输出的分块。一次回答的时间戳由触发该回答的分块结束时间决定,不能事后回填;因此,分块策略本身也会直接影响响应延迟。
如何评测:让回应时机真正影响成绩
一句回答即使内容正确,如果打断了尚未说完的用户,或在关键事件过去后才给出提醒,也难以用于实时交互。HEARTBEAT 因此将“何时行动”纳入评测:Track I 的 Offline 设置考察指定时刻的动作选择;Online 设置同时评价话轮行为、回答质量和开口与停下的时机。Track II 则将回应是否及时、内容是否正确一并计入结果,漏答、误触发和重复回应都会影响成绩。
所有 Online 评测都要求系统按输入到达的顺序作出决定,只能依据当时已收到的信息回应。这让“继续倾听”与“及时开口”都成为可以检验的交互能力。
从公开开发到 ICASSP 2027
根据挑战官网:https://heartbeat-challenge.github.io/当前日程,开发榜单将于 2026 年 11 月 16 日开放,最终提交于 12 月 23 日截止,最终排名及论文邀请将于 12 月 30 日公布。
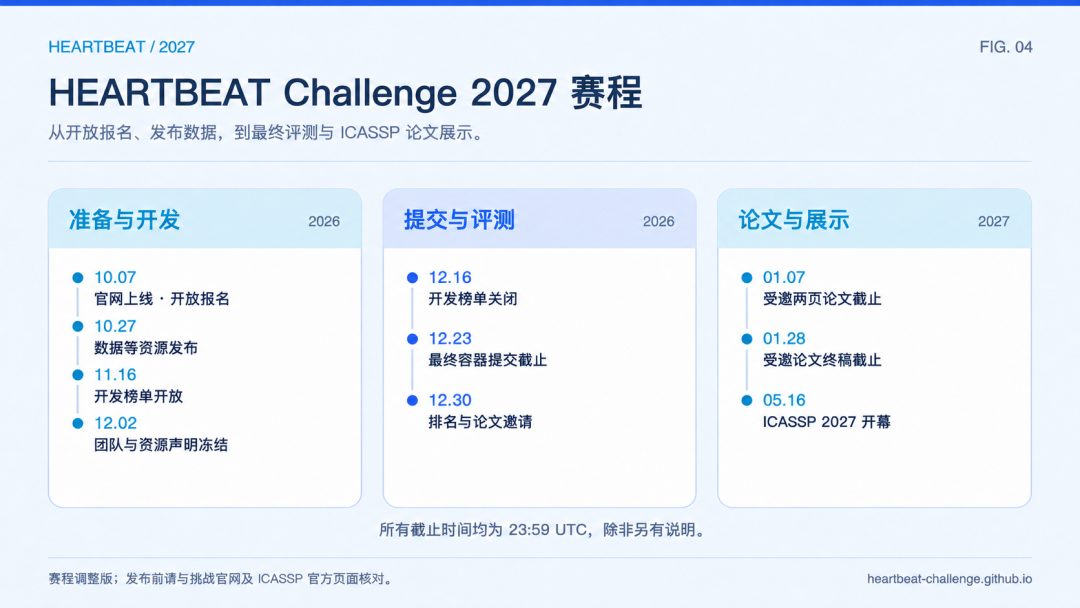
两个 Track 将分别产生优胜团队。经审计的优秀团队中,最多五支将受邀提交两页 ICASSP 论文,并在加拿大多伦多举行的 ICASSP 2027 SPGC 专场进行现场展示。邀请将综合考虑最终排名、技术多样性、可复现性,以及两个 Track 的均衡覆盖。
组织团队
HEARTBEAT Challenge 由来自蚂蚁集团、新加坡国立大学、香港中文大学、电子科技大学、中国科学院计算技术研究所和新加坡科技设计大学等机构的研究人员共同组织,团队覆盖音频研究、基准设计、数据治理、评测基础设施与参赛者支持。组织委员会完整名单见挑战官网:https://heartbeat-challenge.github.io/。
让智能体听见,也让它理解互动的分寸
从实时语音模型到具身智能体,系统接收连续输入并快速生成内容的能力正在提升。下一步的关键,不只是缩短响应延迟,而是让模型知道哪一刻值得回应、怎样回应,以及何时不应打断。
HEARTBEAT 将对话中何时说话、连续信息流中何时主动回应,以及何时保持沉默,放入统一的人本交互问题中,同时通过独立赛道与可复现协议,为不同技术路线提供可比较的研究平台。
报名现已开放。欢迎实时语音、音频语言模型、多模态理解、人机交互与具身智能方向的学术、产业和独立研究团队参加。
数据下载与 baseline 仓库:https://github.com/heartbeat-challenge/HEARTBEAT_challenge_baseline/
ICASSP 2027 SP Grand Challenges:https://2027.ieeeicassp.org/sp-grand-challenges/
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。