从Vibe Coding到Vibe Research:Harness做减法,Human把握关键
原创 Kaibooo 2026-11-11 21:07 北京
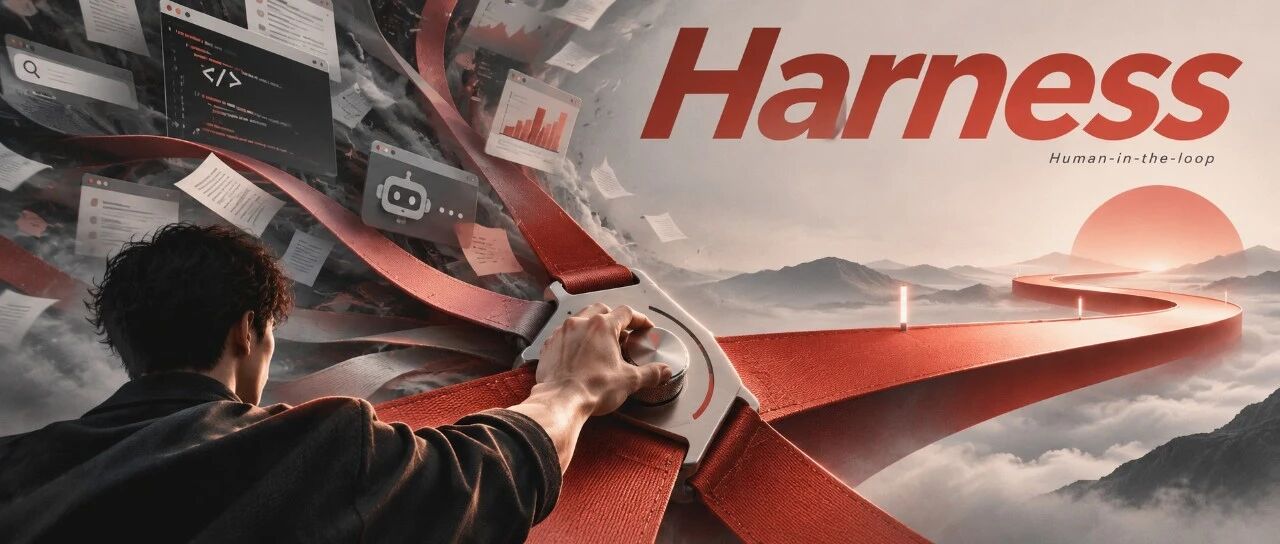
模型越强,规则越少
Prompt 越写越长、Skills 越堆越多,模型就一定越好用吗?
模型能力越强,你所做的越少。
过度复杂的规则和 prompt 只会干扰 SOTA 级别的 LLM:把要做什么、花多少 effort、怎么验证说清楚就够了,human 要做的是在最关键的地方给出正确的引导。
本文整理了我在项目文档管理、effort 选择、测试与 code review、prompt 与 skills、调研与找 idea 上的经验,供大家参考和批判,更希望的是交流。
文中提到的模型:GPT-6 Astra / GPT-6 Astra Pro / GPT-6 Luna / GPT-5.6 Sol / Fable 5.1 / Opus 5.5 / Gemini 4 Argon。
模型迭代太快了,很多结论都是有时效性的,说不定下周就不适用了。
核心观点:harness做减法,human把握关键
最近 Claude Code 的负责人 Boris Cherny 发了一个 demo:让 Opus 5.5 给 Acquired 播客 Home Depot 那一期做了一个互动网站。
不过出乎他意料的是,没人关注生成的内容,真正引发关注的反而是他分享的 prompt,人们的关注点在于:prompt 居然如此简单!?
Boris 原始 prompt(翻译):
最新一期 Acquired 播客关于 Home Depot 的内容非常精彩。
我想让你制作一个能够叙述整集内容的 Artifact。把它做成精美且互动的形式,重点传达贯穿整集的商业智慧精华。一定要做得非常出色,使用大量的 token 并不断迭代,直到你对其感到自豪为止。
也许可以在整个作品中加入水彩插图和历史照片,目标是营造出《纽约客》或《纽约时报》数据可视化的风格,甚至要更好。我认为你可以使用 OpenCV 来处理水彩图片。
要知道,特别是在 23、24 年,prompt engineering 是一个很火的东西,专门的课程、书籍、教程等等数不胜数,但是人们现在突然发现,原来顶尖的 AI 算法研究员也在用如此朴素的 prompt?
Boris 自己的回应:
我很惊讶,大家竟然会对我这样给 Claude 写 prompt 感到惊讶。
像对待同事一样和 Claude 说话。 prompt 没有什么秘诀,大多数任务不需要过度的约束和规定,给 Claude 一个目标,它自己会想办法。
在 Sonnet 3.5 那时候, prompt 很重要。而现在,更重要的是向模型讲清楚:
1. 你想让它做什么。
2. 你希望它花多少 effort。
3. 它应该怎么验证自己做对了。
我非常认同这样的观点。我的理解是:harness 需要做减法,模型能力越强,你所做的越少。
最好不要盲目使用一些热度很高的 skills 之类的东西,不要为了用而用;我的使用体验是,普遍而言,很多噱头大于实用性,过度复杂的规则设计和 prompt 会严重干扰 SOTA 级别的 LLM。
但是为什么同样的 SOTA 模型,在不同人的手里发挥的作用不同?
因为模型会犯错、会短视、会片面以及类似的各种问题,需要 human 在最关键的部分予以正确的引导,这正是 human-in-the-loop 最核心的价值。
回过头再看 Boris 的 prompt,虽然简单,但三件事他都说到了:
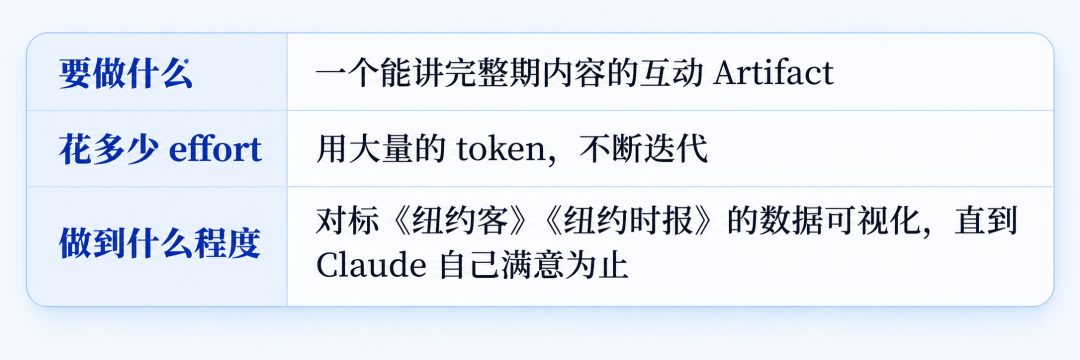
一些评论的观点是:这里面最重要的是第一和第三点,只要讲清楚要做什么、怎么算做好,agent 就能自己去验证、去迭代。
有些评论说得也很直接,也有道理:“你想要什么,解释得多烂都没关系,只要你把它解释出来。”
后面的内容基本也是围绕这三件事展开的:先说清楚要做什么(项目文档管理),再决定花多少力气(effort 的选择),最后是怎么验证(测试和 code review)。
Vibe Coding项目管理浅见
跨会话协作的关键在于文档
LLM 的 context window 是有限的:Codex 默认只支持 258k(可以调到 1M,但官方都不放心设为默认,所以我不认为手动设到 1M 是好的选择),Claude Code 默认为 1M,Gemini 4 Argon 支持 2M(恐怖如斯!没有体验,但我对 Gemini 的 coding 能力不抱期待)。
不管是 258k 还是 1M,对大项目而言都毫无疑问不够;而且 context 用到 50% 以上、甚至 70%—80% 时,丢三落四、犯错是不可避免的,因此让 agent 在多个会话之间协作是至关重要的。
跨会话协作的关键在于做好项目文档维护和管理。
我的习惯是,在一个工作目录下开启与 agent 的对话,正式开始之前,先初始化 AGENTS.md(最最最核心!Claude 现在也支持 AGENTS.md),以及下面这些文件夹:
my-project/
├─ AGENTS.md          # 最最最核心!
├─ docs/              # 核心,存放长期维护的文档
│  ├─ README.md       # docs/ 的索引,简单的说明
│  ├─ HANDOFF.md      # 跨对话长期项目的核心
│  ├─ DATASET.md      # 数据集说明
│  └─ ENV.md          # 环境说明
├─ data/              # 数据集放数据盘,这里建软链接
├─ experiments/       # 实验结果,占空间的话也建软链接
├─ notes/             # 草稿、待定决策、头脑风暴、调研
├─ ref-papers/        # 参考文献的 LaTeX source
├─ ref-repos/         # 代码实现的参考
└─ workspace/         # 真正的开发目录
ref-papers/ 里最好是去 arXiv 获取 LaTeX 源码,保真度最高,就是给 AI 看的。其中最主要的就是 docs/,放的都是长期维护的文档。
在这些文件里,你可以没有其他的,但你不能没有 AGENTS.md!
原则:强烈建议 human-in-the-loop 地创建和维护这些文档!当一个错误 / 问题 Agent 连续犯的时候,就应该把相关说明加到 AGENTS.md 里。
附:我的 AGENTS.md
[] 里换成你自己项目的内容即可,仅供参考(节选)
# Agents Guidelines
本目录用于 [研究方向] 研究(项目名 [xxx]):[一句话说明目标]。接手先读 docs/HANDOFF.md;当前主线草案见 notes/cur_mainline.md。
## 目录与归属
- ref-papers/:参考论文,只读。论文事实以本地原文为准,不凭记忆转述。
- workspace/:代码与实验。上游仓库克隆只用于跑基线,改动保持最小;自己的新代码放独立目录;临时文件放 workspace/tmp/<任务名>/。
- notes/:调研、讨论、未定稿草案。当前有效草案用 cur_ 前缀,过期后移入 notes/archive/。
- docs/:正式文档。HANDOFF.md 为接手入口,ENV.md 为环境,spec/ 为正式方案。
- experiments/<name>/:results.md 首屏维护 Current Summary,运行记录写 runs.md。
## 环境与执行
- 安装、启动、评测、环境排障先查 docs/ENV.md。
- 不要停止非本任务启动的进程。
- 长时程任务确认正常运行后,报告任务标识和日志路径,然后停止轮询。
- 数据传输持续低速或失败时,停止并报告;不反复重试,不自行更换下载源。
## 测试
- 默认不写测试:不补单元测试,跑通一次、看一眼输出即可。
- 复现已发表工作时,以对上论文报告的指标为准。
- 只有改动自己方法的核心代码(训练流程、数据处理、评分)时才专门验证:先列出可能出错的方式,再用缩小版验证,产出 loss 曲线、指标 JSON 等可核查的结果。
## 文档
- 写入前按上面的归属选位置,不新建平行文档。
- HANDOFF 只记当前状态、关键决策、已验证结果、接手须知、明确待办;40–70 行量级;修订而非追加。
- 原则:删掉某句话不影响接手,就删掉。
关于Thinking effort的选择
Codex别用Ultra / Max直接coding
使用 Codex 时,不要用 Ultra / Max 直接去 coding,特别是 Ultra!
Ultra 会生成大量的 subagent 去 debate!造成的结果是无限的挑刺、抬杠,针对大量无意义的边界问题进行测试、打补丁,导致项目臃肿,浪费 token 且腐化 context!
本质还是 GPT 本身的问题:过度防御性,经常过度谨慎。
主代理启用 subagents 去处理任务,本质是为了减轻主代理的负担、隔离上下文、协作完成任务,但是 GPT 的主代理经常会不信任子代理,简直就是反驳型人格。
子代理都跟他说已经完成了,主代理非得再去 double check 一下,这操作既浪费 token 又污染上下文!Claude Code 的 Ultracode 功能甩 Codex 一万条街!
Max 同理。建议将规划与执行解耦:规划可用较高 effort,执行用相对低的 effort。
注意:这里的解耦和使用不同 effort,指的是开多个会话并行处理任务,不是在一个对话中不停切换模型或思考预算。这样会破坏 KV cache(prompt cache),让你的对话更贵、更耗钱。
thinking effort 可以理解为 system prompt 的一部分,切换后之前的 cache 都要丢掉重新计算;切换模型同理。
例外:Claude 最新的模型(Fable 5.1 和 Opus 5.5)已经可以做到改变 effort 而不破坏 Claude Code 的提示缓存,对话中途也能直接用 /effort 切换(也许后续 Codex 也会跟进,但目前还没有)。
Anthropic研究员的370次实验
你以为 thinking effort 越高模型越聪明?Low 真的要比 High 笨很多吗?实际并不完全是。
Anthropic研究员 Thariq 用 Fable 5.1 在 Terminal-Bench 3.0 上跑了 370 次,从 low 到 max:
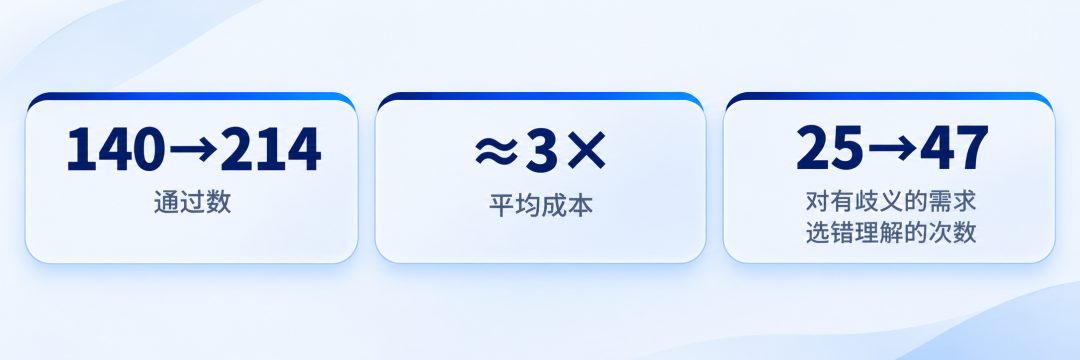
从宏观上讲,effort 让模型能大致了解你希望它为该任务花费多少计算资源。这在某种程度上与你对任务难度的建模有关。
我的理解是,effort 本质就是 prompt,它不会从根本上提高模型的智力水平,只会让模型花更多功夫去想、去验证。
对边界情况多的任务(老代码修 bug、安全、性能优化)很值,但简单的问题过度思考就会过度解读,就像做阅读理解一样。所以 effort 应该与任务难度(以及你想多大程度参与其中)相匹配。
Thariq 的经验法则:
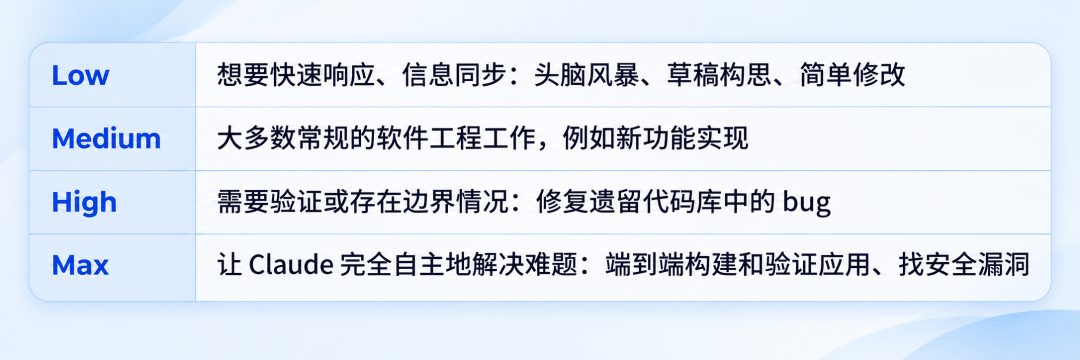
他写新功能的流程(多了一步高 effort 验证):
1. 先给 Claude 一份 spec,让它反过来问你,把缺的细节问清楚;
2. 用 low 实现;
3. 自己检查方向对不对,不对就继续用 low 改;
4. 最后切 high 做验证和测试。
烦人的单元测试 & 停不下来的code review
目前 SOTA 的 LLM 莫名其妙地喜欢各种测试(从 GPT-5.6 Sol 开始!真不知道哪学来的坏毛病),它可能写几千行的代码来做一些根本没意义的测试,这只会导致代码极度臃肿并浪费大量 token。这是社区的共识性问题。
OpenAI 的官方文档其实也解释了一部分原因:以前的模型需要督促才会去跑测试,而 GPT-6 Astra 自己就会做,如果 AGENTS.md 或 prompt 里还留着“记得跑测试”之类的旧指令,就会导致大量不必要的测试。
所以可以先回头检查一下自己的 AGENTS.md 里有没有这类旧指令(但是实际你就算不写,他也会大量写测试)。
一位开发者放在 AGENTS.md 最顶部的三条:
1. 永远不要在写完代码之后再补单元测试。
2. 强烈倾向于把端到端(E2E)测试作为唯一的测试手段;E2E测试结束时,要产出一个可验证、可复现的产物(artifact)。
3. 如果确实需要单独测试某个模块,先把它所有可能出错的方式写下来,再写代码。
我的理解是,LLM 喜欢静态单元测试,写一部分就测一部分,而不是测整个系统,这对 research 而言很多时候毫无帮助,端到端的测试可能更适合我们的场景。
我自己的写法见前面 AGENTS.md 的“测试”一节。
停不下来的code review
让 LLM 去做 code review,最大的问题不是它发现不了问题,而是它总能找出一堆问题,但很多并不是真的问题:它不知道什么时候该停,它只是在迎合你的提问。
尤其是你可能对你的代码一无所知(很多时候我确实是,我会尽量强迫自己去看一眼代码)。
一个干净的 context、简洁且约束完整的 prompt,再加上事先写清楚完成标准,或者对系统顶层架构有深入理解,也许有帮助。
不只是在 code review 时这样,论文审稿也一样,所以 best paper 也可能被贬得一文不值。
Prompt与Skills
我建议不要太依赖 GPT 写的 prompt。GPT(每个模型都有,但 GPT 尤甚)自己写的 prompt 无敌繁琐,各种约束,会让模型陷入局部最优,而且可读性很差,又臭又长。
可以让它写的时候加一些要求,比如:
我认为这种 harness 应该做减法,也就是不给太多复杂的约束,因为模型能力够强,约束过多只会对模型造成干扰。
总之要有自己的判断,vibe 的每个阶段、每个步骤,都应该 human-in-the-loop。
也可以直接把 OpenAI 的官方文档《Rethinking skills and prompts for GPT-6 Astra》发给它,我觉得最值得记住的几点:
Skill 描述要短,写清楚什么时候用:太长会被 Codex 截断,模型更难选对。
渐进式披露:根文档只指向子文档和脚本,用到时再读。
不要写成很细的流程清单:过于具体的指导现在反而会拖后腿。
定期检查 AGENTS.md 每一条是否还需要:“每次编辑前先读 xxx.md”改成“改 schema 时看 database.md”。
事先写清楚完成标准:以前的强约束可能被过度当真,在你希望它继续的地方停下来。
Skills分享
推荐Research-Paper-Writing-Skills(GitHub:Master-cai),很简洁。好的 skills 就应该这样简洁,很多就像随手写的 prompt 一样,但效果很不错。
比如之前很火的 grill-me,但 grill-me 对我来说效果就那样:有时问得太细,反而钻牛角尖;而且我对项目架构没有清晰规划时,它 grill 我,我也不知道怎么回答哈哈。
几十 K stars 的全自动科研 skills 我也试过不少,太冗余了,完全是干扰项,产出的 idea 和写作质量都很一般。
Research:调研、找idea
不要太依赖 LLM 直接输出的 idea;LLM 缺乏 research 的 taste,需要强 human-in-the-loop!
用Pro做调研
Web 端独有的 Pro 模型很强,特别是 GPT-6 Astra Pro,但是最好不要指望它去写代码。
Web 端缺乏相应的 harness,Codex + 较弱的模型产出的代码质量一定是强于 Web 端 + Pro 模型的。
Pro 很适合做调研,但它会钻牛角尖,要多调整 prompt,以及自己用关键词检索一下;我发现它反反复复就搜到那几篇 paper,漏掉不少其他 paper。
我的找idea流程
1. 用 Pro 做几轮(两轮、三轮很足够了)独立调研,对输出的内容简单整理,放到 Project source 里。
2. 去精读一些 paper,最终选择两三篇你认为最可以做、可以结合的 paper。这里需要靠你的 taste、你的直觉,这是最关键的一步。
3. 把这几篇 paper 和之前的调研一起放进 Project source,进行最终轮问答(不满意就继续迭代),讲讲你对这几篇 paper 的理解和吸引你的点。
别轻信GPT的novelty判断
让 GPT 判断你的 idea 有没有 novelty 时,它经常会 search 一堆 paper,只读摘要,不读具体的方法、贡献,就得出结论:“paper A 已经这样做了、paper B 已经那样做了……因此只是这样并不足够……”最终你得到一个毫无价值的结论,还陷入自我怀疑。
然而你自己读了 paper 之后可能会发现,这些论文和 GPT 说的根本不是一回事!所以一定要 human-in-the-loop。
Research:Benchmark工作
我认为一个好的 benchmark 需要回答下面两个层面的问题,可以直接拿来问 GPT:当前构思的方案是否足够好地回答了这些问题?
层面一:三个顶层追问
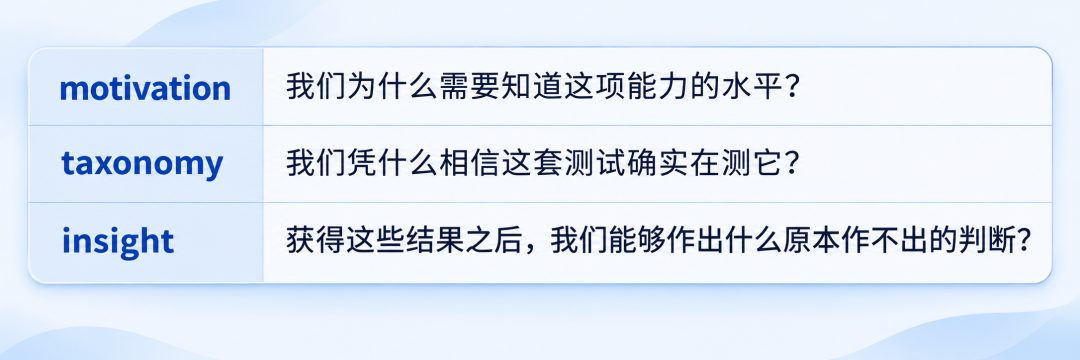
层面二:研究组织层面的六问
主线与边界:整项工作围绕哪个核心问题展开,各个任务为什么属于同一项研究,哪些问题明确不在范围内?
Taxonomy:问题空间按什么依据拆分,这些分类是否区分了有意义的能力或困难,并真正指导数据覆盖与结果分析?
任务与设计:抽象能力如何落实为明确的输入、输出、成功条件和数据约束,每个关键设计为什么必要?
验证与诊断:实验是否不仅比较模型,还检验 benchmark 本身,并帮助区分能力不足与数据、接口或评分造成的问题?
Insight 与贡献:结果揭示了什么有证据支持的能力边界或失败规律,而不只是模型排名和“当前模型还不够好”?
复用与延续:别人能否独立运行、核查并持续使用这套评价,让后续研究能够在共同标准下积累进展?
读paper的tips & 杂谈
我现在喜欢把 paper 翻译成中文去看。我曾经也觉得这样很 low、不专业,也想锻炼英语,所以一直坚持读英文。
但后来发现太浪费时间了,特别是快速读大量 paper 时,效率低,还读了后面忘前面,所以我决定将读 paper 和学英语解耦。
做法是让 Codex(GPT-6 Luna Medium 绰绰有余)拉 arXiv 的 LaTeX 源码,逐句意译后重新编译出中文版 pdf(可以拆给多个子代理并行翻译)。
翻译质量很好,排版清晰;不想让“token”被翻成“词元”,改一下 prompt 就行。
杂谈:
Codex 的 Fast 模式多耗约 2—2.5 倍 token,只快 1.2—1.5 倍,衡量一下值不值。
用好 ChatGPT Web 端的 Project 功能。不满意就重开对话或建分支(branch),别追问“xxx 是不是更好?”,不然你会收到“你说得对!”。
Codex 的 Side chat 真的是最好用的功能(等价于 Claude Code 的 /btw)。
LLM leaderboard 推荐 Artificial Analysis,较权威。
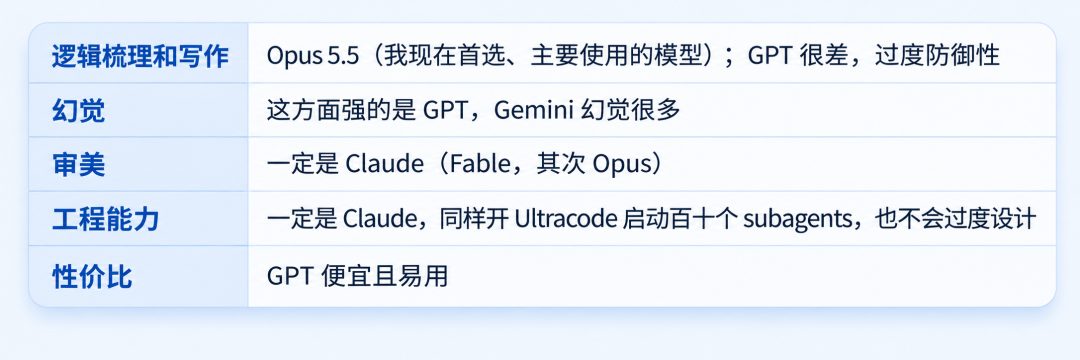
各家模型擅长什么(纯个人体验):
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。