近70年经典算法大升级!Meta改写K-Means,聚类提速45倍
原创 让你更懂AI的 2026-11-13 20:34 北京
小批量为何能赢全量?
用了近 70 年的 K-Means,Meta 从中心更新规则入手,把训练轮次压到了约十分之一。
K-Means 大概是机器学习里最广为人知的算法之一。
从上世纪 50 年代的经典求解方法,到今天的向量数据库、图像检索和数据压缩,K-Means 已经被用了近 70 年。
几十年来,计算硬件不断升级,但经典 Lloyd 算法仍需要反复扫描整个数据集,才能让聚类中心逐渐收敛。
Meta FAIR 最近推出了 e-means,重新设计了经典 K-Means 的中心更新方式。
新算法平均只需两轮左右,就能超过传统 K-Means 运行 25 轮的聚类效果,GPU 最高提速 45.5 倍。
在 100 亿条向量、约 1677 万个聚类中心的实验中,e-means 只用 2.5 轮就取得了更低的误差。
它借用了深度学习中常见的指数移动平均和余弦退火,还通过 Scaling Laws 自动确定训练参数。相关代码已进入 Faiss 开源仓库。
论文标题:
e-means: outperforming k-means (in one-tenth the epochs)
论文地址:
https://arxiv.org/abs/2611.09501
代码地址:
https://github.com/facebookresearch/faiss/tree/main/contrib/e_means
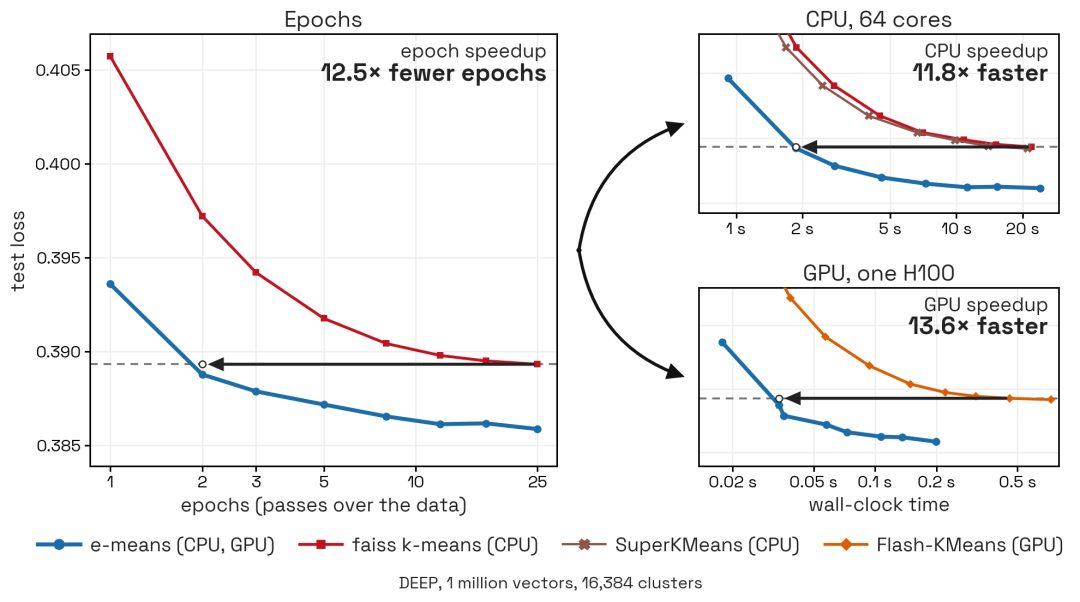
〓 图1. 百万向量实验中的训练轮次与CPU、GPU耗时对比
K-Means为何还要扫25轮?
K-Means 将一组数据划分为 k 个簇,目标是尽可能减小样本到所属聚类中心的平方距离之和。这个目标沿用至今,求解方法却仍有很大的优化空间。
最常见的 Lloyd 算法,会先把所有样本分配给最近的中心,再用每个簇的样本均值重新计算中心。完成一轮更新,必须遍历一遍数据。
论文以 Faiss 常用的 25 轮配置作为比较基准,百亿级向量上的重复计算尤其昂贵。
小批量 K-Means 早在 1967 年就已经出现。它每处理一部分样本就更新中心,无须等待整轮扫描结束。
但经典的小批量更新会持续累加历史统计量,早期中心位置尚不准确时形成的分配记录,也会长期影响后续结果。
此类方法通常收敛得更快,最终误差却高于充分训练的 Lloyd 算法。批次大小与学习率还需要额外调节。长期以来,聚类训练很难同时兼顾速度、质量与使用门槛。
为什么两轮反而能更准?
e-means 采用指数移动平均(EMA)更新聚类中心。
每处理一个小批次,它就统计各簇接收到的样本数量与向量之和,分别进行移动平均,再用两者的比值计算中心。新的分配能及时修正中心,较早的统计记录则逐渐失去影响力。
EMA 此前已用于向量量化模型的码本更新。Meta 团队发现,将它用于固定数据集的 K-Means,并配合合适的优化策略,同样十分有效。
团队还比较了 EMA 与随机梯度下降的表现。大批次训练中,梯度下降在较大更新步长下容易变得不稳定。
作者认为,EMA 更新能让聚类中心保持在已分配样本构成的凸包内,从而降低大步长更新带来的不稳定性。
小批量更新还改变了算法陷入局部最优的概率。
Lloyd 算法每次更新都会降低当前训练误差,却也可能早早停在不理想的分组方式里。小批量更新带来的随机波动,让 e-means 有机会重新调整这些已经稳定下来的中心。
一组实验将数据分成大小悬殊的两团,要求划分为 8 个簇。Lloyd 有时会给较小的一团分配两个中心,让较大的一团分配不足。e-means 即使从相同状态出发,也有机会恢复合理的中心分布。
在 200 次随机初始化中,Lloyd 有 26% 的运行停留在这种状态,e-means 只有 3.5%。
另一组沿直线排列的五团数据实验中,两者陷入不理想分组的比例分别为 46% 和 0%。
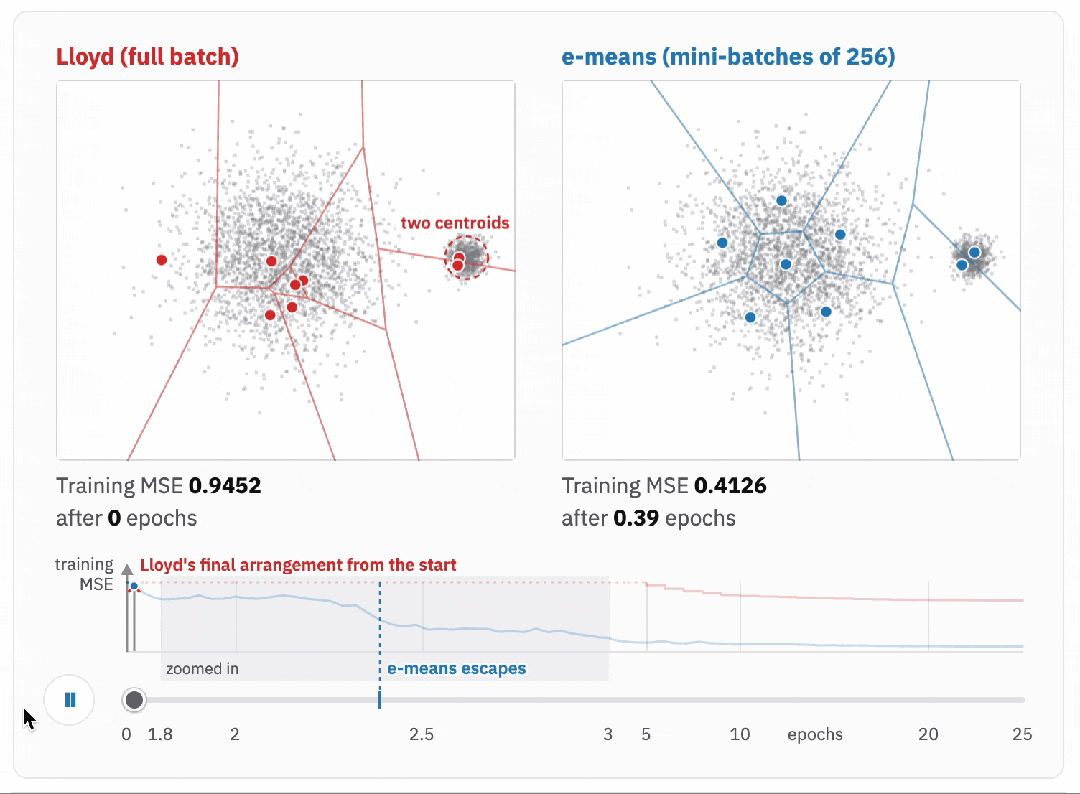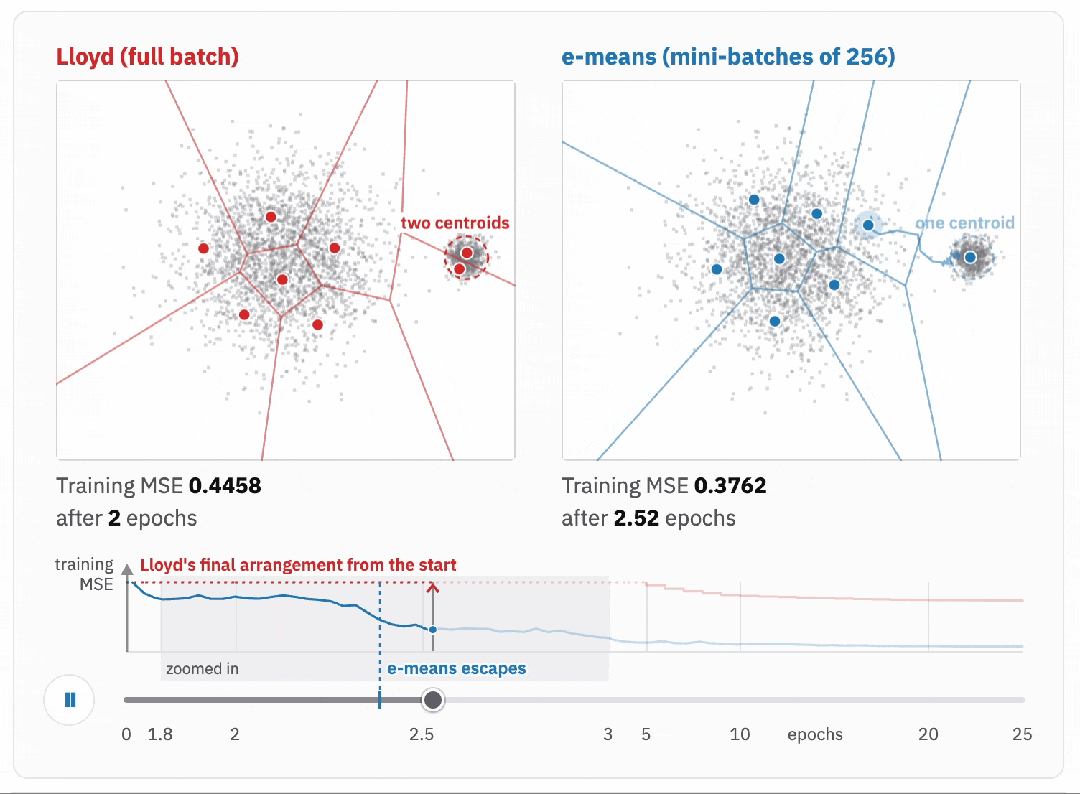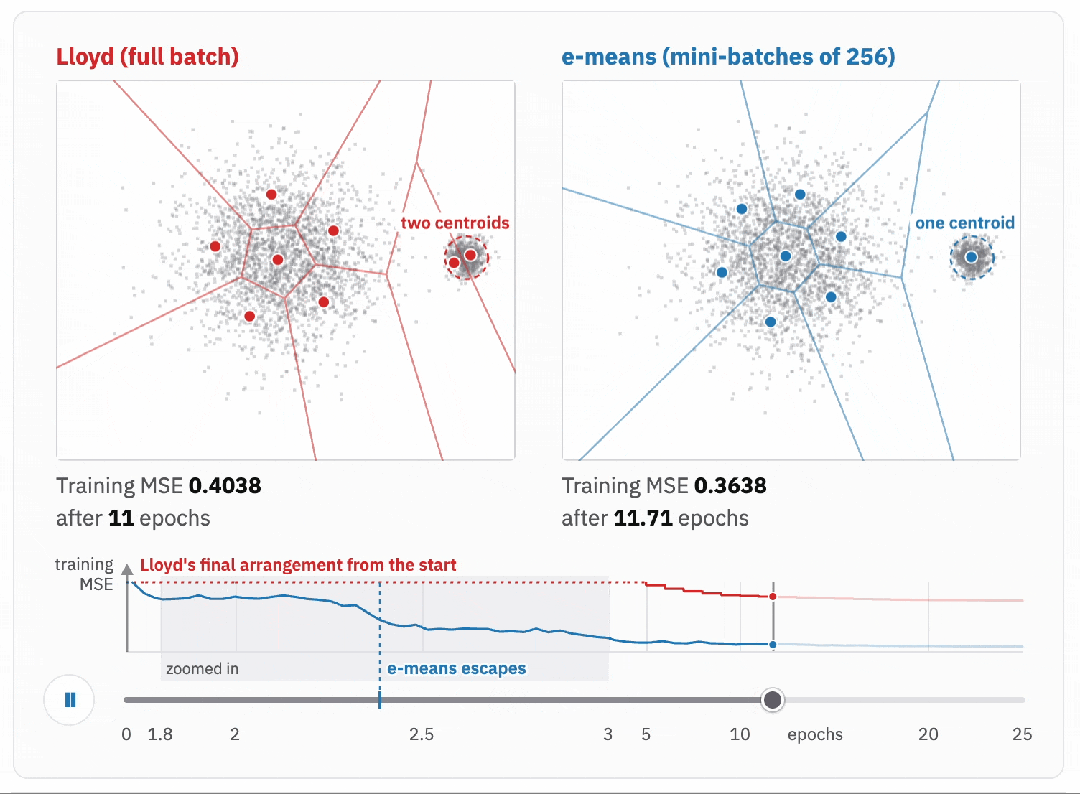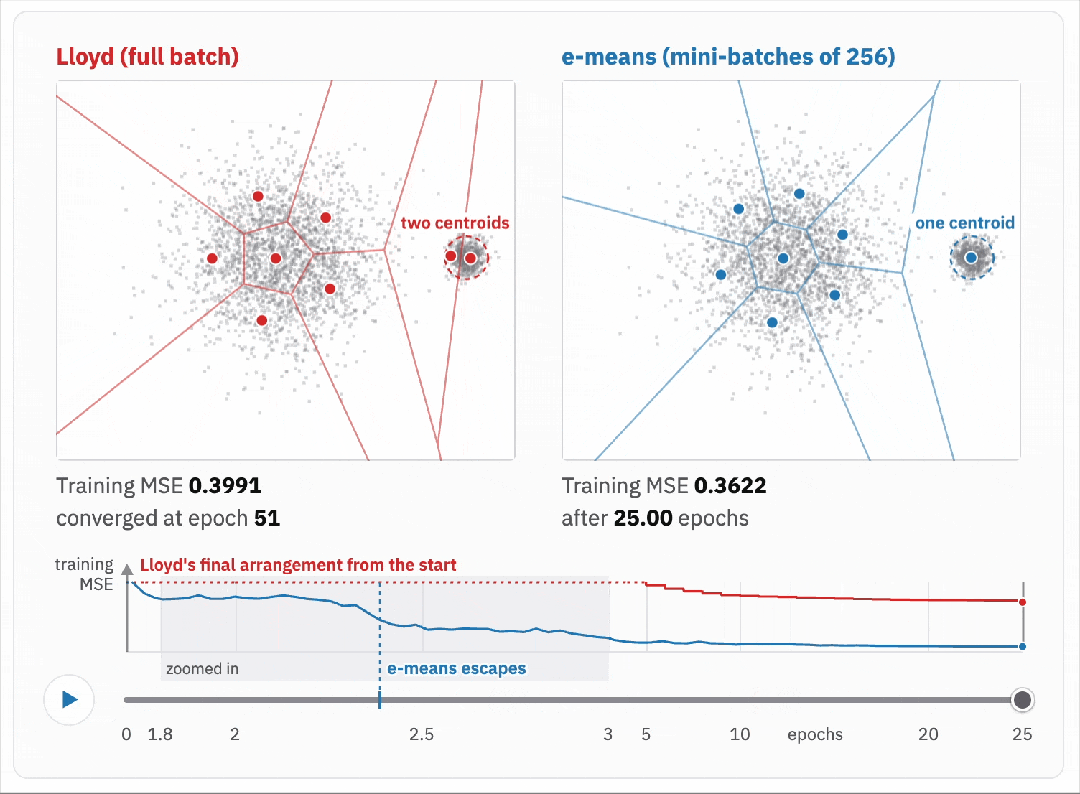
〓 图2. 小批量更新帮助聚类中心摆脱局部最优
另一个关键设计是死亡簇复活机制。部分聚类中心在训练中逐渐得不到样本,原本分配给它们的聚类容量便被浪费。
e-means 每五个批次检查一次,对样本数过少的中心,从较大的有效簇中拆分出新中心,而非简单随机抽取一个样本补位。
在 DEEP 数据集上,关闭复活机制后,最终分配到少于 10 个样本的聚类中心占 26.3%。
使用拆分策略后,这一比例降至 0.3%。在另一组 3 轮训练的消融实验中,不使用复活机制,测试集均方误差还会上升约 2.24%。
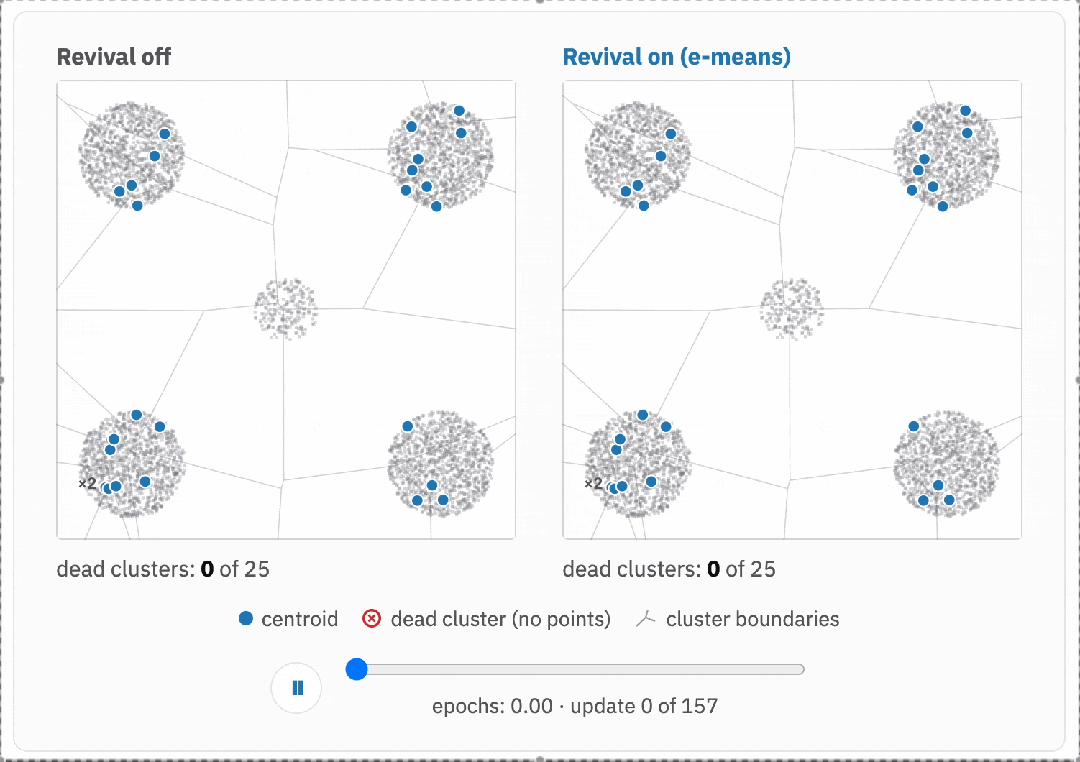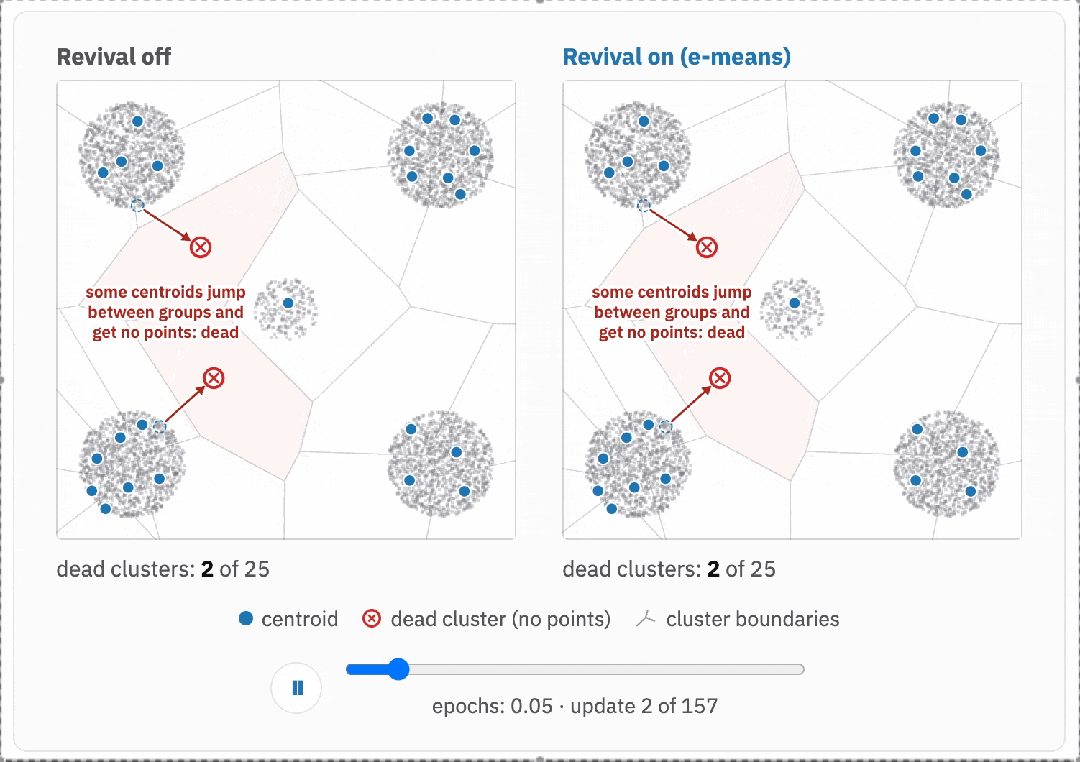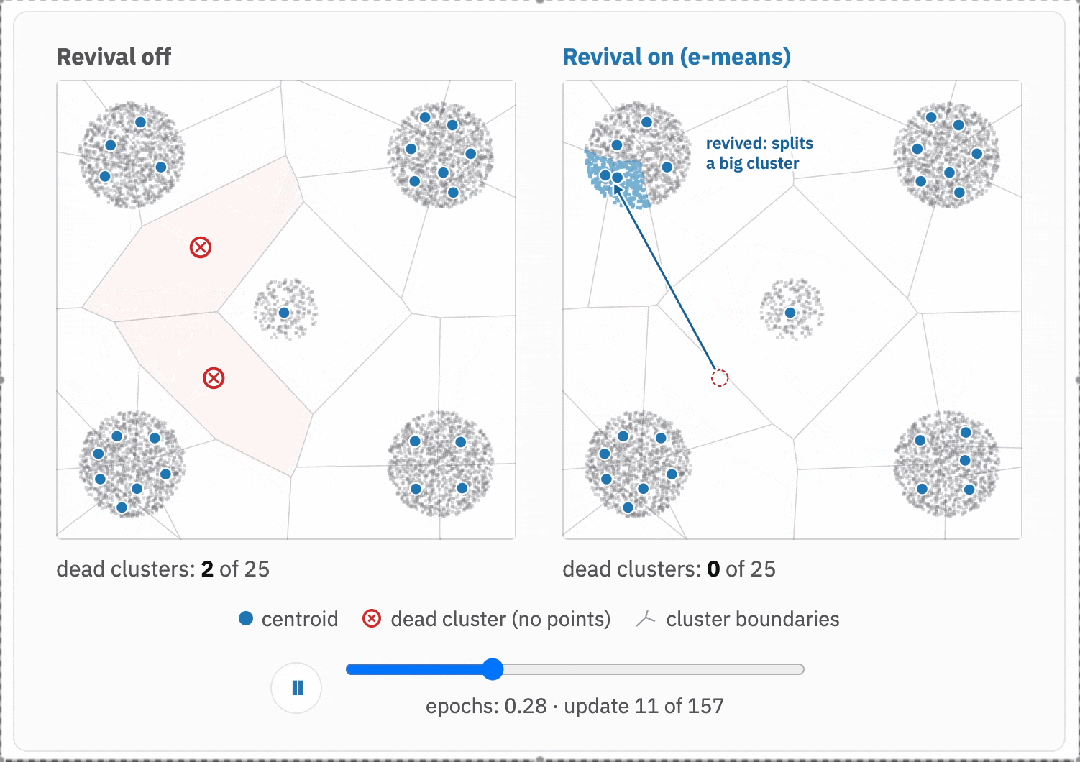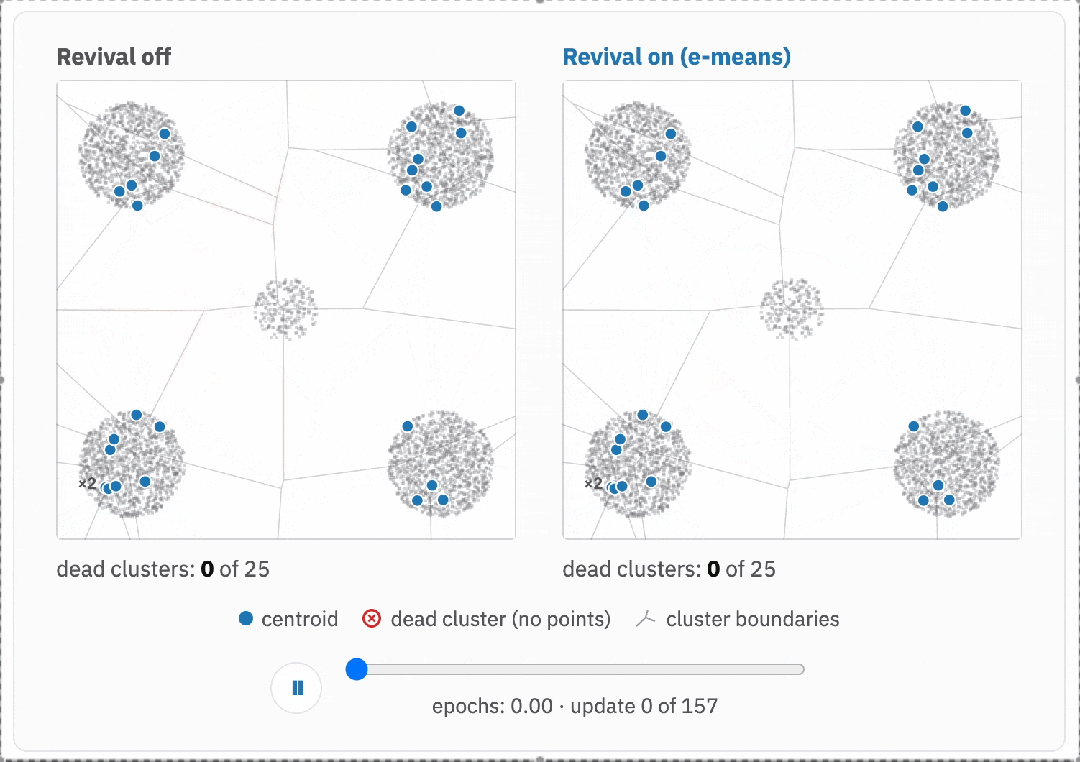
〓 图3. 拆分有效簇,让闲置的聚类中心重新参与训练
此外,e-means 从数据中随机选取初始中心,并让初始统计量只保留极小权重。余弦退火则逐渐减小更新步长,避免训练后期反复波动。
最后一轮结束后,还可以直接用该轮分配的样本均值重新计算中心,以很小的额外成本降低训练误差。面向新数据时,也可选用更慢的移动平均来改善测试误差。
Scaling Laws连调参也省了
小批量训练的速度与精度,都离不开批次大小和更新步长。
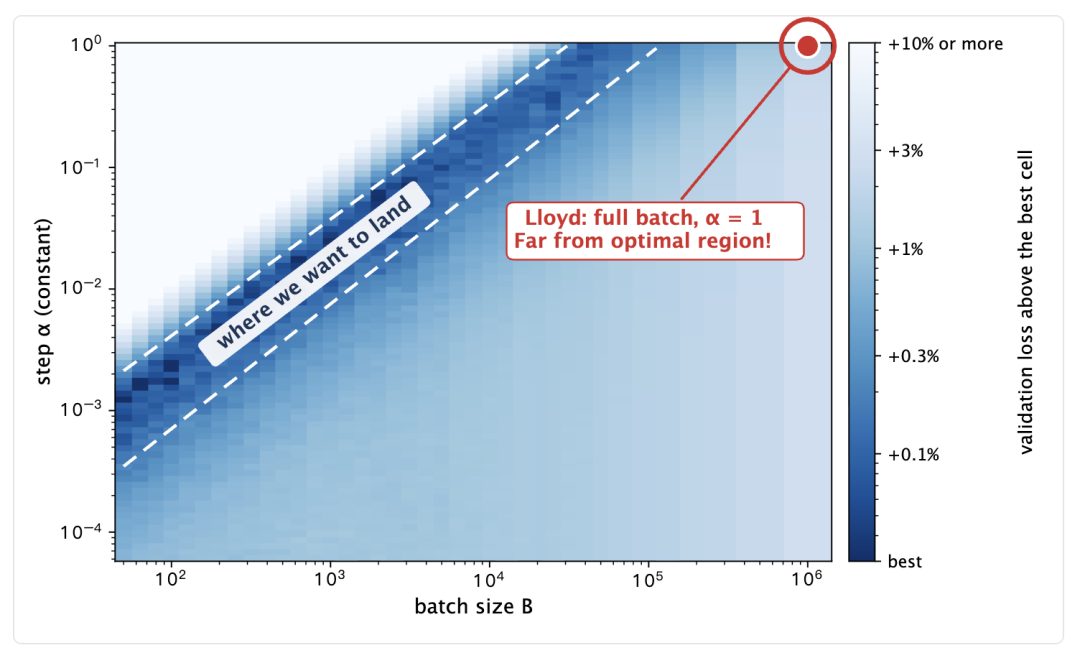
批次太小,GPU 不容易充分发挥吞吐能力。批次太大,中心更新次数减少。步长过小可能训练不足,过大又容易引起波动。
如果每批处理全部样本,并将更新步长设为 1,移动平均的更新就退化为 Lloyd 式的全量重算。但在不同批次和步长的误差热力图上,这组经典配置位于表现较差的一角,较低误差主要集中在另一片参数区域。
〓 图4. 批次大小和更新步长共同影响聚类误差
作者进行了约 7.5 万次优化实验,研究样本规模、聚类中心数量、训练轮次与最佳参数之间的关系,最终拟合出两条 Scaling Laws,自动选择批次大小与初始更新步长。
这些规律主要从 DEEP 数据集拟合,却能迁移到 SIFT、SPACEV 和文本向量数据集。在留出数据集上,默认批次规律相较最佳参数的中位误差增幅仅约 0.19%。
开发者只需给出数据规模、聚类数量和训练轮次,便能使用算法自动确定的参数配置,无须为每个新数据集单独搜索。
这套方法同时提供兼顾吞吐和偏重质量的批次选择,可根据实际需求调整计算效率与聚类质量之间的取舍。
从百万到百亿,GPU提速45倍
在图像、文本等多种嵌入向量数据集上,e-means 与 Faiss、Flash-KMeans 及已有小批量聚类方法进行了对照。
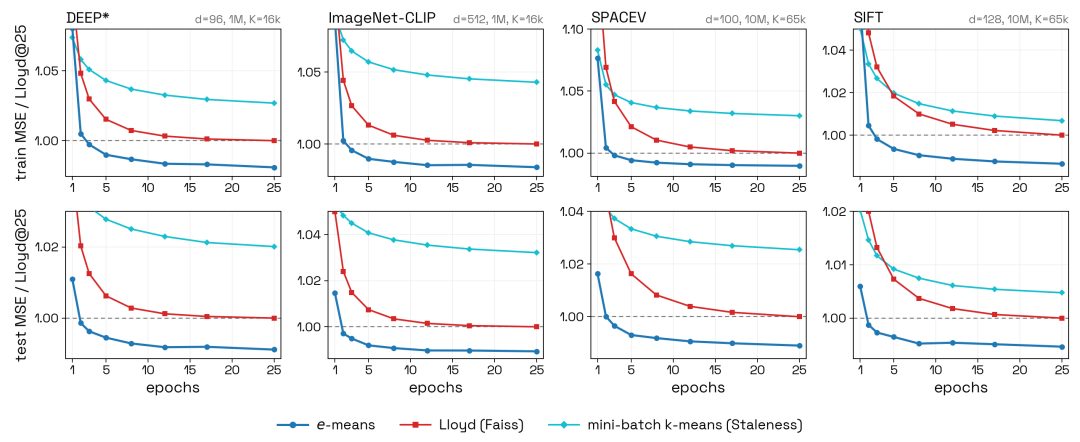
〓 图5. 四组数据上的训练与测试误差变化
这里使用的是均方误差(MSE),衡量样本到最近聚类中心的平均平方距离。数值越低,说明聚类的整体平方距离误差越小。
以 Flash-KMeans 运行 25 轮后的测试误差为目标,e-means 在主要 GPU 对比中只需 1.4 至 2.6 轮,实际耗时缩短约 9.5 至 45.5 倍。
最高的 45.5 倍,出现在 10 亿条 DINO 向量的实验中。CPU 实验也取得了约 8 至 15 倍的提速。
更少的训练轮次之所以能够转化为实际耗时优势,还得益于专门优化的 GPU 核函数。作者将距离计算与最近中心选择融合处理,避免存储完整、规模巨大的距离矩阵,提高了硬件执行效率。
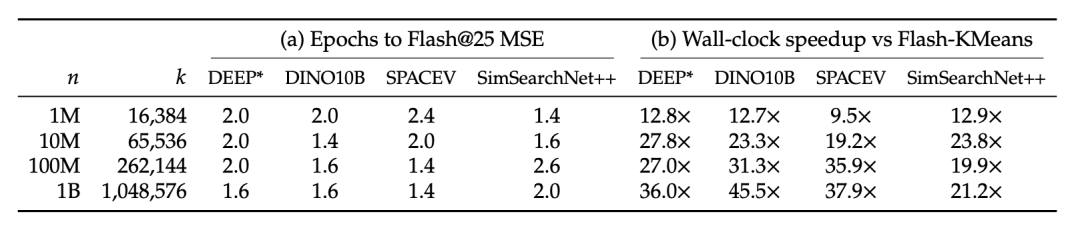
〓 表1. 各规模下达到基准误差所需的轮次与实际加速
团队把聚类规模继续推至 100 亿条向量、约 1677 万个簇。
为开展这项实验,他们从约 6000 万张图片中提取 DINOv3 图像块特征,构成 1024 维、总体积约 10TB 的 DINO10B 数据集。
使用精确最近中心分配,传统 Lloyd 算法运行 25 轮消耗 6784 GPU 小时,e-means 只运行 2.5 轮,消耗 779 GPU 小时,测试误差就降到了更低的水平。
研究团队还探索了通过倒排文件索引(IVF)加速中心分配。每条向量先搜索少量候选区域,无须逐一计算与全部中心的距离。
采用这一近似分配方案,e-means 运行 3 轮便达到相应的测试误差目标,计算量降至约 23.2 GPU 小时。使用单台 8 卡 H100 服务器,实际耗时约 3 小时。
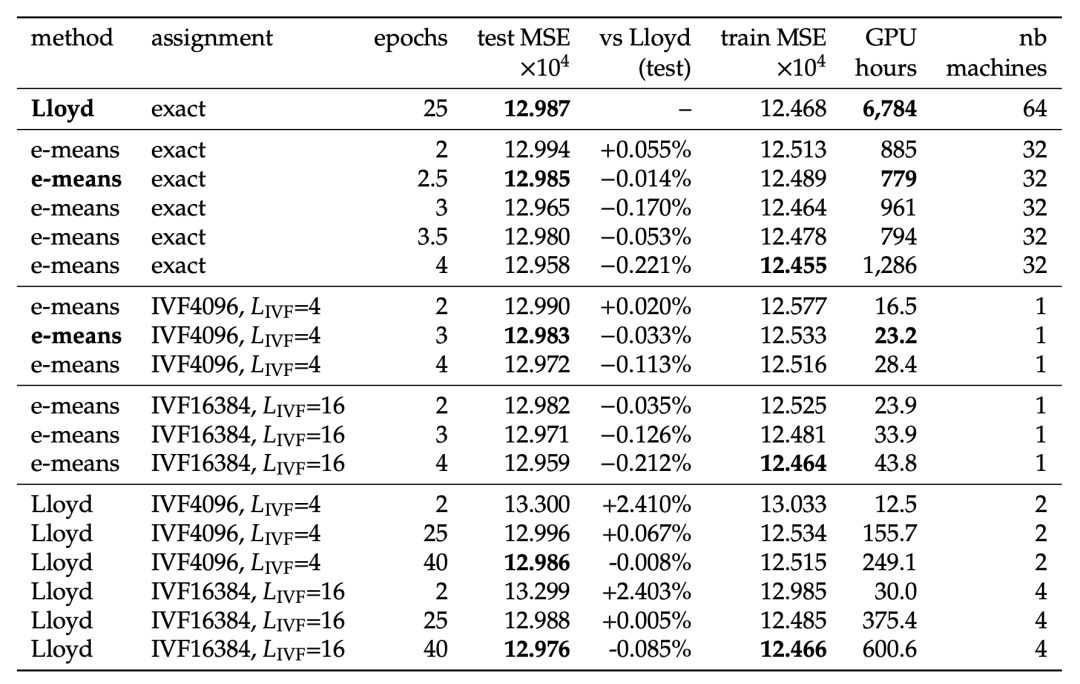
〓 表2. 百亿向量任务的精确分配与近似分配实验
从聚类提速到向量检索
e-means 已被纳入 Faiss 源码仓库,提供 faiss.contrib.e_means 模块及相应的实验复现代码。
目前尚未包含在 Faiss 正式发行版中,开发者可以从源码使用这一实现,并按照公开的实验配置进行测试。
对于需要经常更新向量索引的系统,聚类训练耗时的下降,意味着这一步可以用更少的计算资源完成。
团队还把新的聚类中心用于倒排索引,在 11 组向量数据上,以 1% 的扫描比例比较了最近邻检索的 Recall@10。
相同索引训练时间下,e-means 通常能获得更高召回率。达到传统算法充分训练后的召回水平,所需时间也明显更短。在大多数数据集上,其最终召回率与传统方法相当或更好。
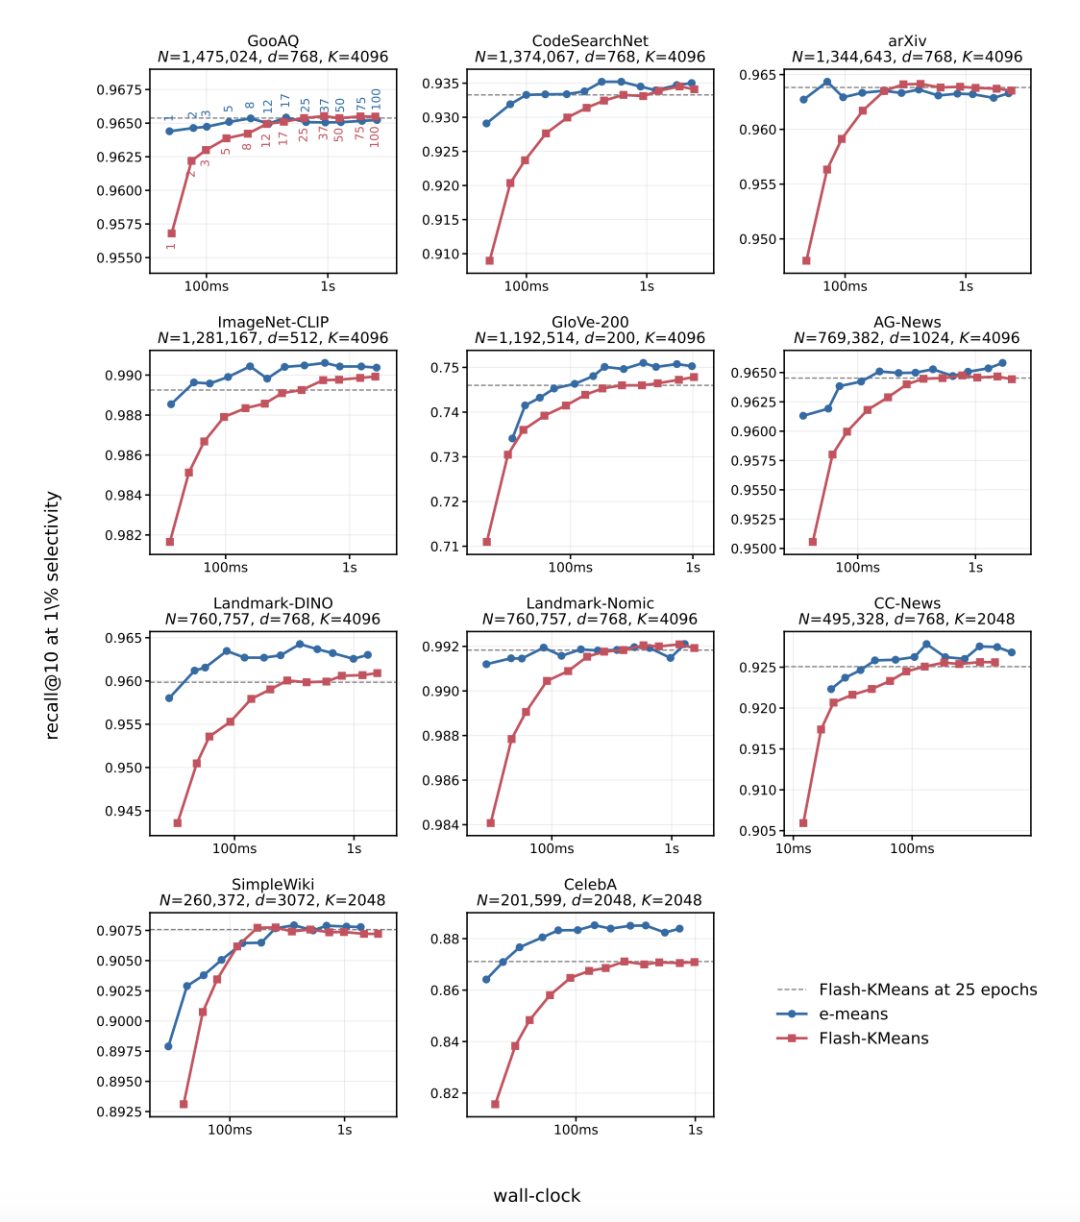
〓 图6. 不同索引训练时间下的近邻检索召回率
从更少的聚类训练轮次,到更低的索引训练成本,再到实际检索中的召回表现,e-means 已经展示出一条比较完整的性能改进路径。
对于使用 Faiss 处理大规模向量数据的开发者,经典 K-Means 如今多了一个经过百亿规模验证、可以直接评估的高效替代方案。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。