首次Agentic RL开课了!十一月最丰富组队学习来了🥳(多达21个课程)
原创 一起学习的 2026-11-12 23:56 浙江
Datawhale学习 开源贡献:Datawhale团队
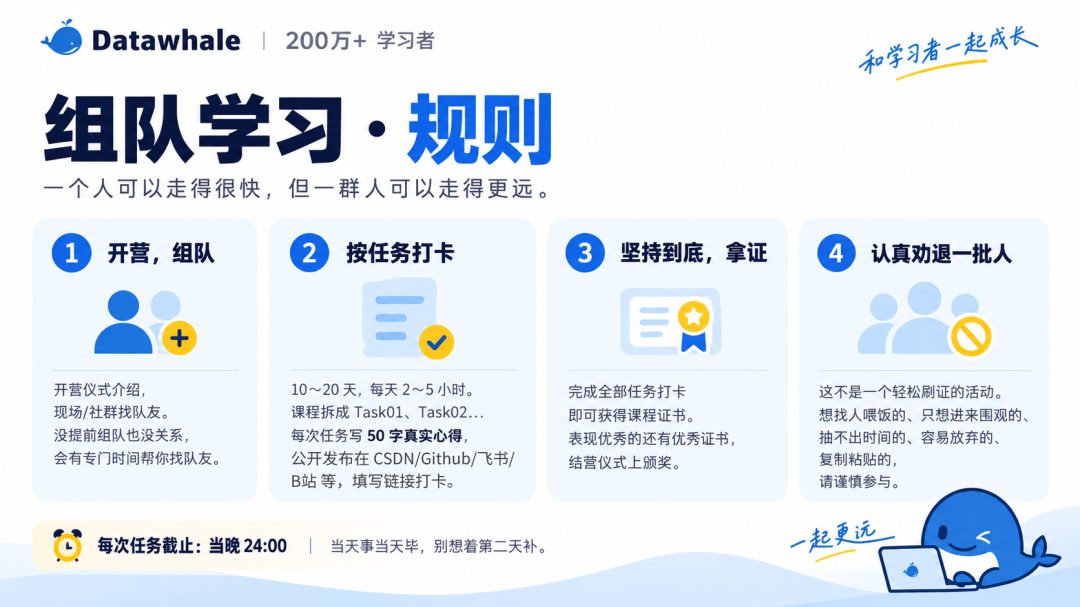
什么是组队学习
组队学习活动,于2018年8月2日由Datawhale发起,已经坚持组织了八年。
初衷很简单,就是一群志同道合的小伙伴,一起学习讨论,一起克服拖延,一起组队打Boss。没有老师,没有教学,有的是一群热爱学习、渴望改变的人,大家交流学习,互促共进。
往期:《李沐大神分享,全球733所高校,9027人共同学习》
本期学习内容
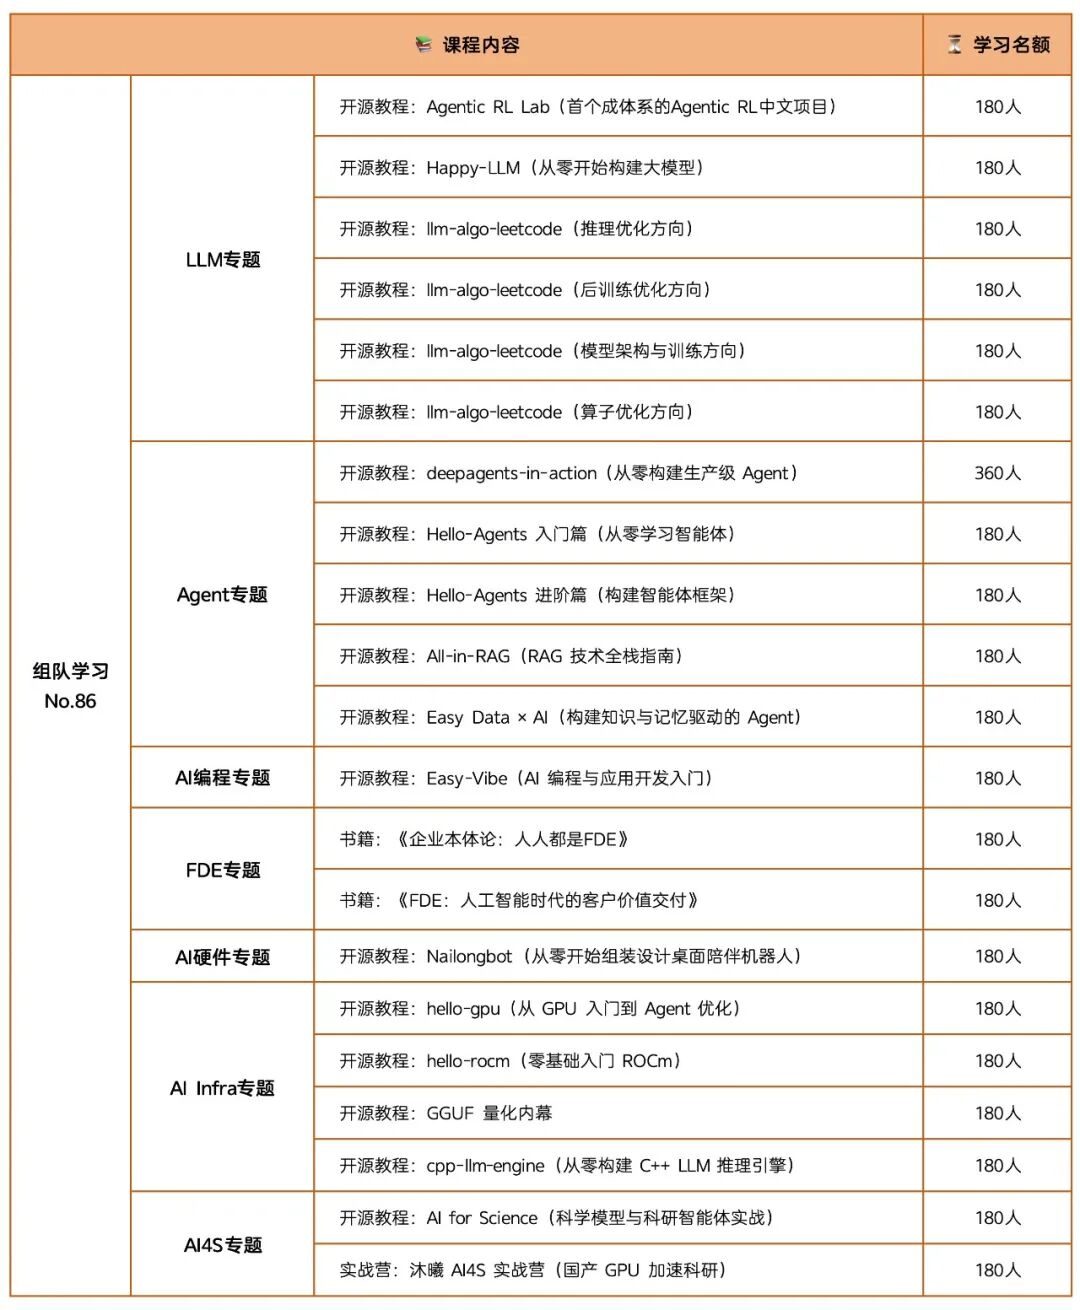
名额有限,先到先得!各学习时间重叠,每人限报 1 门。
报名成功后,会收到进群码,请务必本周内扫码加入学习小群,逾期无法进入。
一、LLM专题
1. 开源教程:Agentic RL Lab(首个成体系的Agentic RL中文项目)
课程简介 围绕 GRPO 与 On-policy Distillation(OPD)两个实验,通过两周的原理学习、代码阅读和小规模训练,理解大模型强化学习(LLM RL)与在线策略蒸馏(OPD)的基本流程,使用 PyTRIO 完成训练并分析实验日志。另设 Search-R1(Agentic RL)选修内容,了解多轮搜索与工具调用的训练方式。 适合人群:有 Python 基础、了解大模型基本概念,希望动手入门大模型强化学习与 Agentic RL 的同学。Agentic RL 有一定学习难度,也是目前较前沿的大模型技术方向。 学习名额:180人 开源内容
扫码报名学习
2. 开源教程:Happy-LLM(从零开始构建大模型)
课程简介 市场上缺少一本从零开始系统讲解 LLM 原理,同时引导学习者亲手搭建和训练 LLM 的完整教程。《Happy-LLM》项目从 NLP 的基本研究方法出发,沿着 LLM 的思路与原理逐层深入,依次剖析架构基础和训练过程,并结合主流代码框架,手把手演练如何搭建和训练一个 LLM。本次我们将一起学习基础知识的第 1~3 章。 适合人群:适合大学生、研究人员和 LLM 爱好者。建议具备一定的 Python 编程经验,最好具备深度学习相关知识,并了解 NLP 领域的基本概念和术语。 学习名额:180人 开源内容
扫码报名学习
3. 开源教程:llm-algo-leetcode(推理优化方向)
课程简介 这是一个面向大模型入门到进阶的 Notebook-first 算法实战教程。本方向包括请求、工作负载与指标,预填充与 Attention 计算路径,投机解码与解码加速,KV Cache 表示、管理与复用,服务迭代预算、调度与异构协同,量化推理与单卡服务验证,以及分布式扩展与端到端决策。学习者将通过可运行、可验证的 Notebook,从“会看”走到“会写、会调、会优化”。 适合人群:对 LLM、MLSys 推理优化感兴趣的算法工程师、开发工程师和产品经理。 学习名额:180人 开源内容
扫码报名学习
4. 开源教程:llm-algo-leetcode(后训练优化方向)
课程简介 这是一个面向大模型入门到进阶的 Notebook-first 算法实战教程。本方向包括后训练目标与阶段选择、监督数据与目标构造、参数更新与训练交付、偏好数据与直接优化、奖励信号与策略更新、轨迹生命周期与在线系统,以及独立评测与采用决策。学习者将通过可运行、可验证的 Notebook,从“会看”走到“会写、会调、会优化”。 适合人群:对 LLM、MLSys 后训练优化感兴趣的算法工程师、开发工程师和产品经理。 学习名额:180人 开源内容
扫码报名学习
5. 开源教程:llm-algo-leetcode(模型架构与训练方向)
课程简介 这是一个面向大模型入门到进阶的 Notebook-first 算法实战教程。本方向包括注意力表示与 KV 压缩,位置、访问范围与长上下文,MoE 容量扩展与稀疏化,递推状态、SSM 与混合记忆,Transformer 局部反向与保存状态,计算图、梯度与有效更新,以及重算、搬运与驻留策略。学习者将通过可运行、可验证的 Notebook,理解模型架构与训练系统中的关键取舍。 适合人群:对 LLM、MLSys 模型架构与训练感兴趣的算法工程师、开发工程师和产品经理。 学习名额:180人 开源内容
扫码报名学习
6. 开源教程:llm-algo-leetcode(算子优化方向)
课程简介 这是一个面向大模型入门到进阶的 Notebook-first 算法实战教程。本方向包括首个内核与比较基线、图编译与算子融合、Triton 访存与分块、Attention 与推理内核、实际执行与性能归因、CUDA 协作与运行时,以及接口集成与负载复测。学习者将通过可运行、可验证的实验,掌握从建立基线到实现算子和复测负载的优化路径。 适合人群:对 LLM、MLSys 算子优化感兴趣的算法工程师和开发工程师。 学习名额:180人 开源内容
扫码报名学习
二、Agent专题
7. 开源教程:deepagents-in-action(从零构建生产级 Agent)
课程简介 Deep Agents 是 LangChain 开源的 Agent 开发框架,适合构建能够拆解复杂任务、持续调用工具并自主推进工作的智能体。本课程以 0.7 版本为基线,通过讲解、代码实验和组队讨论,带大家从运行第一个 Deep Agent 开始,逐步完成一个更可靠、可调试、能用于真实项目的 Agent。课程不以记忆 API 为目标,而是帮助大家理解 Deep Agents 适合解决什么问题,以及如何把 Agent 从 Demo 推向实际应用。 适合人群:具备 Python 基础、使用过大模型 API,想系统学习 Agent 工程的同学;也适合接触过 LangChain 或 LangGraph,希望解决复杂任务、上下文管理和工程可靠性问题的开发者。无需 Deep Agents 使用经验。 学习名额:360人 开源内容
扫码报名学习
8. 开源教程:Hello-Agents 入门篇(从零学习智能体)
课程简介 Hello-Agents 是 Datawhale 开源学习社区的系统性智能体学习教程。本教程旨在带领大家深入理解并构建真正的 AI Native Agent。本次组队学习的入门篇包含智能体基本介绍,动手跑通第一个智能体,智能体发展史,大模型基础,智能体经典范式构建,低代码平台运用以及热门智能体框架运用。 适合人群:具有 Python 基础且希望学习智能体基础知识的学习者。 学习名额:180人 开源内容 https://github.com/datawhalechina/hello-agents
扫码报名学习
9. 开源教程:Hello-Agents 进阶篇(构建智能体框架)
课程简介 Hello-Agents 是 Datawhale 社区的系统性智能体学习教程。本教程旨在带领大家深入理解并构建真正的 AI Native Agent。本次组队学习的进阶篇包含智能体经典范式构建、Hello-Agents 框架基础搭建、记忆与 RAG 系统搭建、上下文工程与终端能力讲解,手把手构建自己的 MCP 服务器,并从三个综合案例中选择一个跑通,最终完成自己的智能体毕业设计。 适合人群:面向希望构建智能体框架、掌握框架二次开发能力的学习者。 学习名额:180人 开源内容 https://github.com/datawhalechina/hello-agents
扫码报名学习
10. 开源教程:All-in-RAG:RAG 技术全栈指南
课程简介 本项目是一个面向大模型应用开发者的 RAG(检索增强生成)技术全栈教程,旨在通过体系化的学习路径和动手实践项目,帮助开发者掌握基于大语言模型的 RAG 应用开发技能,构建生产级的智能问答和知识检索系统。 适合人群:具备 Python 编程基础、对 RAG 技术感兴趣的开发者,希望系统学习 RAG 技术的 AI 工程师,想要构建智能问答系统的产品开发者,以及对检索增强生成技术有学习需求的研究人员。 学习名额:180人 开源内容
扫码报名学习
11. 开源教程:Easy Data × AI:构建知识与记忆驱动的 Agent
课程简介 《Easy Data × AI》是一门从数据视角理解和构建 AI 应用的开源课程,围绕 Agent、RAG、Memory、Skill 与 MCP 展开。课程采用“道篇+术篇”双轨结构:道篇训练场景判断、问题归因与系统设计能力;术篇通过可运行代码学习流式输出、工具调用、AI Native 数据层、Agentic RAG 和 Agent 记忆系统,并提供混合检索、上下文工程等扩展内容。 适合人群:学生、AI 爱好者、AI 应用开发者和产品经理。 学习名额:180人 开源内容
扫码报名学习 三、AI编程专题
12. 开源教程:Easy-Vibe(AI 编程与应用开发入门)
课程简介 课程采用循序渐进的项目实践路径:先通过小游戏快速上手 AI 编程,再学习 Vibe Coding 工作方式并完成 Web 应用原型,随后进入全栈开发、部署上线和跨平台复杂应用。每个阶段都配有完整项目,帮助学习者理解工具选择与开发流程,逐步把想法从原型转化为可用应用。 适合人群:课程对零基础学习者友好,适合希望系统学习 Vibe Coding 和 AI 能力应用场景的学习者。 学习名额:180人 开源内容
扫码报名学习
四、FDE专题
13. 书籍:《企业本体论:人人都是 FDE》
课程简介 本次学习以《企业本体论:人人都是 FDE》为蓝本,以退款助手落地实现的企业场景为切入点,通过代入 FDE 工作实践,带领读者走通一个 Agent 项目从立项到上线运营的 10 个关键站点,逐步掌握企业本体、知识工程、多 Agent 协同以及审计评测等专业知识,并能灵活用于实战。书中丰富的业务界面图、关系图谱及事故回放案例,确保每一步都有据可依、有例可循。本次共学为前三章内容。 适合人群:尤其适合希望将 AI 价值真正落地的工程师、架构师、产品经理及管理者。不会编写代码,也能跟随案例理解建模与交付的全过程。 学习名额:180人
扫码报名学习
14. 书籍:《FDE:人工智能时代的客户价值交付》
课程简介 本次学习以《FDE:人工智能时代的客户价值交付》为蓝本,围绕前线部署工程师(Forward Deployed Engineer,FDE)这一新兴岗位展开。全书按照企业人工智能项目交付全流程,依次讲解问题甄别、客户获取、系统激活部署、续约维护、收入增加,以及整套实操方法论的规模化复制,并收录可直接复用的指标清单和工作范式。本次共学为前三章内容。 适合人群:面向企业人工智能创业者、FDE 相关工程师,以及希望理解企业人工智能落地逻辑的从业者。 学习名额:180人
扫码报名学习 五、AI硬件专题
15. 开源教程:Nailongbot:从零组装桌面陪伴机器人
课程简介 本次共学以奶蛙桌面机器人为实践案例,从认识零部件开始,逐步完成机器人组装、固件烧录、联网配置和舵机校准,再设置人设与音色,制作一位能够语音对话、显示表情和执行动作的桌面陪伴机器人。完成基础开发后,可继续选择动作、表情、声音或 MCP 功能进行二次开发,并在课程 Wiki 分享改造作品。本课程需要实物硬件,请提前备齐零部件与结构件。 适合人群:适合对 AI 陪伴、智能硬件和 DIY 机器人感兴趣的学生、开发者及创客。基础组装无需编程基础;二次开发建议具备基础 C++、Git 和终端操作能力。 学习名额:180人 开源内容 https://github.com/lucklyduck/nailongBotWiki
扫码报名学习
六、AI Infra专题
16. 开源教程:hello-gpu(从 GPU 入门到 Agent 优化)
课程简介 想入门 GPU 计算,却常被硬件架构、性能分析和 Kernel 开发劝退?本课程面向初学者,以 AMD GPU 与 ROCm 为技术环境,用一个连续、可验证的 Vector Add 案例,在 21 个学习日内完成“认识 GPU 并跑通程序—学会可信计时—解释性能瓶颈—亲手实现 Kernel—让 Agent 接手优化”的学习闭环。学习者将从 GPU 架构和并行计算基础出发,逐步掌握程序运行、性能测量、瓶颈分析、Kernel 实现和自动优化的基本方法。 适合人群:对 GPU 架构、并行计算、算子开发或 AI 计算加速感兴趣的学生、工程师和技术爱好者。建议具备基本的 Python 或 C/C++ 编程能力和 Linux 命令行基础,不要求已有 GPU 编程经验。 学习名额:180人 开源内容 https://github.com/datawhalechina/hello-gpu
扫码报名学习
17. 开源教程:hello-rocm(零基础入门 ROCm)
课程简介 想在 AMD GPU 上把大模型用起来,却常被环境配置、框架选型和分散的 ROCm 资料劝退?本项目以 AMD GPU 与 ROCm 为技术环境,用一条连续、可复现的教程路径,完成“配好环境并跑通第一个模型—用多种框架完成部署—动手做微调训练—理解算子与 GPU 编程—把能力收成可运行的 AI 应用”的学习闭环。学习者将逐步掌握本地部署、模型微调、算子实践,以及在 AMD 平台上构建真实应用的基本方法。 适合人群:对大模型本地部署、微调训练、ROCm 生态或 AMD GPU 编程感兴趣的学生、工程师和技术爱好者。建议具备 Python 和命令行基础,不要求已有 GPU 编程或 ROCm 经验;需有 AMD GPU 或可使用配套云算力。 学习名额:180人 开源内容 https://github.com/datawhalechina/hello-rocm
扫码报名学习
18. 开源教程:GGUF 量化内幕
课程简介 本教程介绍常用的 Q2~Q8_K、IQ、UD_IQ,以及 PTQ1、STQ1 等三值量化格式。课程结合 ASCII 图表和 C++、C#、Python 示例,学习 GGUF 容器、不同量化格式的数据布局、解码流程与误差分析,并通过横向比较理解各类格式在体积、精度和速度上的取舍。 适合人群:希望制作 GGUF 量化模型、开发端侧推理引擎,或深入理解模型量化格式的学习者。 学习名额:180人 开源内容 https://github.com/datawhalechina/gguf-quant-internals
扫码报名学习
19. 开源教程:cpp-llm-engine(从零构建 C++ LLM 推理引擎)
课程简介 这是一套中文优先、以 C++ 为实现主线的推理引擎工程教程。学习者将从一次 TinyLlama 真实推理开始,逐步实现模型加载、张量、算子、解码器、生成、缓存、调度和服务。仅使用 CPU 即可完成主线;具备 NVIDIA GPU 时,可继续学习 CUDA 加速,并通过 SmolVLM 将文本输入扩展到图文输入。课程还将通过 Qwen3 与 Qwen1.5-MoE 理解不同模型架构及其工程实现。 适合人群:具备基础 C++ 能力,并对 Transformer 架构和推理有一定认识;适合希望系统学习 LLM 推理引擎,以及 CUDA、量化、KV Cache、调度和 MoE 工程实现的开发者。 学习名额:180人 开源内容 https://github.com/datawhalechina/cpp-llm-engine
扫码报名学习 七、AI4S专题
20. 开源教程:AI for Science(科学模型与科研智能体实战)
课程简介 本次共学以 AI for Science 为主题,围绕科学问题进入计算流程后的关键环节,设置“科研智能体与 Skill 入门—科研知识与数据整理—科学模型训练、评估与可解释设计—科研智能体进阶与 AI Scientist”四个递进任务。课程以科学问题为起点,依次学习文献与实验资料组织、可信数据整理、模型选择与训练评估、科研工具调用、长程任务运行和结果核验,帮助参与者形成可记录、可检查、可复用的科研工作流。 适合人群:面向对 AI 辅助科研感兴趣的高校学生、科研人员和相关开发者。具备代码使用经验者可进一步完成模型训练、工具调用和实验迭代任务。 学习名额:180人 开源内容 https://github.com/TashanGKD/panshi-ai4s-practice
扫码报名学习
21. 实战营:沐曦 AI4S 实战营(国产 GPU 加速科研)
课程简介 由 AI Infra 开源社区联合 Datawhale 开源学习社区、书生大模型开源社区、启悟学习社区和沐曦股份共同主办的“国产 GPU 加速科研线上实战营”,面向高校及科研院所师生、开发者,以及对 AI4S、AI 智能体科研应用感兴趣的学习者开放。项目同步托管在 GitLink 开源平台。 适合人群:对 AI4S 感兴趣的学习者。 学习名额:180人 开源内容 https://gitlink.org.cn/ccf-ai-infra/Science-Agent-Lab
扫码报名学习
 一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。