给大模型装上摄像头,北大重磅开源:3D空间智能基准来了!
原创 Datawhale 2026-11-15 23:34 浙江
Datawhale干货
作者:北大团队
Datawhale干货
作者:北大团队
如果给大模型一台可以自由移动的摄像头,它能否走进一个房间,找到目标物体,并准确说出每个物体的三维坐标?
北京大学与天津大学团队提出 SpatialScout,将这个问题转化为可交互、可量化的评测任务。基准包含 80 个室内场景和 3,140 个目标物体,要求视觉语言模型智能体自主获取视觉证据,逐步建立统一坐标系下的物体中心地图。
论文 https://arxiv.org/abs/2610.26659代码 https://github.com/JesseZZZZZ/SpatialScout
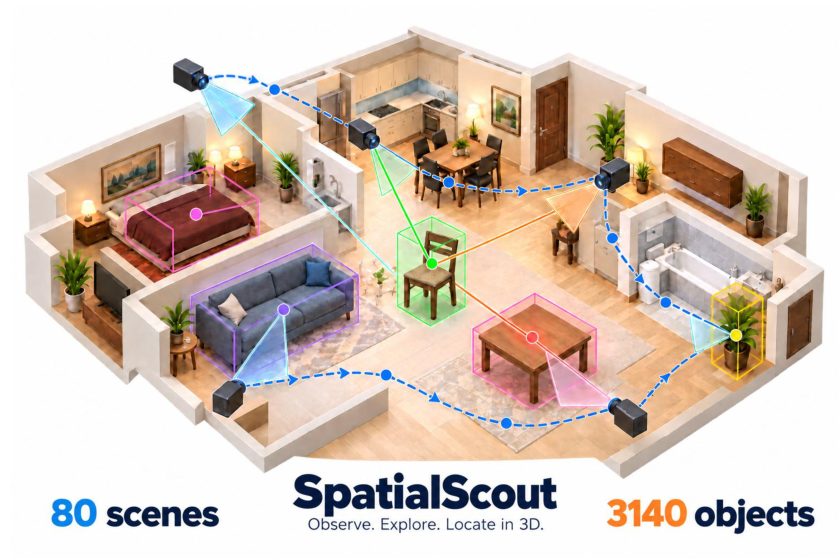
图 1 SpatialScout 任务概览
一、用三维物体地图检验空间理解
许多空间评测关注模型能否回答图像或视频中的方向、距离和位置关系问题。SpatialScout 进一步要求模型把观察结果落实到明确的三维坐标,并在后续探索中持续补全和修正。模型需要决定下一步看哪里、识别不同视角中的同一物体,并把局部证据整合成一致的空间表示。
实验表明,这对当前模型仍是明显挑战。在论文评测的模型中,表现最好的 Claude Opus 5.5 全目标平均 IoU 为 41.71%,达到 IoU > 0.9 的目标仅占 3.25%。这些结果揭示了当前模型在完整覆盖目标和精确定位方面的不足。
二、一次自主探索如何完成评测
SpatialScout 将观察、行动、几何估计与地图更新放在同一个任务中。所有模型使用统一的工具接口、提示词和交互预算,最终根据提交的物体位置评估建图质量。
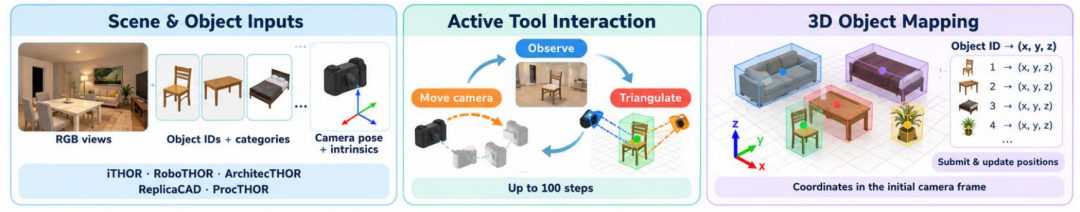
图 2 从场景输入到自主交互和三维物体地图的完整评测流程
从初始视角出发。智能体获得一张 RGB 图像、目标物体清单、相机内参和位姿,以及公开的搜索范围。目标的真实中心、包围盒和评测分数保留在评测端,探索过程中不会向模型返回。
自主选择下一次观察。智能体可以平移或旋转摄像头、拍摄新图像,并利用不同视角中的对应像素调用三角测量工具。它需要自己判断哪些视觉特征属于同一物体,以及估计出的表面点如何对应到物体的几何中心。
边探索边更新地图。智能体以初始相机定义的固定坐标系提交物体中心,能够分批补充目标或修改已有估计。每个任务最多允许 100 次模型调用和 100 张 RGB 图像,初始图像也计入预算;一次模型调用可以请求多个工具。
三、定位精度与目标覆盖率共同计分
评测同时报告以米为单位的中心误差、目标覆盖率,以及与物体尺度相关的三维交并比 IoU。计算 IoU 时,评测器将目标的参考包围盒平移到预测中心,再与真实位置的包围盒比较,因此模型提交的是坐标,无需预测物体尺寸。
全目标平均 IoU 将未提交的物体按零分计算,已提交目标的平均 IoU 则反映已有位置估计的质量。两者结合,能够揭示模型是否只定位了少数容易的物体。同类可互换实例采用组内一一匹配,减少编号顺序对结果的影响。
四、当前模型离精确建图还有多远
论文评测了 7 个模型,并比较了 GPT-6 Astra 的两档推理设置。主结果显示,模型之间存在明显差距,而高精度定位对所有受测模型都具有挑战。
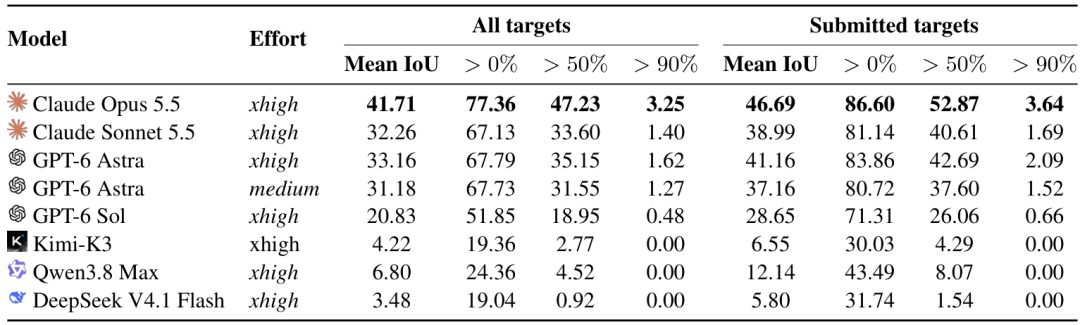
图 3 80 个场景上的主实验结果 所有数值均为百分比
Claude Opus 5.5 的全目标平均 IoU 为 41.71%,GPT-6 Astra 在 xhigh 设置下为 33.16%。即便是排名第一的模型,IoU > 0.5 的目标占比也只有 47.23%,IoU > 0.9 的目标占比进一步降至 3.25%。这里的 IoU 是位置估计的尺度相关重叠分数,并非任务成功率。
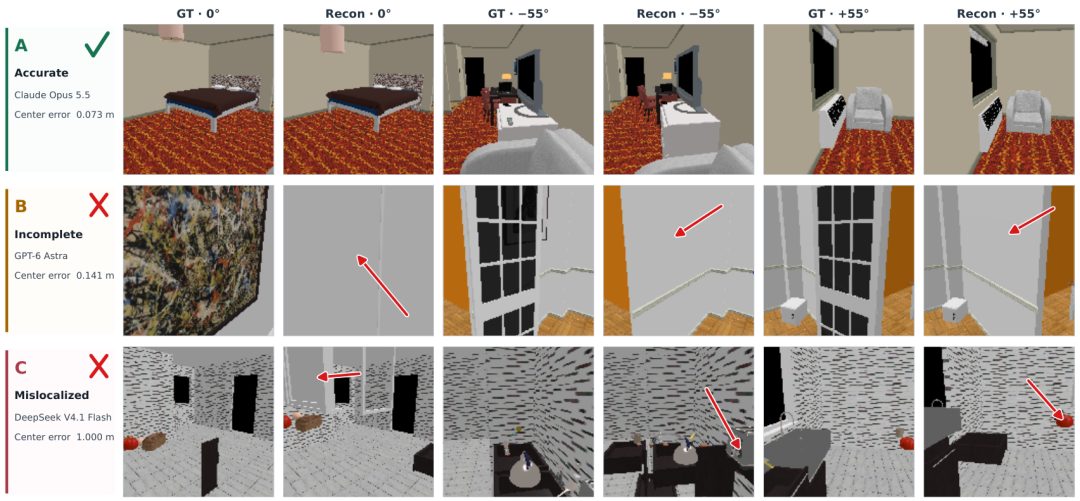
图 4 准确定位 目标遗漏与定位错误的可视化案例
可视化直观展示了两类主要困难:物体可能被遗漏,也可能被放在错误的位置。图中的场景使用参考物体的形状与朝向,仅改变其中心位置,因此展示的是物体中心地图的质量。完整提交和准确定位都需要被单独检查。
五、有效观察比单纯增加交互更关键
为什么有些模型看得更多,定位却更差?论文对 80 个共同任务的轨迹分析发现,GPT-6 Astra 平均每个任务拍摄 32.41 张图像,少于 DeepSeek V4.1 Flash 的 39.63 张,但已提交物体的中心误差中位数分别为 7.08 厘米和 68.17 厘米。
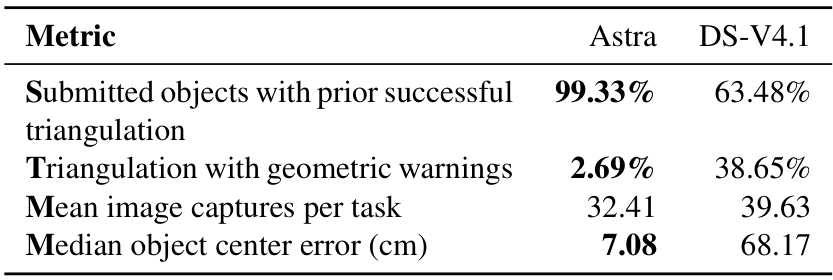
图 5 GPT 6 Astra 与 DeepSeek V4.1 Flash 的几何工具使用对比
GPT-6 Astra 的已提交目标中,99.33% 在提交前有成功三角测量记录,DeepSeek V4.1 Flash 为 63.48%;两者成功三角测量调用中的几何警告占比分别为 2.69% 和 38.65%。这些观察提示,跨视角对应和几何工具的有效使用,与最终定位表现密切相关。
更细致的失败分析覆盖 4 个模型在 10 个选定任务上的 40 条轨迹。其中只有 6 条同时达到至少 90% 的覆盖率与不超过 0.2 米的平均中心误差。其余 34 条中,26 条存在覆盖不完整,21 条在三角测量残差较低时仍保留明显位置错误;这些问题可以重叠出现。几何残差较小,并不足以保证模型找对了跨视角特征或物体中心。
写在最后
SpatialScout 既比较最终地图,也保留观察、工具调用与位置更新的过程,帮助研究者分析模型如何选择视角、关联物体和修正空间估计。它为改进视觉语言智能体的三维理解能力提供了具体目标:让视觉证据持续转化为更完整、更准确的物体地图。
当前数据基于物理仿真环境,真实场景中的复杂性仍需进一步验证。论文提出了后续真实场景数据计划,并公开代码,欢迎围绕主动感知、空间表示和具身智能开展研究与合作。
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。