ECCV 2026 中科院&腾讯等提出StrucTab:专业表格解析1B小模型
原创 CV君 2026-11-16 23:15 江苏
认知推理与解耦RL破局表格解析
在多模态文档解析领域,面对高度复杂的二维拓扑与跨行跨列合并逻辑,向来被视作巨型模型的竞技场。然而,如同“大卫击倒歌利亚”的经典战役一般,来自中国科学院信息工程研究所、腾讯、南开大学、中国科学院大学网络空间安全学院、深圳河套研究院与香港科技大学的联合研究团队打破了这一常规:仅凭 1B 参数量级的轻量骨干,全新提出的结构化表格解析框架 StrucTab 斩获四大基准平均 88.79 TEDS 的顶尖战绩,以 +7.13% 与 +19.14% 的显著优势一举斩落 Gemini 2.5 Pro 与 GPT-5 等顶尖闭源旗舰。
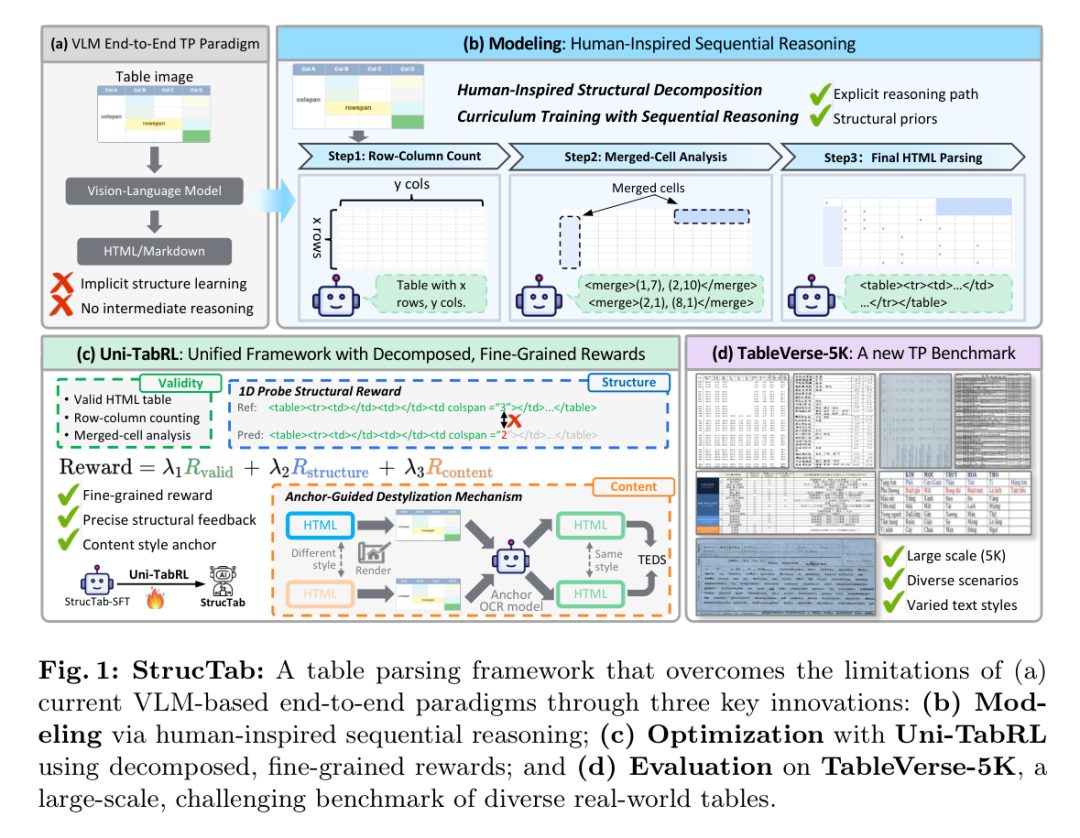
面对传统级联方案误差累积、纯端到端自回归黑盒生成缺乏中间结构脚手架,以及表格强化学习(RL)奖励高噪失真的行业痛点,StrucTab 引入了人类启发式的层次化结构分解与两阶段课程学习,并量身定制了三元解耦细粒度强化学习框架 Uni-TabRL。配合团队全新推出的大规模复杂场景基准 TableVerse-5K,StrucTab 证明了通过认知驱动的结构化优化,小模型同样能爆发出颠覆超大模型的强大拓扑解析力。目前该项目代码与基准数据集均已正式开源。
背景与动机:端到端与强化学习的现有瓶颈
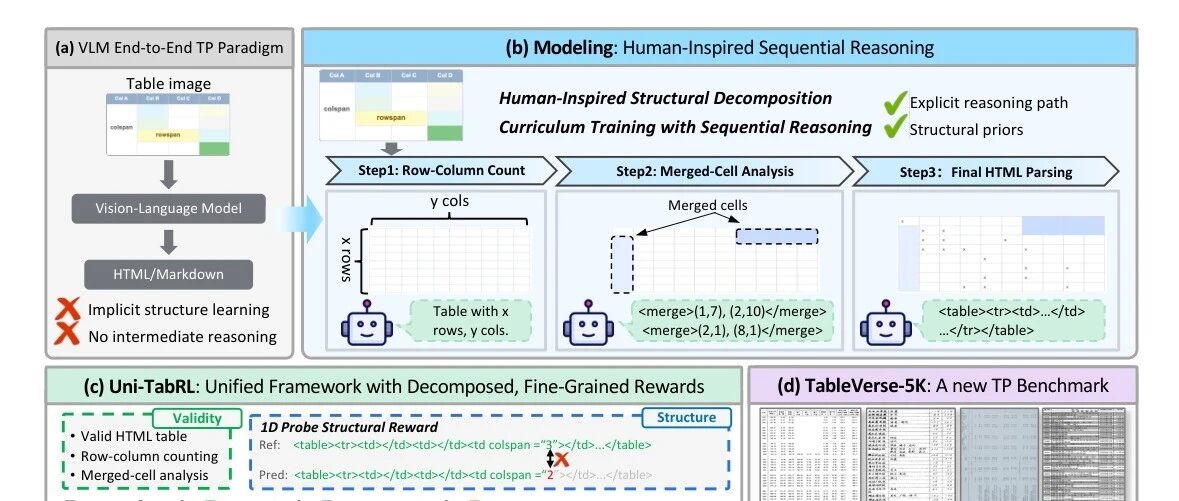
近年来,端到端 VLM 将文档图像直接翻译为 HTML 或 Markdown 代码,极大地简化了传统 OCR 级联架构的复杂流程。但正如上图 Fig. 1(a) 所示,现有的端到端方式本质上是将高度结构化的二维表格视作一维扁平序列,采用自回归方式强行拟合最终代码。由于完全跳过了显式的中间推理过程,模型被迫在黑盒内部隐式学习复杂的行列与跨行跨列拓扑,这使得长程解码极其脆弱,稍有不慎便会导致后续单元格全面错位。
为了增强表格解析的鲁棒性,部分前沿工作引入了强化学习。然而,现存的奖励设计机制存在明显的双重失效困境(如下图 Fig. 2 所示):
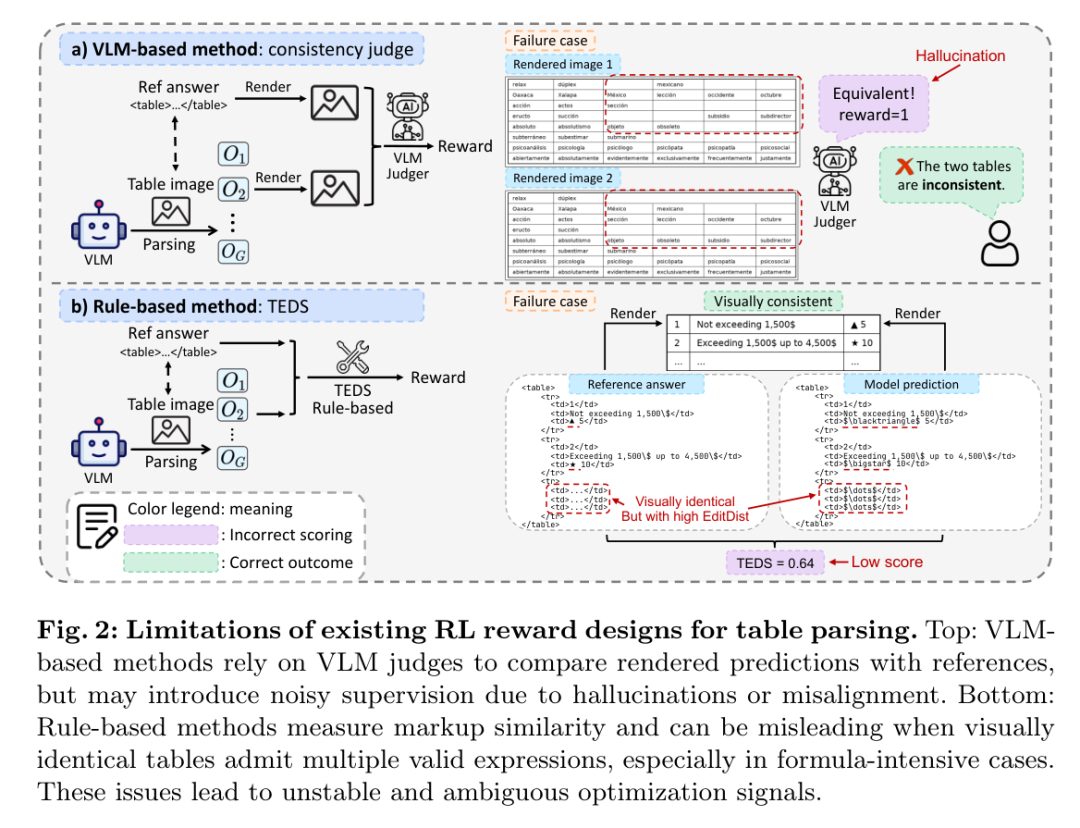
基于 VLM 评判的困境(VLM-as-a-judge):如 Fig. 2 上半部所示,让多模态大模型担任裁判去比对预测代码渲染图与参考答案图,往往会受制于裁判模型自身的细粒度视觉感知缺陷或幻觉,给出与真实质量不符的噪声奖励;
基于规则指标的困境(如 TEDS):树编辑距离相似度(Tree-Edit-Distance-based Similarity, TEDS)直接在语法标记层级计算编辑距离。然而,表格内容(尤其是数学公式与符号)常常存在多种完全等价的语法表述形式。如 Fig. 2 下半部展示的真实案例,模型预测的公式代码
$\blacktriangle$与真值中的字符“▲”在视觉和语义上完全一致,但由于标记字符串不符,规则指标给出的 TEDS 得分从正常的满分骤降至 0.64,向策略模型传递了严重的误导信号。
此外,现有评测基准通常只将表格作为通用文档理解的次要子集,样本量普遍仅有数百张,难以充分体现真实世界中拍照、扫描以及复杂手写表格的真实挑战。
StrucTab 方法详解:从认知建模到精细化强化学习
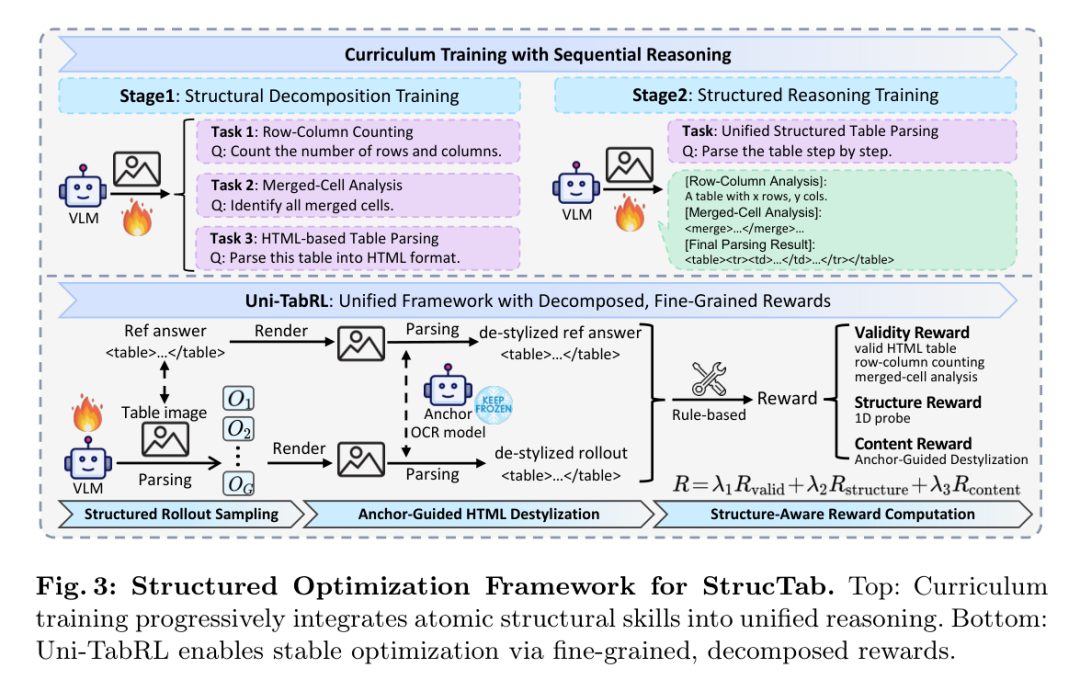
针对上述难题,StrucTab 在建模、训练与强化学习优化三个层面进行了全链路重构,其整体架构如下图 Fig. 3 所示:
1. 人类启发式结构分解与两阶段课程学习
人类在阅读和转录复杂表格时,往往遵循一种天然的层次化认知轨迹:首先纵览全局确定大致的行列布局,随后排查局部特殊的合并单元格,最后逐格填入对应文本。
受到该认知的启发,StrucTab 将表格解析任务明确解耦为两个先验子任务和一个终极生成任务:
全局行列计数(Row-Column Counting):输入表格图像,提示模型估算表格的宏观维度,输出简明的结构描述(如
Table with x rows, y cols.);合并单元格分析(Merged-Cell Analysis):从 HTML 的
rowspan和colspan属性构建虚拟网格矩阵,提取跨行跨列单元格并格式化为结构化标记序列,例如<merge>(r1,c1),(r2,c2)</merge>;最终 HTML 解析(Final HTML Parsing):生成包含完整结构和文本的规范化 HTML 表格代码。
为了让模型平稳掌握这项链式能力,团队设计了两阶段课程学习策略:
阶段一(原子技能解耦预训练):在海量合成与公开数据上,将行列计数、合并单元格分析和基础 HTML 解析划分为三个互相独立的 QA 任务进行训练,让模型夯实基础结构感知能力;
- 阶段二(序列化思维链统一推理):将上述三个任务融合成单轮统一提示(
Parse the table step by step.),强制模型按照固定顺序一次性输出完整响应:这种建模使得模型在输出最终 HTML 时,天然以自身生成的行列骨架和拓扑约束为上下文条件。
2. Uni-TabRL:三元解耦细粒度强化学习奖励
在基于群体相对策略优化(Group Relative Policy Optimization, GRPO)的强化学习阶段,StrucTab 摒弃了单一或模糊的标量奖励,提出了三元解耦奖励框架 Uni-TabRL:
其中超参数设置为 。三大组件分别承担正交的监督职责:
合法性门控奖励(Validity Reward, ):设置硬约束门控。只有当输出包含完整闭合的 HTML 标签,且预先预测的行列数和合并单元格信息与真值完全一致时,,否则整个样本奖励直接判定为 0.0,从源头上遏制语法崩溃与低级格式缺陷。
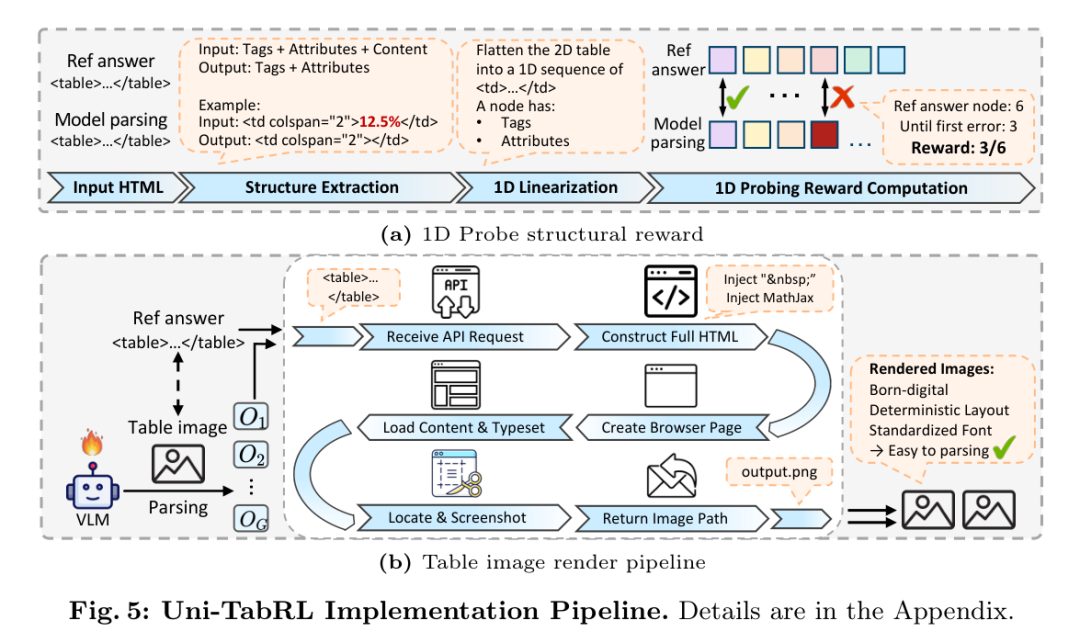
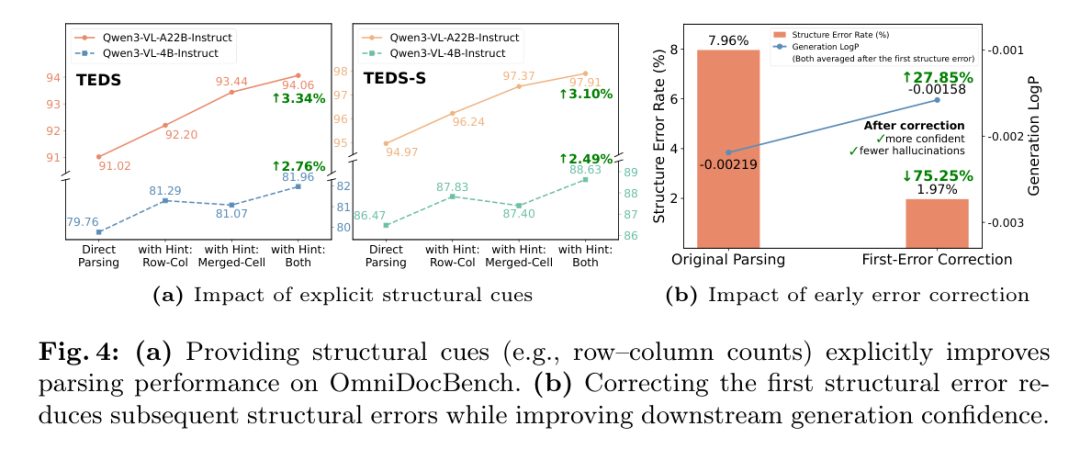
1D 探针结构奖励(1D Probe Structural Reward, ):传统的结构指标 TEDS-S 只能提供全局聚合相似度,无法指引长文本自回归模型“究竟在哪里开始产生偏离”。研究团队通过前序验证实验发现:在解码流中仅仅修正第一个结构错误,便能使后续结构错误率大幅下降 75.25%,并将后续生成的对数概率(置信度)拉升 27.85%(见下图 Fig. 4(b))。 为此,团队设计了如 Fig. 5(a) 所示的 1D Probe 探针机制:将预测与参考的 HTML 剔除文本后,线性展开为单元格标记序列,从头逐个比对行索引、标签名及跨行跨列属性。一旦遇到首个不匹配的位置立即截断,取截止到首个错误前的正确单元格数量 与真值总单元格数 的比值作为奖励()。该机制精确奖励最长正确结构前缀,极佳地贴合了自回归因果特性。
锚点引导去样式化内容奖励(Anchor-Guided Destylization, ):为解决公式与文本书写形式多样性带来的误判,团队构建了基于 Playwright + MathJax 的确定性渲染引擎(见 Fig. 5(b))。将预测与参考 HTML 分别渲染为标准图像后,交由冻结的轻量 OCR 模型(HunyuanOCR)作为“风格锚点”进行统一二次识别重写,消除视觉等价背后的语法差异,最后对格式归一化后的 HTML 计算标准 TEDS,得到纯粹反映语义内容保真度的无噪奖励。
TableVerse-5K:大规模真实复杂表格评测基准
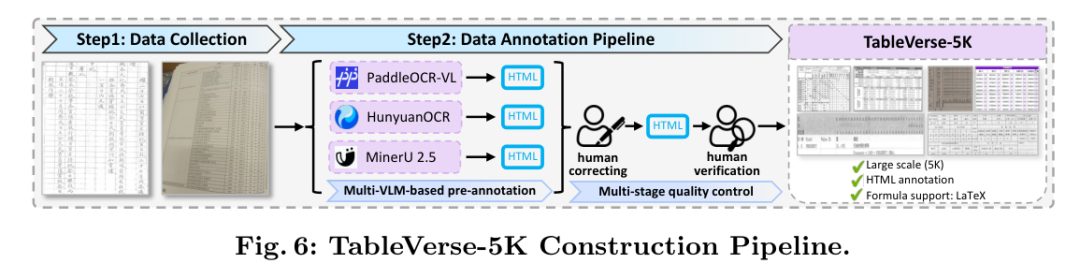
为全面评估模型在复杂真实场景下的泛化能力,团队构建了全新的评测基准 TableVerse-5K。如流程图 Fig. 6 所示,基准中的 5,000 张表格全量人工采集自学术论文、海报、行业报告与技术文档,涵盖扫描文档、印刷拍摄及手写拍摄多种复杂场景。
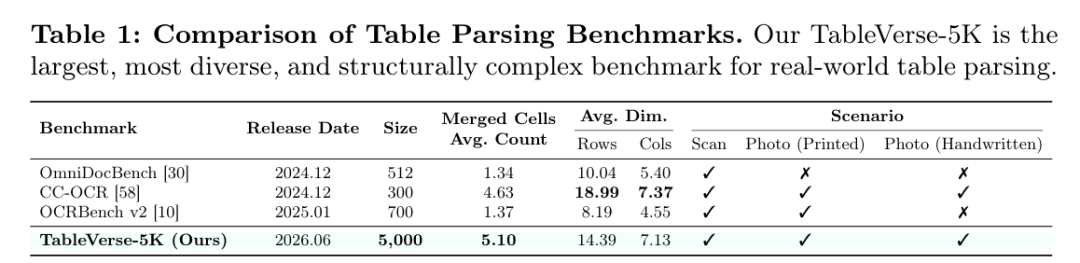
如下图 Table 1 数据对比所示,TableVerse-5K 在样本规模(5,000 张)与平均合并单元格数(5.10 个)上均明显高于现存的 OmniDocBench、CC-OCR 和 OCRBench v2,且全面覆盖复杂手写与拍摄畸变,是目前结构复杂度与多样性极高的表格解析基准。
实验与结果分析
全量实验在 16 张 NVIDIA H20 GPU 上完成。StrucTab 采用 1B 规模的 HunyuanOCR 作为视觉语言主干网络,通过 6M 预训练数据、100K 阶段精调以及 30K 样本的 Uni-TabRL 强化学习训练而成。
1. 主实验对比:小模型大幅超越主流闭源旗舰
在涵盖 OmniDocBench、CC-OCR、OCRBench v2 以及 TableVerse-5K 的系统性评测中,StrucTab 展现出了优异的解析水平(如下表 Table 2 所示):
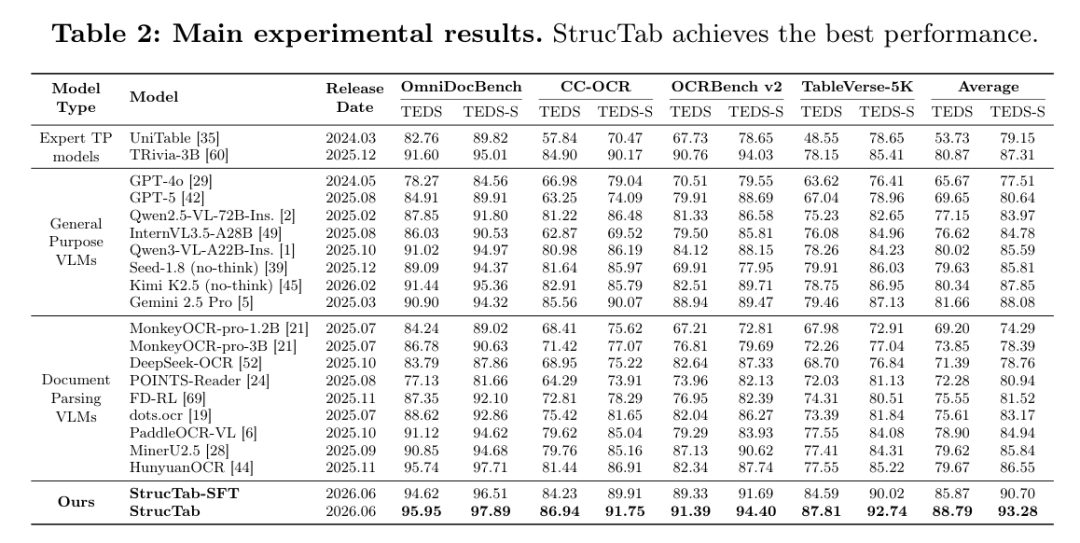
全面刷新最优性能(SOTA):最终版本的 StrucTab 取得了 88.79 TEDS 和 93.28 TEDS-S 的四大基准平均成绩,在所有评估基准上均位居前列;
大幅超越闭源巨型多模态模型:尽管 StrucTab 仅包含 1B 参数,其平均 TEDS 却大幅领先 Gemini 2.5 Pro(81.66 TEDS,领先 +7.13%)和 GPT-5(69.65 TEDS,领先 +19.14%),同时大幅超越开源的 Qwen2.5-VL-72B-Instruct(77.15 TEDS);
超越同类强化学习方案:相较于此前采用表格问答反馈的 TRivia-3B(80.87 TEDS)和格式解耦强化的 FD-RL(75.55 TEDS),StrucTab 分别领先了 7.92% 和 13.24%,验证了解耦细粒度奖励的有效性。
2. 关键消融实验分析
为了拆解各个核心创新的独立贡献,论文给出了深入的消融数据:
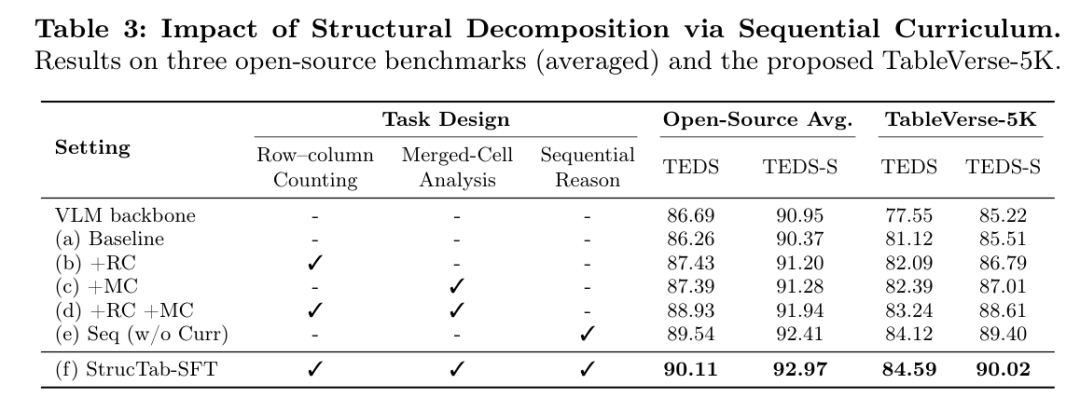
结构分解与课程学习的必要性(Table 3):相比基线端到端模型(86.26 TEDS),单纯引入行列计数(+RC)或合并单元格分析(+MC)均能带来近 1 个百分点的增益,两者叠加达到 88.93 TEDS。而采用完整的阶段一技能拆解加阶段二序列推理(StrucTab-SFT),性能进一步升至 90.11 TEDS。
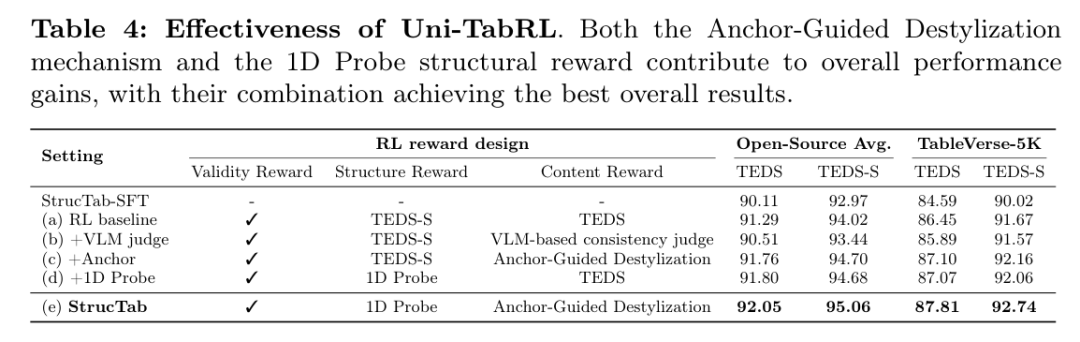
Uni-TabRL 奖励项拆解(Table 4):
在传统 RL 基线(Validity + TEDS-S + TEDS)上,平均 TEDS 为 91.29;
若将内容奖励替换为 VLM 裁判(Setting b),得分反而下降至 90.51,直接证实了多模态模型作为裁判引入的感知噪声;
单独加入去样式化机制(Setting c)或 1D Probe 结构探针(Setting d),指标均稳定提升至 91.76 和 91.80;
两者合力构建的 StrucTab(Setting e)达到顶峰的 92.05 TEDS / 95.06 TEDS-S。
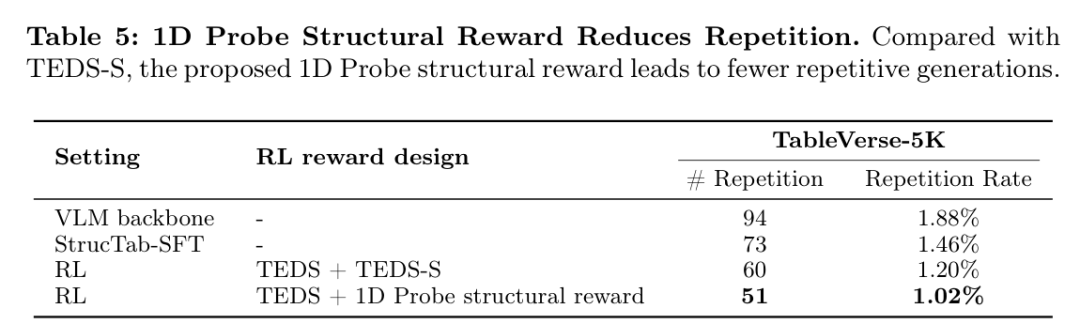
抑制自回归死循环重复(Table 5):长表格解析中常见的严重缺陷是模型漏解
</table>闭合标签,导致自回归陷入无限重复生成。实验表明,1D Probe 结构奖励通过对早期错位的强力惩罚,将 TableVerse-5K 上的重复发生率由原始骨干的 1.88% 骤降至 1.02%。
极难复杂样本的断层领先(附录 Table E.2):团队专门切片了 TableVerse-5K 中 SFT 阶段 TEDS-S < 0.75 的 1,021 个极难样本(平均达 19.31 行 × 9.52 列)。在这些困难样本上,原生 SFT 基线得分仅为 0.415 TEDS,传统 RL 达到 0.524 TEDS,而完整的 StrucTab 大幅跃升至 0.572 TEDS / 0.682 TEDS-S,表明细粒度奖励的优势在极端复杂表格场景下尤为明显。
3. 定性结果可视化
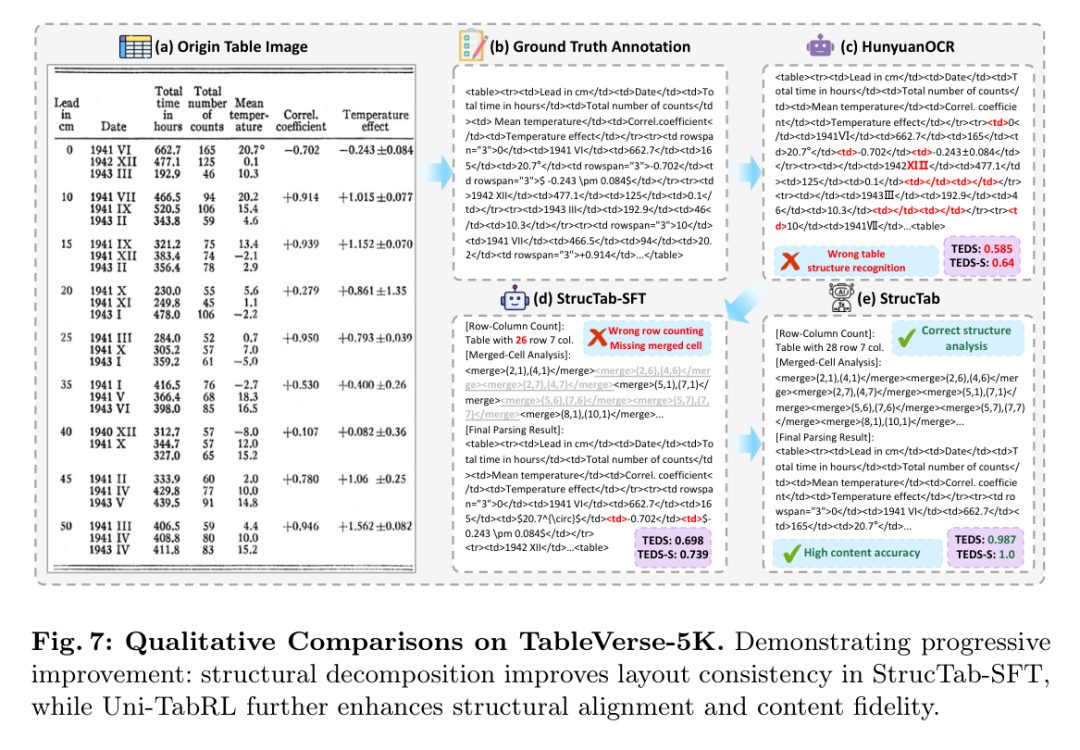
如下图 Fig. 7 所示,在真实的复杂历史文献表格中,基线 HunyuanOCR 完全丢失了跨行合并关系,导致大量空单元格与行列串位;StrucTab-SFT 依靠显式的思维链输出了正确的 26 行 7 列与合并位置,但在细部公式和符号上略有瑕疵;而经过 Uni-TabRL 优化后的 StrucTab,无论是在行列结构对齐还是上标公式(如 $20.7^{\circ}$、$-0.243 \pm 0.084$)的内容还原上均与真值高度吻合,取得了高达 0.987 的 TEDS 得分。
一点思考
StrucTab 的实践给密集结构感知类任务带来了一个清晰的信号:大模型端到端直接自回归并不是解决高复杂度拓扑生成的唯一答案。面对具备严格二维网格约束的对象,模仿人类“先抓骨架、再辨拓扑、最后填入内容”的认知过程,通过显式结构化思维链给小模型搭设脚手架,能以极小的推理开销(生成的 Token 总量仅微增 7.3%)换取显著的拓扑稳定性。
同时,Uni-TabRL 中的 1D Probe 截断探针 与 去样式化渲染闭环,巧妙避开了大模型作为裁判时的幻觉陷阱以及规则匹配对同义公式代码的误判,为文档级结构理解中的强化学习奖励函数设计提供了具工程参考价值的解题思路。
论文标题: StrucTab: A Structured Optimization Framework for Table Parsing
机构: 中国科学院信息工程研究所、腾讯、南开大学、中国科学院大学网络空间安全学院、深圳河套研究院、香港科技大学
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。