AI学着读懂物理世界:清华张强团队发布自进化AI科学家EvoSim
让你更懂AI的 2026-11-16 21:49 北京
让模型与方法一起进化
从电池实验数据出发,AI 科学家开始自己搭建模型解析物理世界了!
最近,清华大学化工系张强教授团队联合北京清屿科技、香港大学、北京怀柔实验室等机构,在论文《EvoSim: Learning to Model, Modeling to Learn》中提出了一个面向物理建模的 AI 科学家 EvoSim。
论文地址:
https://arxiv.org/abs/2610.11344
物理模型是材料研发和器件设计中的常用工具。研究人员用一组方程描述材料内部发生的过程,算出电压、温度这些可以测量的量,再与实验结果对照。
现有的 AI 科学家系统已经能在物理模型中调整参数、拟合数据,但模型该包含哪些物理过程,通常仍由研究人员事先定好。
EvoSim 把这一步也交给了 AI。当模型算出的结果和实验对不上时,它会判断问题是否出在模型漏掉了某个物理过程,找到后补进模型,再用实验数据检验。
在这个过程中,EvoSim 还会把检验有效的做法整理成建模方法,用到后续任务中。模型在改进,建模方法也在改进,论文把这种两者同步提升的过程称为“自进化”。
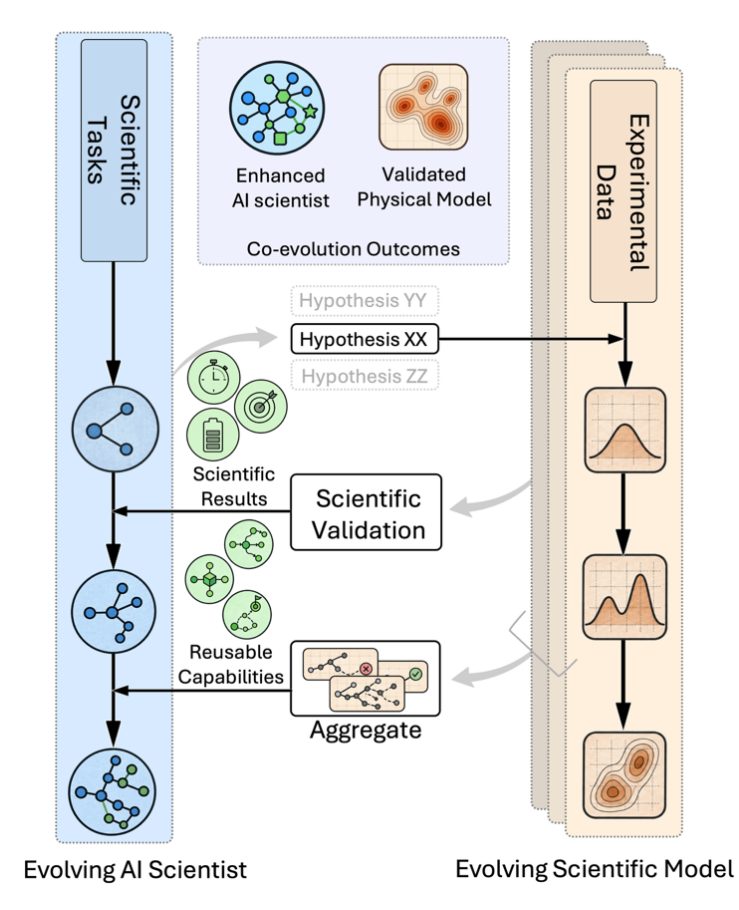
〓 图1. EvoSim让物理模型与开发它的 AI 科学家协同进化。图片来自论文。
团队用两项工业级电池建模任务测试了 EvoSim。
第一项任务是预测快充时何时开始析锂,也就是负极表面何时开始析出金属锂。EvoSim 的平均误差为 1.79 个百分点,原研究模型为 2.82 个百分点。
第二项任务是预测车辆行驶时的电池电压。面对建模时没有用过的温度,EvoSim的误差低至 7.62 毫伏,好于此前发表的多个电池电压模型。
更值得注意的是,用上自己总结的建模方法后,EvoSim 在同一任务上的误差降低了 75.4%。在 11 项建模任务的 45 组实验中,它的出错次数减少 36.4%,运行时间缩短 42.6%。
这是怎么做到的?
预测和测量对不上:是参数、求解,还是方程本身出了问题?
AI 在数学、编程等任务上进步很快。这些任务规则清楚,答案对不对可以直接判断。
材料研发和器件设计面对的问题则不同。以锂电池为例,锂离子在电解液中迁移,在电极颗粒中扩散,在电极表面发生反应。
这些过程都发生在微观尺度,没法直接看到。研究人员能拿到的,通常只有电压、电流和温度这些外部数据。
物理模型就是用来连接这两者的。研究人员把内部过程写成方程,通过求解(用计算机算出模型结果)得到电压等数值,再与实验数据比较。两者吻合,说明模型对内部过程的描述大体正确。
真正的难点在两者不吻合的时候。偏差可能来自参数取值不准,可能来自求解过程出错,也可能是方程漏掉了某个物理过程。
前两种情况,调整参数、检查计算就能解决。第三种情况,则要先弄清漏掉的是什么,再把它补进模型。
这恰恰是现有 AI 不擅长的地方。在电池专业知识问答上,前沿大模型的准确率已经很高,但问答只需要从已有知识里找答案。
一旦要求它根据实验现象提出新的物理解释,并用实验去检验,它的表现就不稳定了。
许多 AI 辅助建模工具,也只是在研究人员给定的模型里调参数、跑仿真。如果模型本身漏掉了关键的物理过程,参数调得再细,预测和实验之间那些有规律的偏差也消除不了。
于是,EvoSim 要回答的问题是:预测和实验对不上时,AI 能不能自己找到原因、补上缺失的物理过程,并把这次摸索出的有效做法用到下一个任务里?
EvoSim 的做法,是把每一次预测偏差都当作一个需要研究的问题。
它会先列出几种可能的原因,比如某个参数取值不准,或者模型缺了某个物理过程。
每种原因对应一个修改方案,由此生成一个待检验的模型,称为候选模型。几个候选模型会同时搭建,并调用仿真软件 COMSOL 求解。
每个候选模型都要通过三项检查:修改是否真的在模型中生效;求解是否完整完成、结果有没有异常值;预测与实验数据的误差有多大。三项都通过,候选模型才会被采用。
没被采用的候选模型也有用处。EvoSim 会记下它失败的条件和出错的步骤,并据此提出改进做法。改进做法要在后续任务中用过、确认有效,才会作为建模方法保存下来。
下一轮研究开始时,EvoSim 会调出与当前问题条件相符的建模方法,用来决定先检验哪个原因、先做哪项检查。
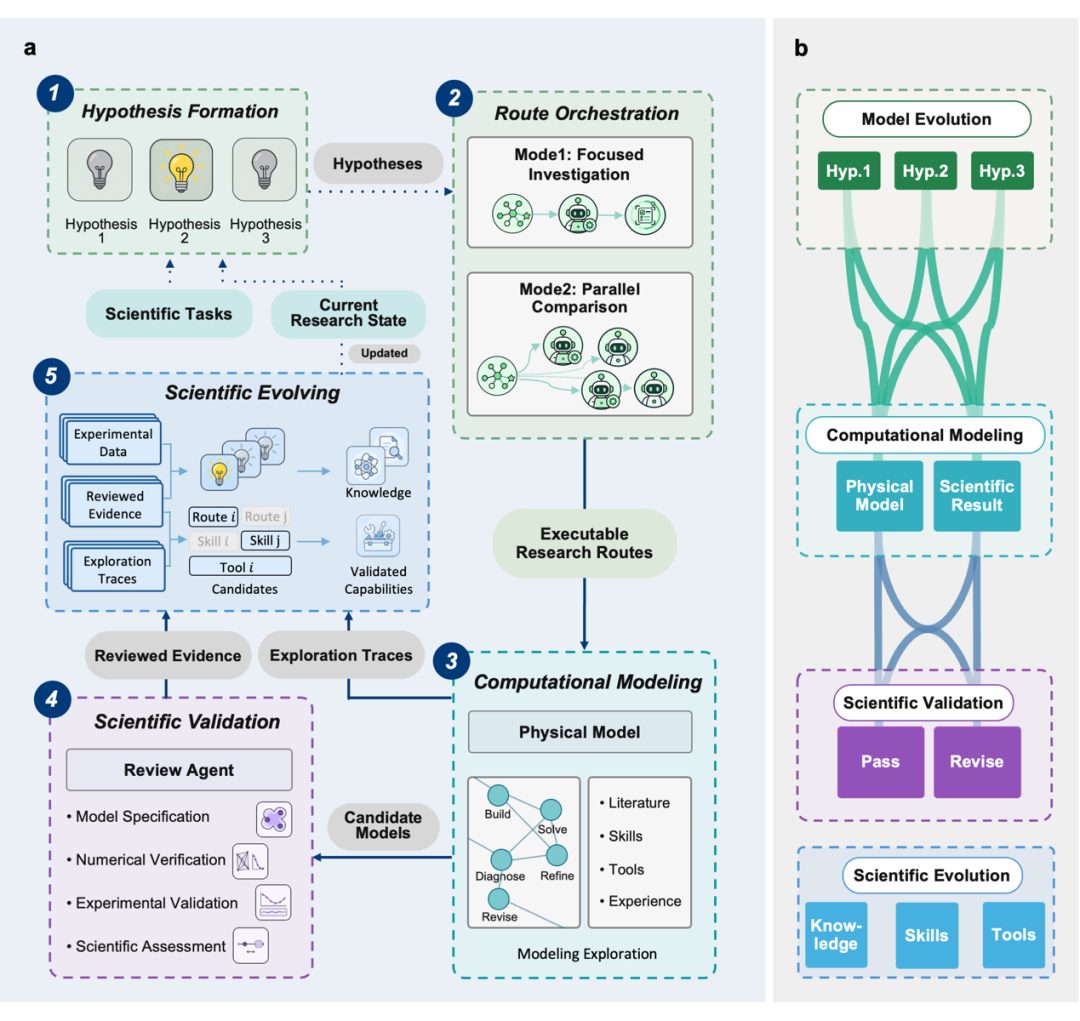
〓 图2. 同一轮实验反馈在推动物理模型修订的同时,也为 AI 提炼和检验建模方法提供了证据;更新后的方法继续引导后续的模型探索。图片来自论文。
因此,每一轮研究改进的不只是模型,还有 EvoSim 自己的建模方法。下面两项电池任务,分别展示了这两方面的效果。
快充提速的代价:析锂从哪一刻开始?
充电时,锂离子本应嵌入石墨负极。充电倍率是充电电流与电池容量之比,倍率越高,充得越快。
但倍率过高时,部分锂离子来不及嵌入,就会在负极表面析出为金属锂,这就是析锂。析出的锂有一部分会永久失去活性,导致电池容量下降,还可能带来安全隐患。
析锂起点通常用荷电状态来表示。荷电状态是当前电量占总容量的百分比。析锂起点决定了快充时电池最多能充到多少电量而不析锂,是设计快充策略的重要依据。
预测析锂起点并不容易。它同时受温度、电极厚度、充电倍率等因素影响。充电过程中,负极内部的锂含量又无法直接测量,单看外部电压曲线,很难判断析锂从何时开始。
研究使用的是一项发表在 Nature Energy 上的研究所公开的数据。
这批数据包括来自 61 个测试电池的 20 组析锂起点,覆盖两种厚度的石墨电极、25 至 45 摄氏度,以及 2C 至 6C 的充电倍率(1C 约为 1 小时充满)。
其中 14 组数据用于参数识别,也就是用实验数据确定模型参数的取值。另外 6 组作为验证条件,只用来检验预测,不参与参数识别。
EvoSim从 首先建立了锂离子在电解液和电极颗粒中的迁移,以及锂嵌入石墨的反应。继续,EvoSim 给模型加上了析锂反应,以及已析出的锂重新溶解的剥离反应。
接下来,模型需要估算析出的锂中有多少变成了不可逆锂,也就是再也无法参与充放电的锂。一开始,这个比例被设为固定的 30%。
结果发现,预测偏差随充电倍率有规律地变化。这说明“固定比例”这个假设站不住。
EvoSim 据此提出了新的解释:不可逆锂所占的比例并不固定,而是随充电倍率变化。
背后的道理并不复杂。析出的锂要失去活性需要一段时间,比如与电极断开电接触,或者被电极表面新生成的膜层包裹。
充电倍率越高,充电时间越短,析出的锂在测量前来得及失去活性的比例就越低。
当然,这并不是说快充时析出的锂更少。快充时析锂总量会增加,只是其中失去活性的比例下降了。
EvoSim 随后把这一比例改成了随充电倍率变化的关系。研究用平均绝对误差来衡量结果,也就是把各条件下预测值与实测值之差的绝对值取平均。
在验证条件上,误差从固定比例时的 3.79 个百分点降到了 1.79 个百分点。
作为对比,原研究模型在同样条件上的平均绝对误差为 2.82 个百分点,而且它在建立时用到了全部 20 组数据。
这项任务也体现了 EvoSim 的一个判断:当偏差呈现规律时,它会转去检查物理过程,而不是继续调参数。
换一个从未见过的温度,整段行车电压还能算准吗?
第二项任务,是预测车辆行驶时的电池电压。
车辆加速时,电池放电;制动时,电池回收能量充电。电流不停变化,电压也跟着波动。
电池管理系统是车上负责监测和控制电池的系统。它要靠准确的电压预测,来估计剩余电量、判断能输出多大功率,并让电压保持在安全范围内。
难点在于,电流一变,电池里几个过程的变化快慢不一。电极颗粒内部的锂浓度、电解液中的锂离子浓度、电极表面的电荷,变化速度各不相同。模型要同时描述好这些过程,才能把整段电压曲线算准。
研究使用的是马里兰大学公开的一块磷酸铁锂电池的测试数据,包括两种标准测试工况。
DST 是动态应力测试,电流在充电和放电之间快速切换。US06 是美国环保署制定的驾驶工况,包含高速和急加速。
数据覆盖 -10 至 50 摄氏度的 8 个温度,共 16 条完整曲线、109,746 个数据点。数据每秒记录一次,总时长约 30 小时。
EvoSim 的起始模型用四个变量描述电极状态,分别是正极和负极颗粒中锂的平均含量和表面含量。
EvoSim 重写了这四个变量随时间更新的计算方式,并在模型中加入了两个物理过程:锂离子在电解液中的迁移,以及电极表面电荷的积累和释放。
验证时,每次取出一个温度下的两条曲线,用其余7个温度的14条曲线做参数识别,再去预测取出的那两条。也就是说,模型要预测的,始终是参数识别时没见过的温度。
结果用均方根误差衡量,它反映整条预测曲线与实测曲线的平均偏离程度。30 摄氏度 DST 曲线的误差为 7.62 毫伏,20 摄氏度 US06 曲线为 8.97 毫伏。
其他研究在 DST 和 US06 工况下报告的电压误差,在 12.25 至 49.50 毫伏之间。论文据此认为,EvoSim 的精度超过了此前研究人员发表的模型。
能在没见过的温度下算准电压,说明模型描述的物理过程在不同温度下都成立,而不只是贴合了参与参数识别的那几条曲线。
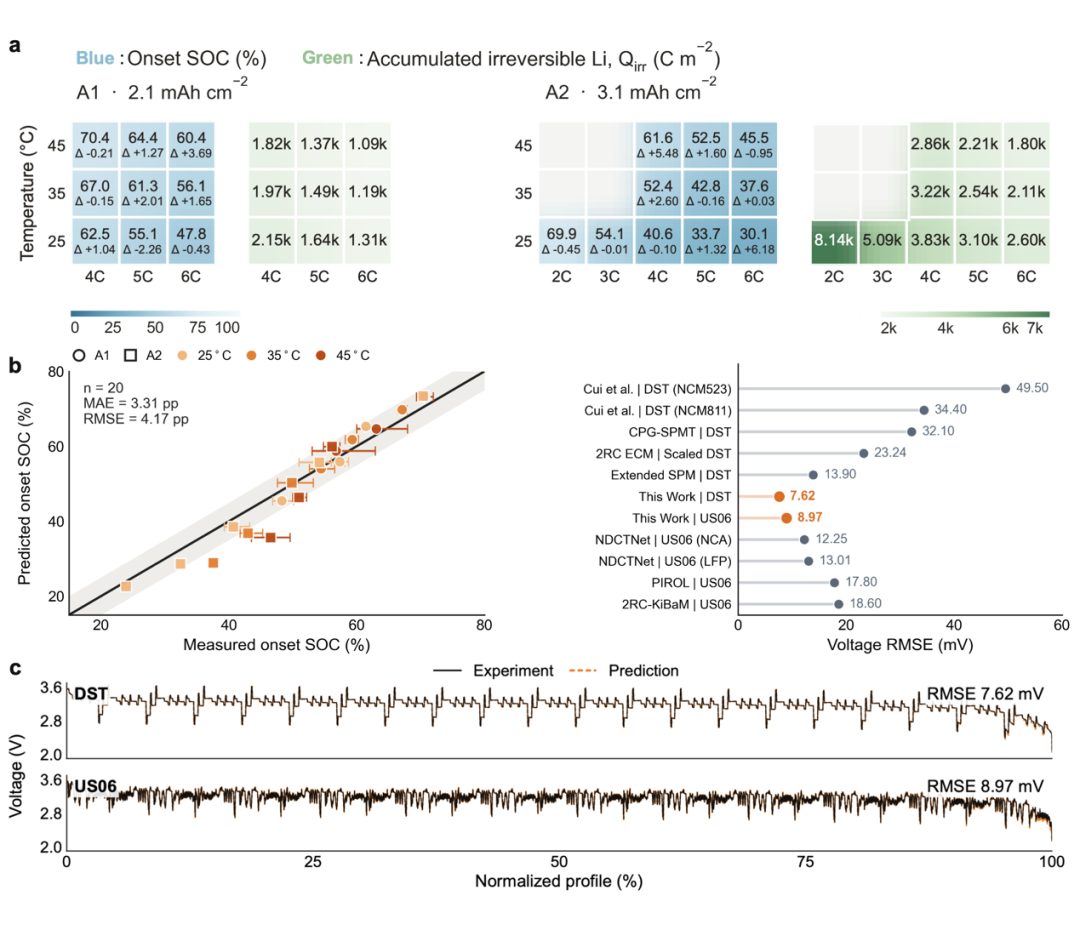
〓 图3. 析锂起点与动态电压预测:(a)两种电极设计在不同温度和倍率下的析锂起点;(b)20 个工况的实测与预测,以及电压误差与文献对比;(c)两个留出温度下的完整电压轨迹。图片来自论文。
在这项任务中,EvoSim 还碰到了一个计算错误。它解决这个错误的过程,正好说明了建模方法是怎样积累起来的。
一次纠错,改变了 AI 之后的建模思路
模型计算时,会把连续的时间切成每秒一步,每一步都根据当时的电流和温度更新电极状态。
早期模型虽然能算完,算出的电极状态却和作为参照的标准结果对不上,误差达到 88.518 毫伏。
EvoSim 查出问题出在每一步更新电极状态的公式上。改正之后,误差降到了 4.1136 毫伏。
它把这次修正整理成一条建模方法,写清了四件事:每一步更新用的准确公式,每一步该用哪个时刻的电流和温度,电极状态在仿真软件中如何设置,以及求解完成后要检查哪些输出。
这条建模方法到底有没有用?论文设计了一组对照实验。
三组实验做的是同一个任务:30 摄氏度 DST 曲线,共 7,461 个数据点。
三组的起始模型、数据、仿真软件和检查标准都相同,所用的大模型都是 gpt-5.5。每组最多提交 12 个模型,比较前 3 次提交的结果。
三组唯一的区别,是事先拿到的材料。第一组什么都没有;第二组拿到一份按时间顺序整理的过往尝试摘要;第三组拿到的是上面那条检验过的建模方法。
通过全部三项检查的模型,才算有效模型。
前 3 次提交中,三组最好的有效模型误差分别是 89.478、89.383 和 22.015 毫伏。
第三组在第 2 次提交时就拿到了这个结果,误差比第一组低 75.4%。第一组和第二组一直提交到第 12 次,最低误差都没有再下降。
差别就出在材料的内容上。第二组的摘要只写了“后来某个版本改成逐秒更新状态,误差降到约 4 毫伏”,没说具体怎么改。第三组的建模方法则写明了公式和检查项目。
可见,决定下一轮结果的,不是记住过去做过什么,而是把有效的做法整理成能直接照着执行的步骤。
这些建模方法也能用到别的任务上。
在一项同时考虑电化学反应和电池温度变化的建模任务中,EvoSim 用上了一条“先同时比较几种可能的物理机制,再修改模型”的方法。
这里的物理机制,指产生实验现象的物理过程。用上这条方法后,模型修改次数从 10 次减少到了 1 次。
论文还在 11 项建模任务上做了 45 组配对实验。每组中,同一个任务运行两次,一次不用积累的建模方法,一次用,其余条件完全相同。
结果显示,用上建模方法后,出现模型搭建错误或物理机制错误的运行从 33 次减少到 21 次,减少了 36.4%。实际运行时间也缩短了 42.6%。
不止于电池:一种能自我积累的科研方式
EvoSim 展示的,是一种让 AI 不断积累科研能力的方式。
实验数据指出模型解释不了的现象,EvoSim 提出新的物理解释并加以检验。每次研究中的成功和失败,又被整理成建模方法,留给下一次研究。
EvoSim 也会说明自己的结论在什么范围内成立。
在 9 项任务得出的结论中,有 4 条在全部测试条件下成立,4 条只在部分条件下成立。还有 1 条原本被认为普遍适用的物理机制,因为所有相关模型都没通过检验而被否定。这 9 个判断都与检验结果一致。
电池建模任务为这种方式提供了可以量化的检验,而 EvoSim 的这套研究流程并不针对某一种特定的电池模型。
下一步,研究者可以在材料科学、化学工程、生物工程等领域挑选具体问题来测试它,只要这些问题有实验数据,也有可靠的仿真软件。
对 AI 来说,理解材料和器件内部发生了什么,不只在于一次预测准不准,更在于能否根据实验数据不断完善自己的解释,并把行之有效的研究方法积累下来。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。