厦大等推出RoTA-Bench:交互式3D投影对齐基准,VLM距离人类还差得远
原创 CV君 2026-11-16 23:15 江苏
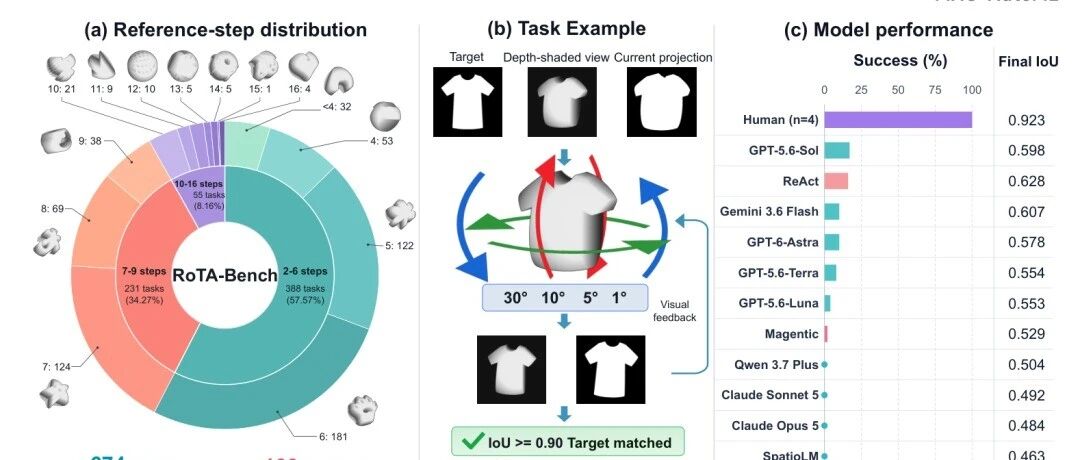
GPT-5.6-Sol成功率仅17%,人类达100%
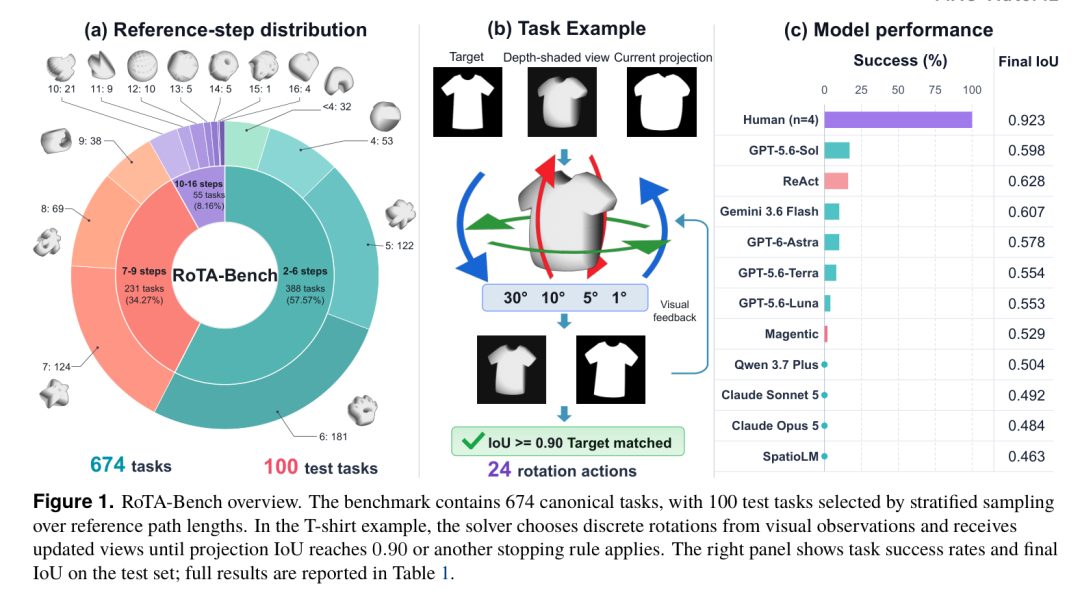
多模态大模型在各类图表问答、数学推理与通用视觉问答评测中屡创新高,但在需要将视觉输入转化为精确物理动作的具身交互与 3D 控制场景下,其真实能力仍然存疑。以往的静态基准往往只让模型针对静态单帧图像作答,完全剥离了动作执行与环境闭环反馈;而现有的交互式具身基准通常侧重于高层任务规划、代码调用或网格式离散路径搜索,往往掩盖了模型在纯三维姿态感知与精细操作上的能力短板。
针对这一问题,来自厦门大学与新加坡南洋理工大学的研究团队提出了一个交互式 3D 到 2D 投影对齐基准——RoTA-Bench。该基准要求智能体根据目标 2D 剪影轮廓与当前物体的视觉观测,在有限动作步数内通过交互式离散旋转,将三维物体精确调整回目标朝向(投影交并比 )。评测结果揭示了前沿模型与人类之间的显著差距:在相同的交互协议下,20 名人类参与者在 100 个测试任务中达成 100% 的成功率,而表现最佳的前沿商业模型 GPT-5.6-Sol 成功率仅为 17.0%,多款主流模型甚至完全无法完成任务(0% 成功率)。
背景与动机:从平面视觉到空间闭环控制
心理学与认知科学经典研究表明,空间感知是人类认知能力的重要基石,人类能够凭借心理旋转(Mental Rotation)维持物体在不同视点下的一致性,并能直接从二维投影轮廓中逆向重构三维几何结构。
然而,现有的空间推理评测体系存在两极分化:
静态问答基准:如 CLEVR、GQA、MMMU、MathVista 等,以单帧固定图像的问答为主,既无法支持动态动作交互,也缺乏动作执行后的闭环视觉反馈。
宏观具身交互基准:如 ALFRED、Habitat、WebArena、OSWorld 等,任务重心主要集中在高层语义规划、工具调用或二维界面坐标解析,其底层的移动和操作往往简化为预设的离散移动,并未深入考查模型直接基于连续 3D 姿态变化执行精细闭环控制的能力。
为了剔除接触摩擦、抓取可行性与平移漂移等复杂的物理干扰,RoTA-Bench 聚焦于刚体三维旋转这一纯粹且本质的维度。轴外三维旋转会引起非线性的轮廓形变、长宽比骤变与自遮挡现象,形成一种高度依赖空间几何洞察、无法简单依靠文本模态推理的视觉挑战。
方法详解:RoTA-Bench 的任务构建与闭环交互机制
任务定义与动作空间设计
在 RoTA-Bench 中,每个任务实例由位于坐标原点的刚体 3D 物体 、初始姿态 和规范目标姿态 组成。令 表示生成二值轮廓掩码的正交投影算子。在时间步 ,环境向智能体提供一个视觉观测三元组:
其中 为不变的目标正视图剪影轮廓, 为当前姿态的正交投影轮廓。为了补偿纯二值掩码缺失的单目深度与自遮挡线索,环境还在相同视点下渲染并提供了一幅带深度明暗着色的辅助视图 。
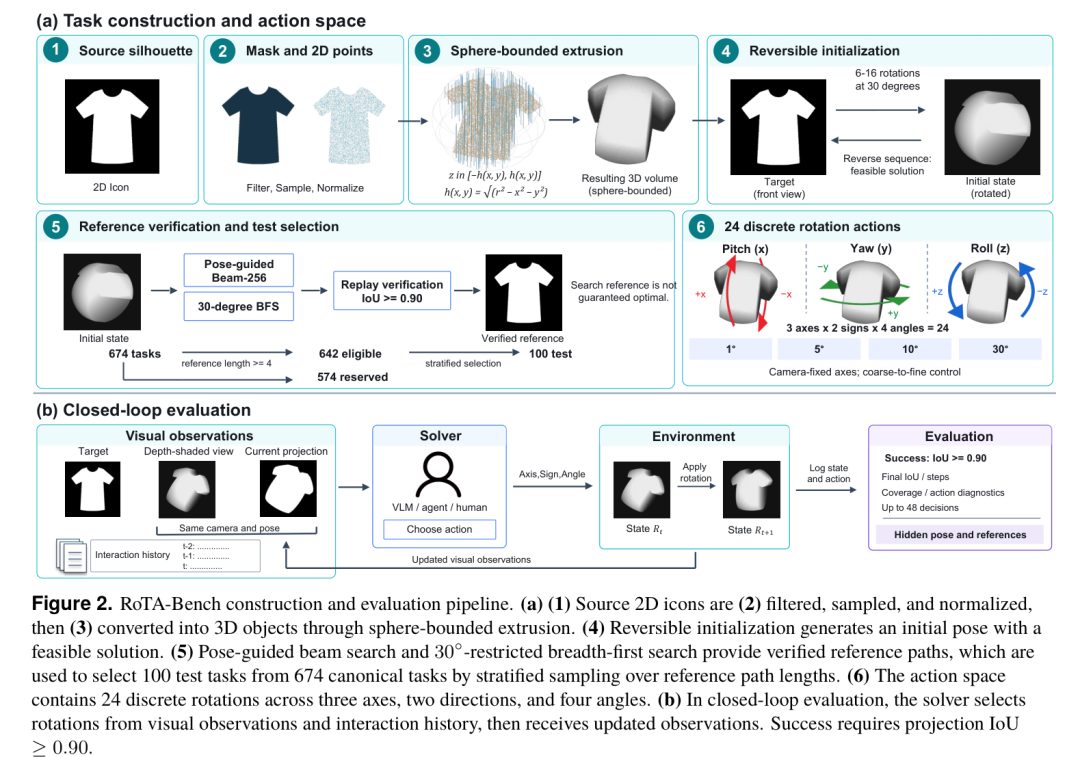
智能体的动作空间 由 24 个基于相机坐标系的离散旋转动作以及一个终止动作 STOP 构成。这 24 个动作涵盖:
三个主旋转轴:Pitch(上下俯仰)、Yaw(左右偏航)、Roll(图像平面内顺/逆时针滚转);
两个旋转方向:正向与负向;
四档步长梯度:,兼顾粗略朝向寻找与度级精细微调。
执行动作 后,物体姿态按 发生更新,环境重新渲染并返回更新后的观测视图。对齐质量采用投影交并比(Intersection over Union, IoU)衡量:
当 时判定任务成功;若步数达到 48 步上限、连续 12 步未刷新历史最高 IoU(停滞判定),或模型主动返回 STOP,则当前回合终止。
自动化构建管线与可解性保证
为避免模型利用预训练中见过的主流 CAD 模型或日常物品的先验语义走捷径,RoTA-Bench 设计了一套全自动几何生成管线:
- 球面约束拉伸:从高质量 2D 矢量图标库(Game-icons)中筛选连通且形态良好的轮廓点集 ,在半径 的圆盘内,沿深度轴施加球面包络进行对称拉伸:由于欧氏范数在旋转下保距,任意旋转姿态均满足 。这一数学性质在全局范围内消除了视口边缘裁剪与缩放歧义,同时确保物体沿深度正向投影时能完全复原原始 2D 图标的轮廓细节。
可逆初始化保证 100% 可解:从目标姿态 开始,随机施加 步 离散旋转生成初始姿态 (禁止相邻步立即反向)。根据 群的严格可逆性,执行初始化序列的逆序列必然能回到目标姿态,从构造上数学保证了每个任务完全可解。
参考路径搜索与分层抽样:通过姿态引导的 Beam-256 搜索与 约束的广度优先搜索(BFS),生成比逆初始化更短的验证参考路径。最终,管线自动生成了 674 个规范任务,并按参考路径长度分层抽样,固化出 100 个具有代表性的评测测试集。
几何诊断指标与对称性补偿
在评测中,底层环境还会实时计算物体的对称性调整姿态误差(Symmetry-adjusted Pose Error):
其中 为通过数值采样与反射变换自动推断出的物体等效对称姿态群。该姿态误差对智能体完全隐藏,仅作为后台诊断工具。此外,论文将旋转动作拆解为方向(Axis + Sign)与角度(Angle),统计有效方向率(Effective Direction Rate,即至少存在一种步长能降低姿态误差的方向占比)、最佳合法角度率、角度间隙(Angle Gap)以及角度选择不当带来的几何损失(Angle Loss)。
实验结果与深度诊断:前沿模型为何受挫?
评测涵盖了 9 款主流视觉语言模型(GPT-5.6-Sol、GPT-6-Astra、Gemini 3.6 Flash、Claude Opus 5、Claude Sonnet 5、Qwen 3.7 Plus、SpatioLM 等)、2 种基于 GPT-5.6-Sol 的智能体架构(ReAct、Magentic)、20 名人类高校受试者(累计完成 400 次测试运行),以及两种启发式贪心基线。
1. 人机性能对比与贪心基准线启示
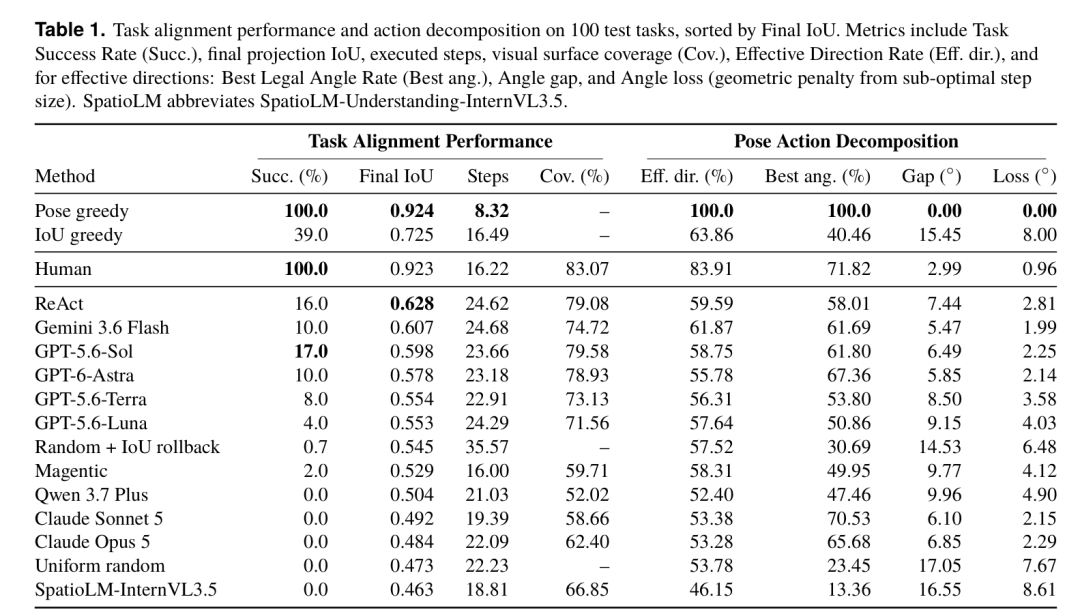
从表 1 可以看出,前沿商业模型在闭环 3D 投影对齐任务上面临明显瓶颈:
GPT-5.6-Sol 取得了模型中最高的成功率,但仅为 17.0%(最终均值 IoU 0.598);ReAct 智能体框架取得了模型中最高的最终 IoU(0.628),成功率为 16.0%;Gemini 3.6 Flash 与 GPT-6-Astra 成功率均为 10.0%。
Claude 系列与开源多模态大模型 Qwen 3.7 Plus 在该任务上成功率均为 0.0%,最终 IoU(0.484–0.504)几乎与完全随机策略(0.473)持平。专门针对空间智能微调的 SpatioLM-InternVL3.5 则出现了策略退化,超过 91% 的动作机械性输出单一旋转,最终 IoU 仅 0.463。
形成鲜明对比的是,人类受试者在 400 次运行中全部成功,成功率达 100.0%,平均仅需 16.22 步即可达成 0.923 的平均最终 IoU。
贪心基准线揭示深层矛盾:如果每一步都选择使底层真实 3D 姿态误差最小的动作(Pose-greedy),不仅能以 100.0% 的成功率通关,平均更只需 8.32 步;但若每一步仅贪心追求当前 2D 投影 IoU 最大化(IoU-greedy),成功率便骤降至 39.0%(最终 IoU 仅 0.725)。这表明,仅仅贪心增加二维剪影重合面积极易陷入局部极值,无法保证三维空间的正确收敛。
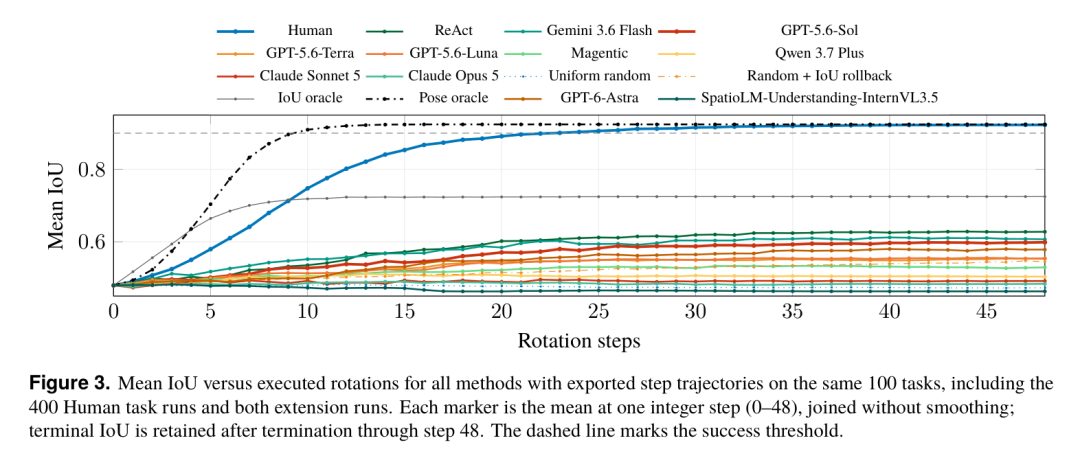
从图 3 的轨迹变化可以看出,人类在交互过程中 IoU 持续稳步上升并顺利越过 0.90 的成功阈值,而绝大多数模型在 15 步左右便在 0.50–0.63 区间陷入停滞。
2. 模型并非“没看见”,而是“不会转”
模型失败是否源于视觉探索不充分?通过对表面可见性覆盖率(Surface Coverage)的统计,GPT-5.6-Sol 的累积表面覆盖率达到了 79.58%,与人类的 83.07% 相当,GPT-6-Astra 亦达 78.93%。这说明模型在交互过程中已经观察到了物体的大部分表面。
真正的症结在于动作分解层面的双重缺陷:
方向选择薄弱:人类选择有效旋转方向的概率高达 83.91%,而 GPT-5.6-Sol 仅有 58.75%(仅比完全随机选择的 53.78% 高出约 5 个百分点)。
步长控制粗糙:在选对方向的前提下,人类选择的角度与最优角度平均仅相差 2.99°,而 GPT-5.6-Sol 的角度间隙达 6.49°,导致每步因步长不佳平均产生 2.25° 的额外几何损失(Human 仅为 0.96°)。
3. 图像空间与姿态空间的背离
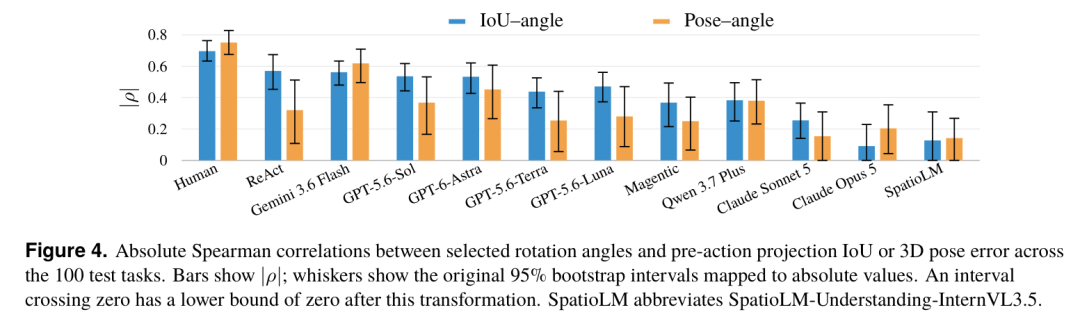
进一步分析智能体在决策时究竟依据的是“2D 剪影重合度”还是“底层 3D 姿态差异”。如图 4 所示,绝大多数模型选择的旋转角度与动作前的 2D IoU 关联更强,而与真实 3D 姿态误差关联弱;人类则在两方面都保持了强相关( 分别达 0.696 与 0.751)。
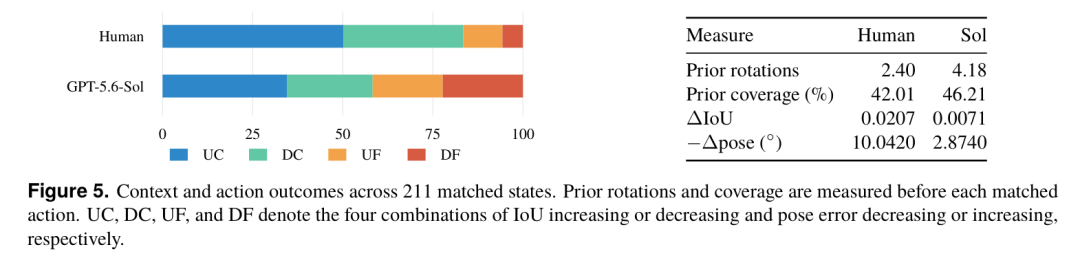
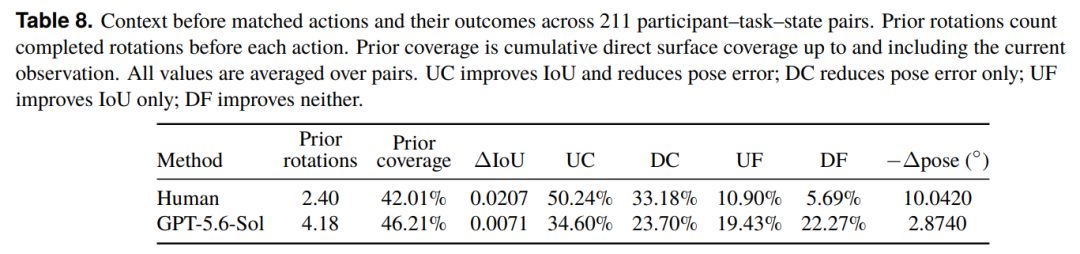
为了更严谨地对照,研究人员提取了人类与 GPT-5.6-Sol 处于完全相同 3D 姿态的 211 个匹配状态切片进行深入比对(此时双方的历史表面覆盖率接近,分别为 42.01% 和 46.21%):
UC(两全其美,IoU 提升且姿态误差下降):人类占比达 50.24%,GPT-5.6-Sol 为 34.60%;
DC(以退为进,IoU 下降但姿态误差下降):人类有 33.18% 的动作属于此类,而 GPT-5.6-Sol 仅有 23.70%。这表明人类在操作中表现出了更强的全局推演意识,愿意为了接近真实的 3D 目标而容忍局部的 2D 轮廓重叠下降;
UF(假性优化,IoU 提升但姿态误差上升):GPT-5.6-Sol 此类动作占比高达 19.43%,接近人类(10.90%)的两倍。模型更容易为了让 2D 轮廓看起来更像目标而误入歧途,反而增大了三维空间偏差;
DF(全面恶化):GPT-5.6-Sol 高达 22.27%,而人类仅为 5.69%。
4. 交互历史对微调精度的决定性影响
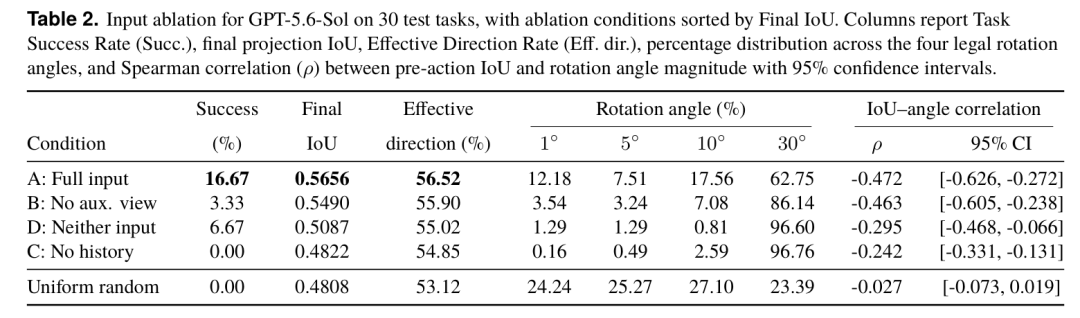
在针对输入模态的消融实验中(表 2):
移除带单目深度的辅助视图后,成功率从 16.67% 跌至 3.33%;
而移除多轮交互历史(No history)的影响更为剧烈,模型成功率直接清零(0/30),最终 IoU 跌至 0.4822。 更关键的技术发现是,去掉交互历史后,有效方向选择率几乎未变(54.85% vs 56.52%),但模型的旋转角度分布发生了剧烈畸变: 粗粒度大步长动作占比直接飙升至 96.76%,而 精细微调动作从 12.18% 断崖式降至 0.16%。这表明,多模态大模型之所以具备一定的微调微操能力,并非来自单帧图像对空间姿态差的直接测度,而是高度依赖在多轮历史中比对“上一动作为轮廓带来的微小形变梯度”。
真实网格上的泛化验证
为了验证在矢量图标拉伸几何体上的评测结论能否推广至真实三维物体,研究人员额外从 Poly Haven 资产库中构建了 30 个基于真实日常三维网格(具有完全匹配的参考解步长分布)的测试集。
在真实三维网格上,GPT-5.6-Sol 的最终平均 IoU 达到 0.7179,成功率微升至 20.0%(6/30),性能表现优于抽象拉伸几何体。这提示从矢量图标拉伸出的非日常几何体确实削弱了模型预训练中积累的特定语义捷径,能更纯粹地压榨出视觉模型底层的三维几何推理与闭环空间控制水平。
写在最后
RoTA-Bench 针对多模态大模型的空间智能评测提供了一种新范式:它不仅将传统的“看图答题”推进为“基于视觉反馈的连续闭环操作”,更在几何机制上精巧地解耦了复杂的动力学扰动,直击空间旋转感知与控制的核心。
实验结果给从业者带来了清醒的启示:即使是当前最顶尖的视觉语言模型,在面对需要从二维轮廓形变逆推三维空间姿态、并执行精细角度微调的任务时,依然显得相当脆弱。图像空间层面的相似度贪心并不等价于真实三维空间的姿态对齐。未来,如何利用此类自动化交互环境引入强化学习闭环微调(Reinforcement Learning Fine-Tuning, RLFT),让多模态模型真正学会将视觉观测转化为稳健的三维空间动作控制,将是通向高可靠具身智能的关键一步。
论文标题: RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
机构: 厦门大学、新加坡南洋理工大学S-Lab
Hugging Face:https://huggingface.co/papers/2610.17665
在线 Demo:https://www.modelscope.cn/studios/san2333333/rotabench-anon?mode=full&app_path=%2Fportal
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。