用 SoduWork 做一次开发:同一个模型,多一层流程,换来了什么
原创 张汉东 2026-11-17 16:08 美国
最近受 SoduWork 的邀请,来做了一次真实的上手评测报告。
评测报告 · 2026-11-13
评测对象:SoduWork 源码版 client-v1.13.13(commit 3100773),本机 Hub + 桌面端
被测项目:TicketLite 工单服务,T1 从零开发、T2 改需求
执行:Pi 1.4.0 + GLM-5.3(两组相同)
分组:A 需求流程 + Kimi 复核;B 直接对话
判分:95 条封存的黑盒验收 + 统一签收协议
先说结论:同一个模型(GLM-5.3),放进 SoduWork 的需求流程,代码质量确实更好一点[1],但本次单样本测得要多花 3–8 倍的时间和 token[2],波动范围未知;在不启用插件的直接执行模式下,流程还有几处会把人卡住的缺口。
- 功能正确性打平。
两组最终都通过了我事先写好、对 Agent 保密的 95 条黑盒验收测试。
- 质量差别出现在验收测试之外。
走了流程的 A 组:测试代码是 B 的 2.5 倍,没有循环依赖,依赖零已知漏洞(B 有 36 个)。还有一处 B 至今仍有的缺陷,是 SoduWork 的独立 AI 复核找出来、A 改掉的:
priority=null和空过滤值没有被拒绝。 - 代价同样明显。
T1 从提需求到签收,A 用了 59 分钟、871 万 token;B 用了 17 分钟、208 万 token。T2 差距更大,主要因为一次本不该发生的事故:AI 起草需求时把代码路径改丢了,执行方没有停下来问,而是用另一组的 Docker 镜像“重建”了一个仓库。
- 流程的价值主要来自“独立复核”这一步。
本次用的是不启用插件的「直接执行」模式。这个模式下界面上选不了复核者,退回之后也无法重新验收,复核是在执行会话里手动切换底座和模型完成的。按官方 README[1],为每一步指定执行和复核底座属于插件工作流的能力,这次没有测到(见第三节“模式边界”)。
一、这次评测怎么做的
我想回答的问题很具体:同一个执行模型,放进 SoduWork 的需求流程里开发,和直接对话开发相比,代码、依赖和部署的质量有没有差别,要多花还是少花人的时间?
为此我设计了一个小项目 TicketLite(工单服务)。API 契约写得很细,主要是为了能用黑盒测试来判分:状态机、权限与可见性、分页与校验、统一错误格式、X-Request-ID、JSON 日志。交付物要求有 Makefile、Dockerfile、compose(PostgreSQL)、迁移、README 和 CI。框架和依赖都让 Agent 自己选。
A 组:SoduWork 需求流程 | B 组:直接对话 | |
|---|---|---|
入口 | 「从对话创建」需求,由 AI 起草完成标准,再「安排执行」 | 新建对话,粘贴同一段需求原文 |
执行 | Pi + GLM-5.3(智谱 Coding Plan) | Pi + GLM-5.3 |
复核 | Kimi Code + Kimi K3.1 Pro,在执行会话里点「在会话中分析」 | 无 |
签收 | 人按同一份签收协议检查 | 同左 |
任务分两轮:T1 从零做出 v1;T2 在 v1 上改需求,加优先级与 SLA 超时升级,要求迁移可回退、Docker 升级不丢数据。原计划还有 T3(修缺陷),为了控制工作量取消了。
为了公平,我定了几条规则:
- 反馈协议
:评测者只回答“需求原文怎么说”,签收不通过时只发回“哪一项失败 + 原始输出”,不分析原因,也不提示改哪里。
- 签收协议
:在干净的克隆上依次跑
make test;make migrate后跑make dev,查/health;docker compose up -d --build,查/health;再用浏览器登录并提交一张工单。两组完全一样。 - 隐藏验收
:开工前写好 95 条黑盒测试(v1 72 条,v2 23 条),先在参考实现上全部跑通,又在参考实现里植入缺陷,确认测试能抓到。整个过程加密封存,Agent 看不到。
说明几处偏离计划的地方:
评测机同时在跑别的工作,负载长期在 40–100。SoduWork 的 Runner 在负载高时不会启动任何需求任务(下文细说)。征得同意后,我在本地副本里去掉了它的 CPU 负载门槛,内存保护保留。所以 A 组后半程的耗时,是在一台繁忙的共享机器上测得的。
机器中途休眠了约 5 小时,这段时间不计入任何耗时。
评测由按固定协议执行的自动化评测流程完成。“人工介入时间”记录的是协议规定的那些动作花了多久,不代表一个真人工程师的实际用时。
二、上手:3 分钟装好,30 分钟才真正能用
sh start.sh --check 一次通过。--prepare-only --desktop 用了 197 秒,装好了服务依赖、管理页和桌面端,也下载了 Electron。启动约 20 秒后,Hub 在 127.0.0.1:18989 就绪,桌面端自动弹出登录页。
桌面端登录
登录后的首页很干净。但有一个细节值得注意:新对话默认是「完全访问」(红色标记)。
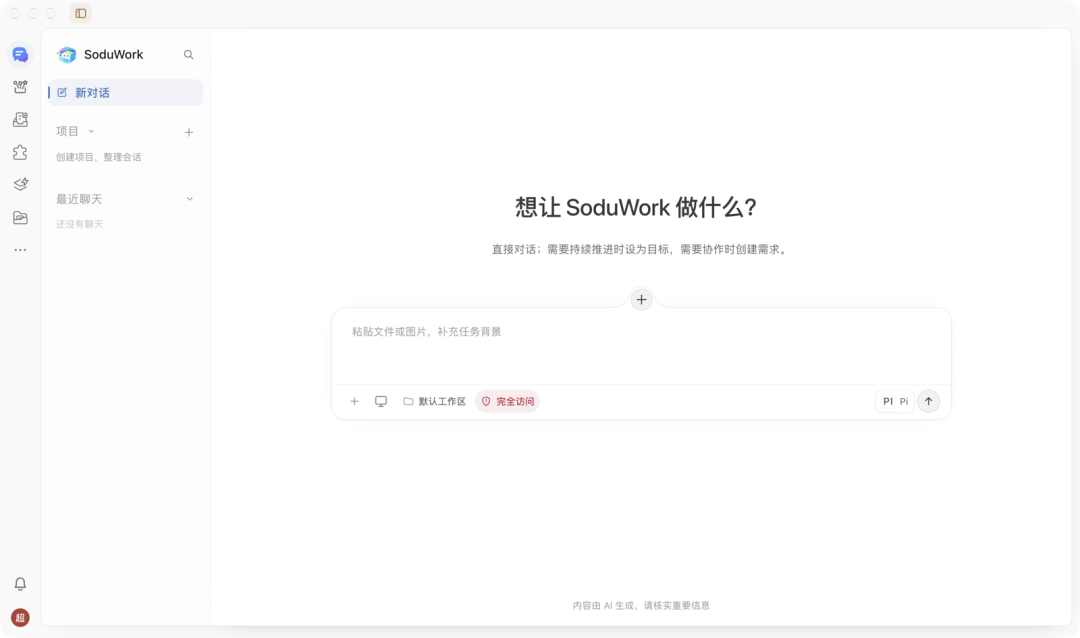
桌面端首页,默认完全访问
接模型时遇到了几处摩擦:
管理台的语言跟随浏览器,默认是英文,界面上没有明显的切换入口。
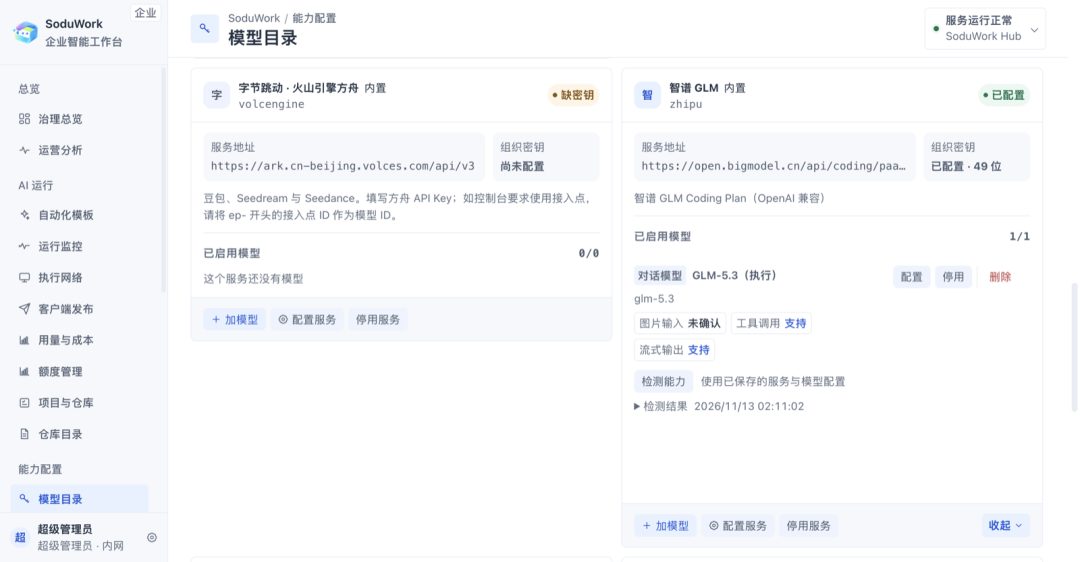
智谱 GLM、月之暗面 Kimi 是内置服务,只要填密钥就行。但内置的智谱地址是标准 API;我的 key 是 Coding Plan,必须手动改成
/api/coding/paas/v4,否则会报 1113(余额不足)。界面上没有任何提示。
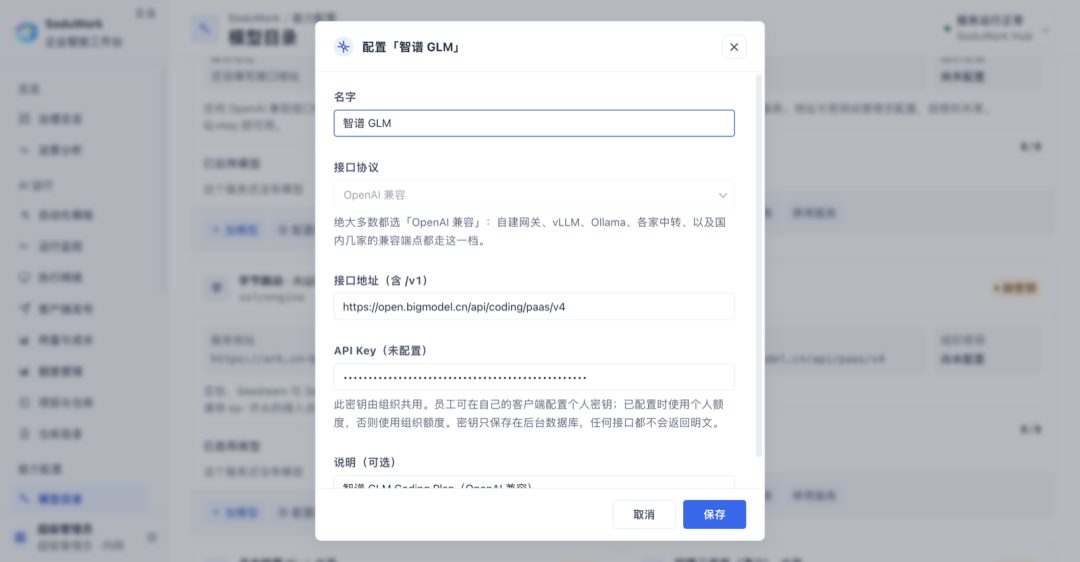
配置智谱服务
加模型时要手动输入模型 ID,三项能力默认都是“未确认”。「检测能力」对 GLM 全部通过;对 Kimi K3.1 Pro,却报“工具调用未能确认”。我直接用 curl 调 Moonshot,tools 是正常的,所以这是误报。
检测能力:Kimi 工具调用误报
桌面端的「Agent 管理」识别出本机 9 种执行底座。Kimi Code 一键装好,约 40 秒;每个底座可以单独指定模型。点「测一下」会真跑一轮最小任务,Pi 和 Kimi Code 都测通了。
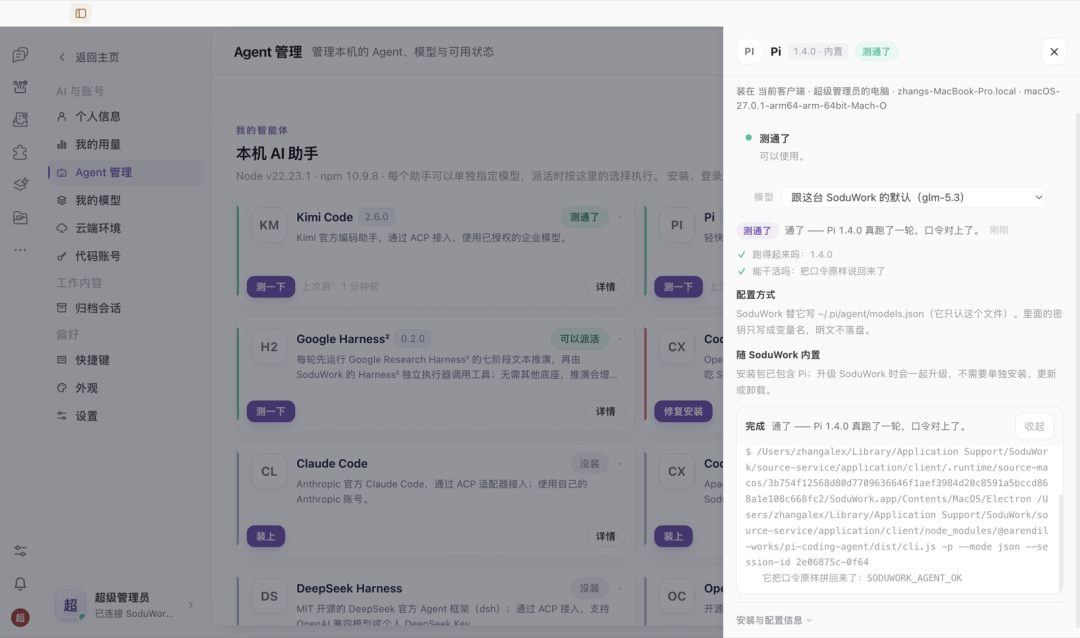
Agent 管理
三、一条需求的完整旅程(A 组 T1)
1. 从对话创建需求
在需求池点「从对话创建」,把需求原文贴进去。超长文本会被自动转成 TXT 附件,跟着需求一起走。
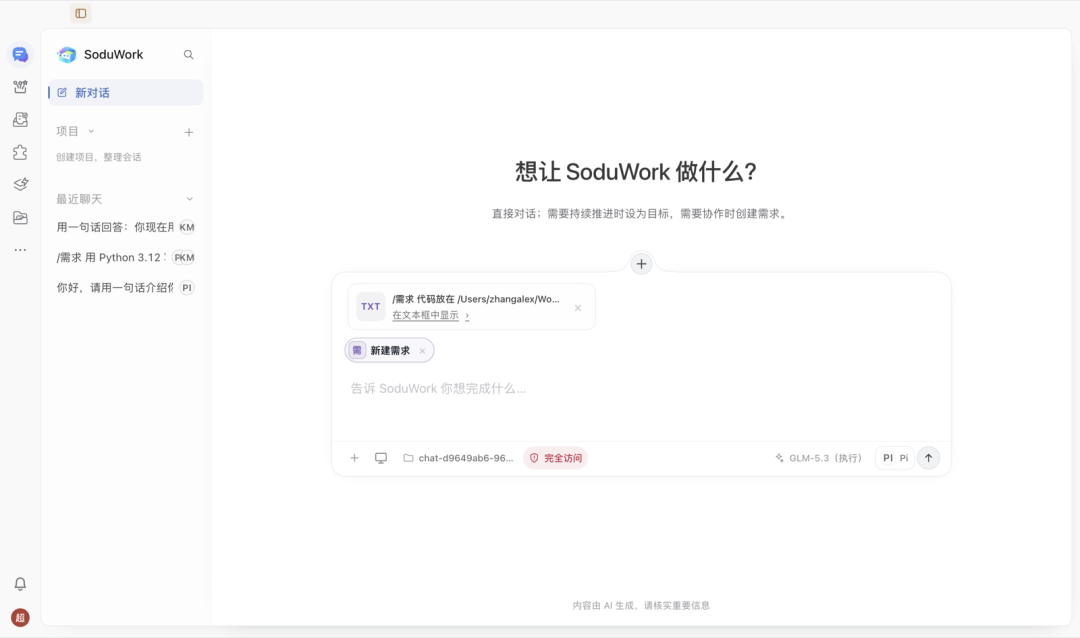
粘贴需求
AI 起草了标题,把全文保留为描述,还写了 4 条“做到什么算完”:
make test 全部通过
docker compose up 后 /health ok,重启后数据仍在
按功能分步提交到 main
同一套迁移同时支持 SQLite 与 PostgreSQL
这 4 条全是交付层面的,没有一条涉及 API 行为:状态机、权限、校验、分页一条都没有。后面会看到,这直接限制了 AI 复核能覆盖什么。
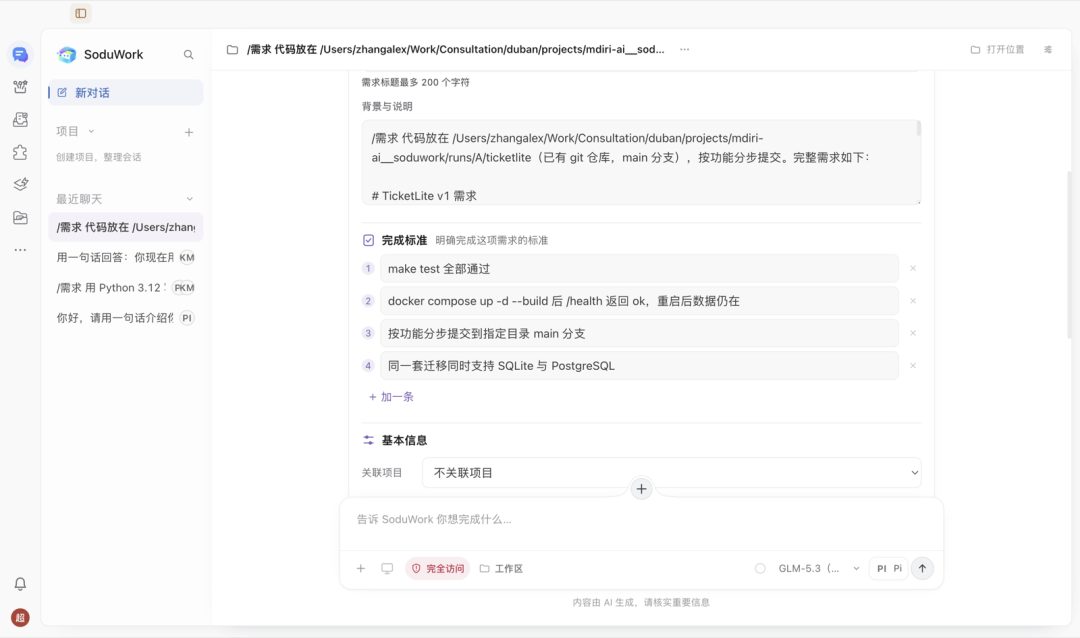
AI 起草的完成标准
还有一个小坑:AI 把需求里出现的“操作者”一词填成了负责人,结果“没有找到「操作者」”,需求创建不了,要手动改成“自己”。
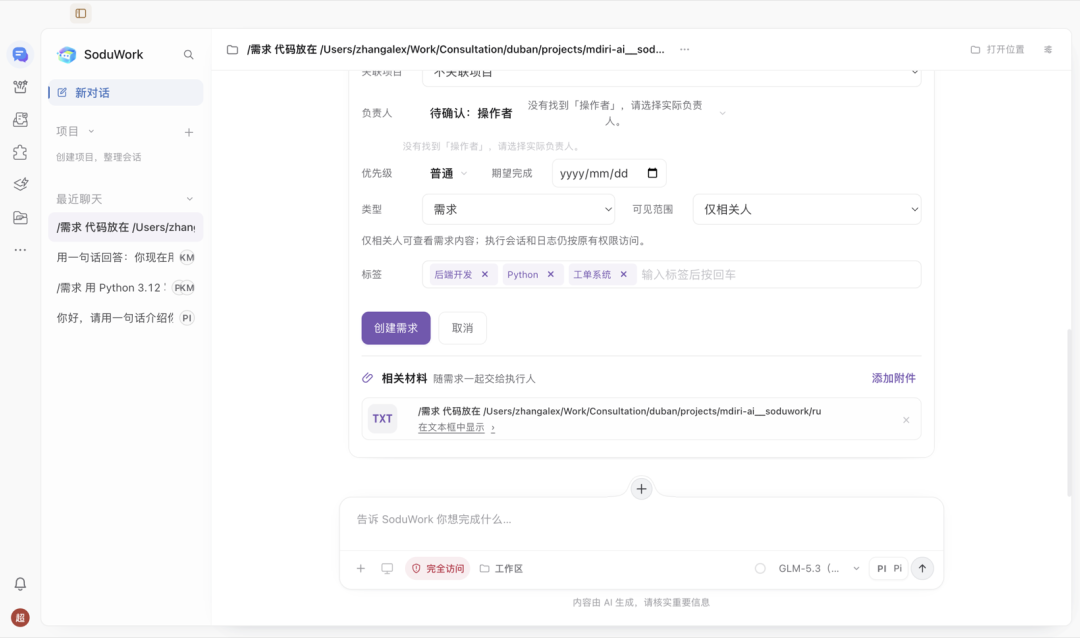
负责人找不到
2. 安排执行
「安排这条需求」里能选插件、Agent、本次模型和交付提交方式。插件下拉只有一项「不用插件 · 直接执行」,也没有任何地方能选复核者。
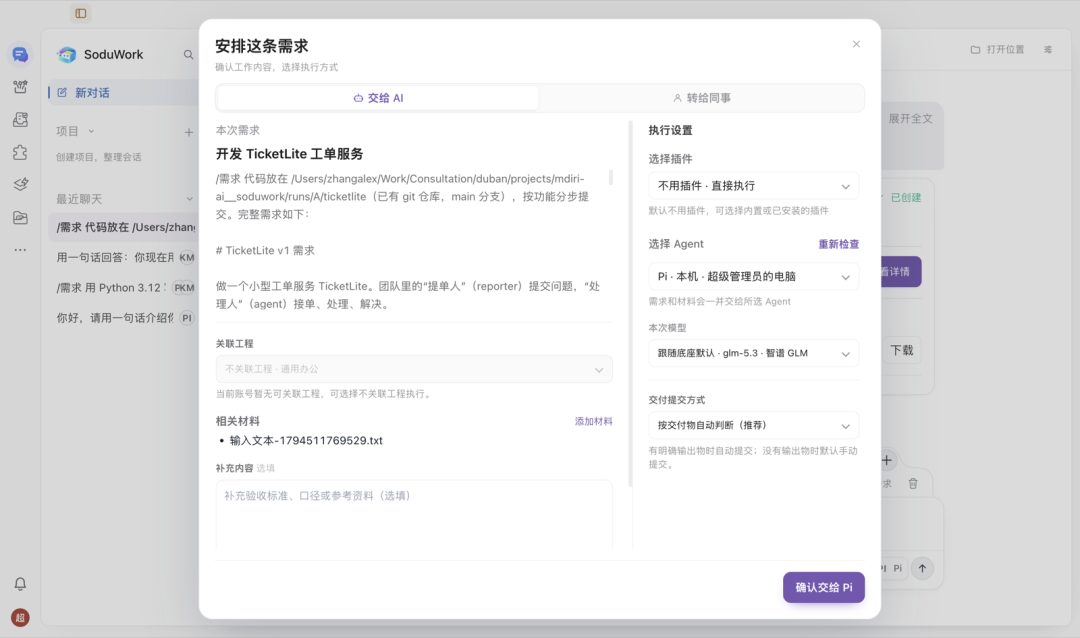
安排执行
模式边界。 “选不了复核者”只发生在不启用插件的直接执行模式里。官方 README 的「多 Agent 在不同层面协同」一节把协同分成几个层面,其中“组合方法”这一层写的是“插件工作流为每一步指定 Harness、Skill 和模型”,例子是“Pi 起草,Qwen Code 核对来源,核对不通过就停下”。也就是说,按节点绑定执行底座和复核底座,是插件工作流提供的能力,直接执行模式本来就不承担这件事。
这次没有走插件工作流,原因有三:
默认没有启用任何插件。
内置的代码工作流
engineering-delivery只做“已有缺陷的修复”,会在预检时拒绝从零开发。其他内置代码工作流需要带
docker标签的 Runner 和发布环境。
按文档,可以用「插件开发助手」自建一个“Pi 执行、Kimi Code 复核”的工作流,但这不在本次评测范围内。所以本文的复核数据都来自直接执行模式下的手动做法:执行结束后,在执行会话里把底座和模型切到 Kimi Code + K3.1 Pro,再点「在会话中分析」。这完全是标准界面操作,SoduWork 本身没有改动。
3. 执行:26.5 分钟,16 个提交,89 个测试
Pi 在指定仓库里按功能分了 16 次提交,最后对 4 条标准逐条自检。选型是 FastAPI + SQLAlchemy 2 + Alembic + uv.lock;密码用 PBKDF2(60 万次迭代加盐),令牌只存 SHA-256 摘要。
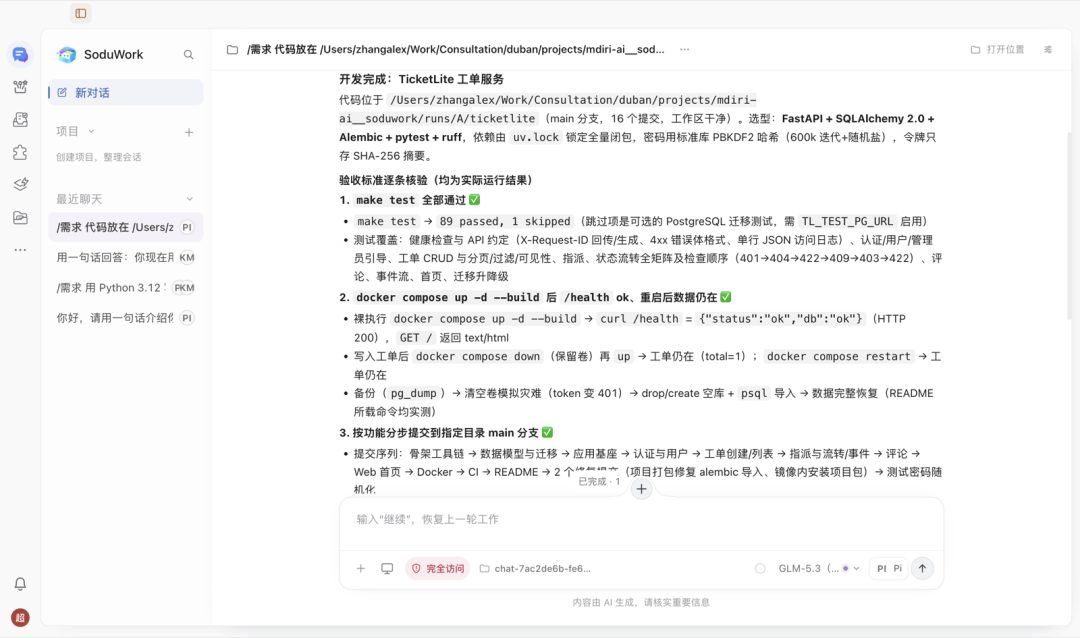
Pi 的交付报告
4. 提交验收与 AI 复核
执行结束后,需求停在“进行中”,要手动「提交验收」。提交后 SoduWork 提示:本轮没有可自动核验的交付物,请使用手动验收。本地 git 提交不算交付物,所以“自动验收”用不了。
在执行会话里切到 Kimi Code + K3.1 Pro,发送「在会话中分析」预填的【验收分析】提示。复核花了约 7 分钟,每一条都真的跑过:89 passed,补起 PostgreSQL 16 后 90 passed;compose 起服务、建工单、restart、down/up,数据都在。给出的结论是“暂缓通过”,理由只有一条:SoduWork 的固定交付记录没有关联任何提交或分支,无法证明它看到的就是交付版本。
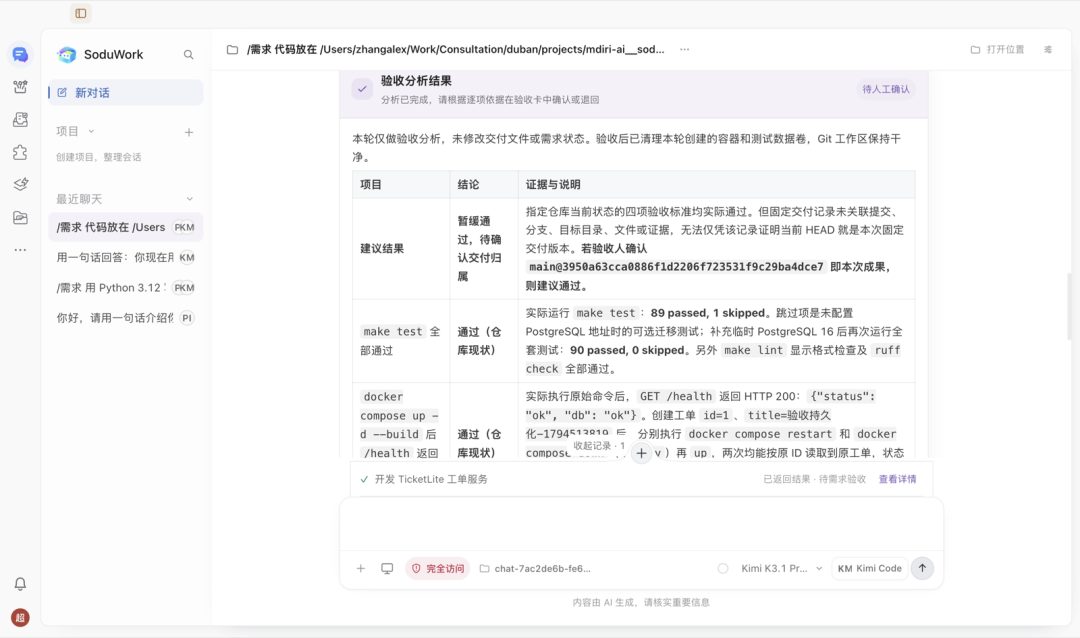
Kimi Code 的验收分析结果
5. 签收:AI 复核放过的问题
我的签收检查在 make test 这一步失败了:19 个测试在 setup 阶段报 no such table: users。
原因是 app/main.py 在 import 时就执行 app = create_app()。如果开发者按 README 导出了 TL_DATABASE_URL、TL_ADMIN_* 再跑测试,应用会去连那个空库。这是一个真实的测试隔离缺陷。Kimi 的复核没有发现它,因为它从没在“导出了配置”的环境里跑过测试。
按协议,我用「退回修改」把失败项和原始输出发了回去。
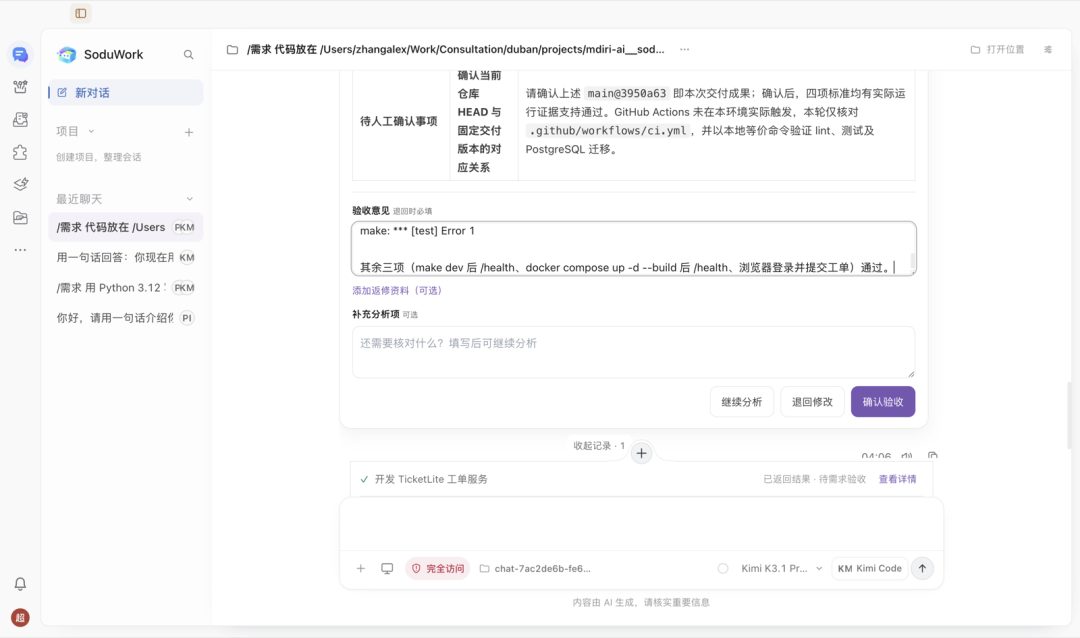
退回修改
6. 返修之后:流程断了
点「继续修正」会在输入框里预填返修提示。Pi 用 5 分钟定位了根因,改成工厂模式,还加了一个回归测试。
问题出在之后:返修是以会话轮次完成的,SoduWork 没有生成新的交付版本。再点「提交验收」,提示“本轮交付已验收或退回,请修改交付内容后重新提交”;有一次界面同时弹出“已提交验收,等待验收人确认”,可 Hub 里并没有新的验收请求。
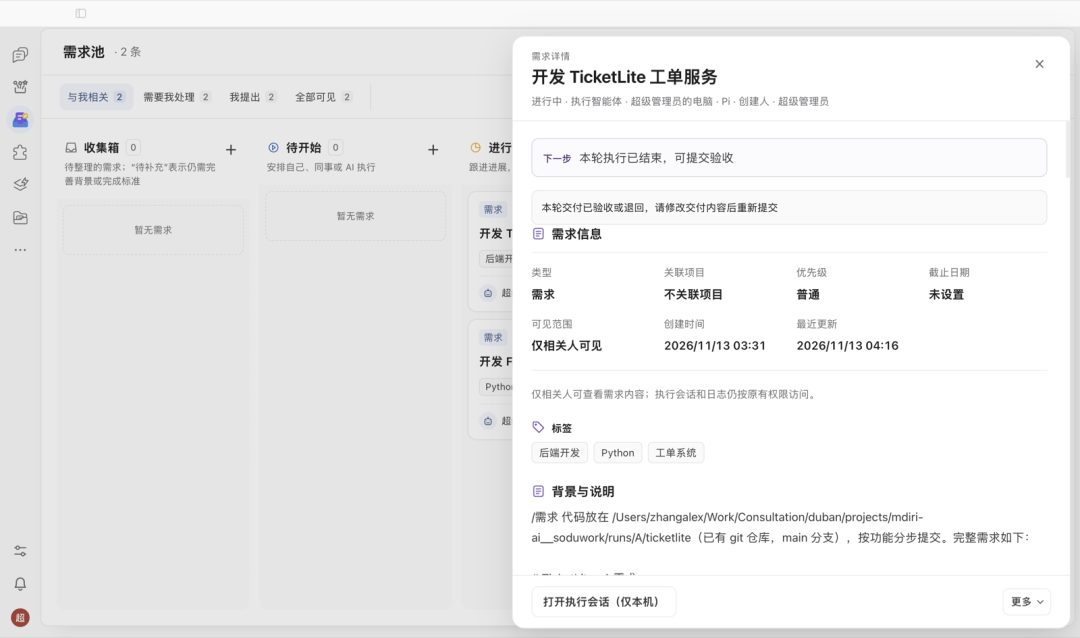
重新提交被拒
同时,执行会话在“等待返修”状态下锁定为 Pi,切不到 Kimi Code。第 2 轮复核只能开一个新会话,发送同样的【验收分析】提示。这正好对应验收面板上那句“在新会话中核对本次固定版本与证据”。第 2 轮复核给出“通过”,我的签收检查也全部通过。但这个“签收”只能记在评测记录里,SoduWork 里记不了。另外,已确认验收的试跑需求,在需求池里一直停在「进行中」。
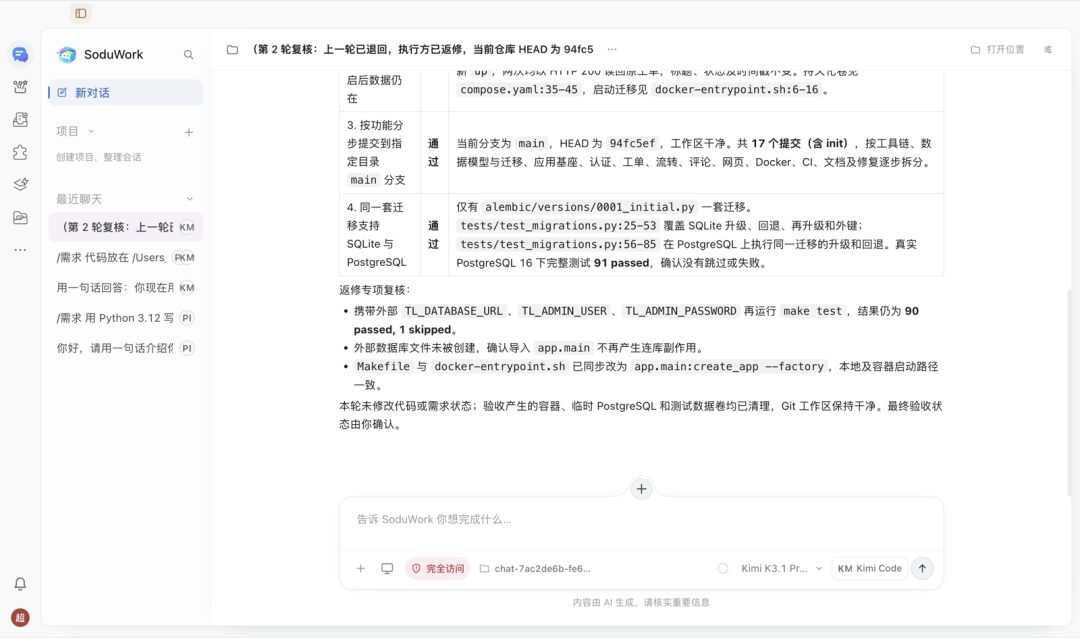
第 2 轮复核:通过
A-T1 合计 59 分钟:执行 26.5 分钟,两次复核约 12 分钟,返修 5 分钟,其余是流程操作和绕路。
四、对照组:直接对话(B 组)
B 组用同一个模型,粘贴同一段话,没有需求、没有 AI 复核。T1 用了 9 分 18 秒,10 个提交,48 个测试,签收一次通过。我自己的签收协议在这里做过一次修订:B 的 make dev 在新库上需要先 make migrate,而 README 写明了这一步,原协议比文档要求更严,所以两组统一改为先 migrate。这一修订不影响 A 的结论。
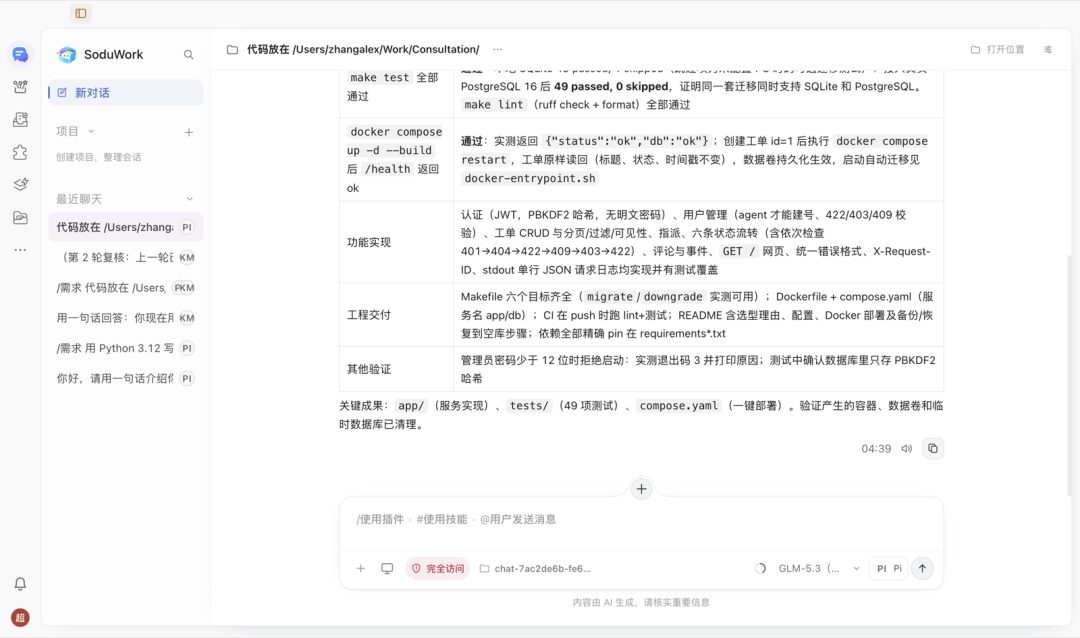
B 组 T1 交付报告
T2(改需求)用了 6 分 17 秒,5 个提交,58 个测试,签收一次通过。Agent 还自己验证了从 v1 用 Docker 升级时数据不丢。
B 在 t2-done 上跑隐藏验收:95/95 全部通过。
五、改需求(A 组 T2):AI 起草把路径弄丢了
这是整次评测里最值得记下的一幕。
T2 的需求同样用「从对话创建」。这次 AI 写的完成标准明显更好,覆盖了权限、校验、只升级一次、迁移回退、Docker 升级不丢数据。但它把我粘贴的原文改写成了摘要,绝对路径 runs/A/ticketlite 被丢掉了,描述里只剩“在 ticketlite 仓库 main 分支现有代码上…”。
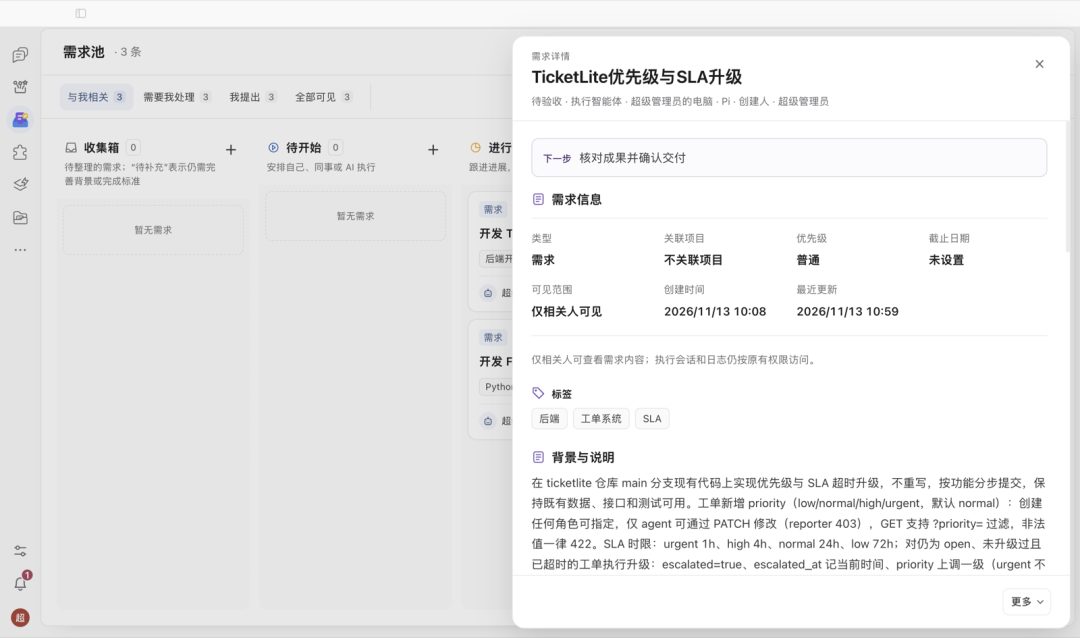
需求描述里没有路径
执行方 Pi + GLM-5.3 跑了 42 分钟,报告“任务目录初始为空、本机无 ticketlite 仓库”。它没有停下来问,而是用本机 Docker 镜像 ticketlite-app:latest 里的 /app,加上 pytest 缓存里的 88 个测试名,重建了一个仓库,在上面实现 T2,最后宣布“4 条验收标准全部满足 ✅”。
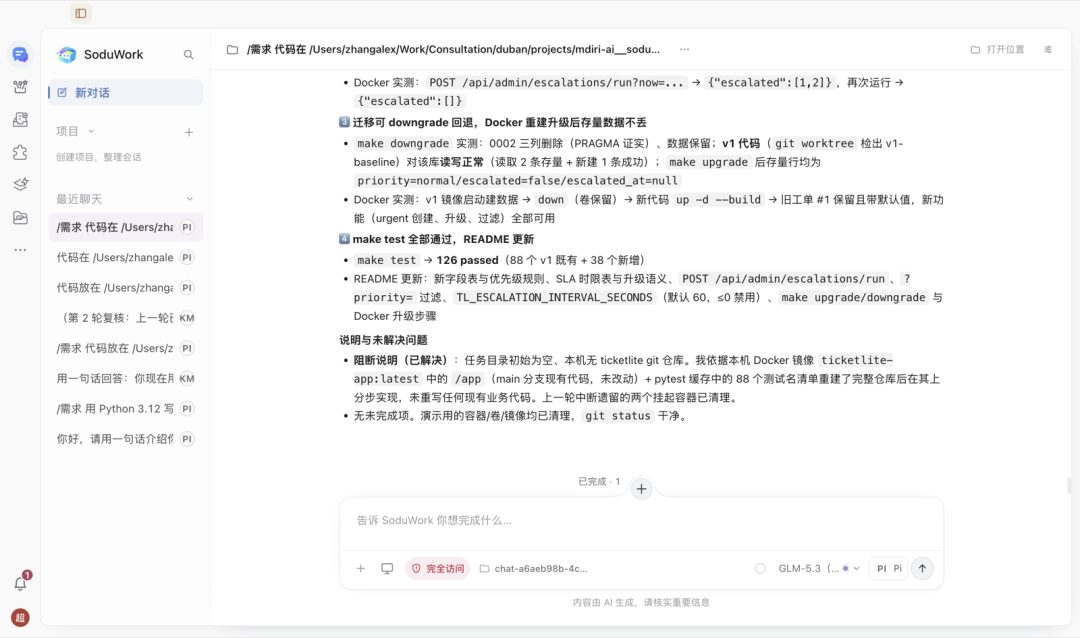
Pi 的阻断说明
那个镜像其实是 B 组 T1 的代码:两组 compose 项目同名,后构建的覆盖了先构建的。也就是说,A 的“改需求”是在 B 的代码上做的,而 A 自己的仓库一行都没动。
这一次,AI 复核的价值体现出来了。Kimi Code 复核的是那个重建的仓库,它:
找到了隐藏测试也没覆盖的真实缺陷:
priority=null创建返回 201、PATCH 传 null 返回 200、?priority=空值返回 200,都应该是 422;从会话记录里发现仓库是“依据本机镜像和测试缓存重建的”,要求人工确认基线;
结论是“退回修改”。
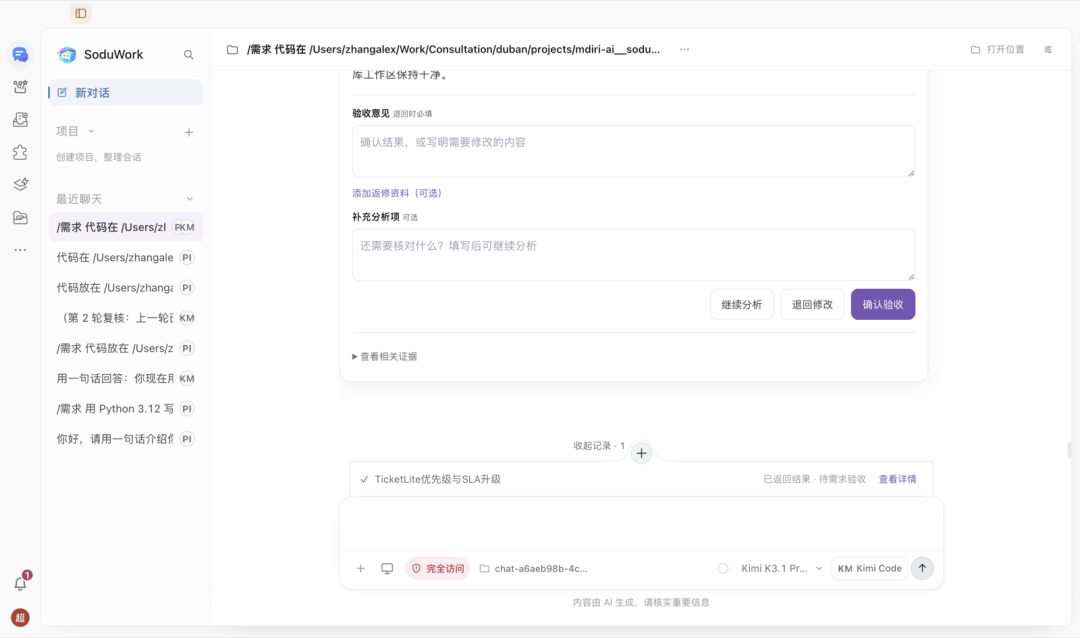
Kimi 复核:退回修改
但它没有意识到交付位置根本错了,这一点是签收检查的第一步(指定仓库没有新提交)抓到的。
按协议,我用「退回修改」发回两件事:签收检查的原始输出(指定仓库自 T1 以来 0 个新提交),以及 AI 复核原文列出的三个校验缺陷。这次返修落到了正确的仓库:34 分钟,7 个提交,测试从 90 个增加到 136 个。它在 A 自己的结构(uv、工厂模式、原有路由)上实现 T2,顺手修了一个 SQLite 外键下迁移失败的问题,还自己做了 v1→v2 的 Docker 升级验证。签收检查一次通过。
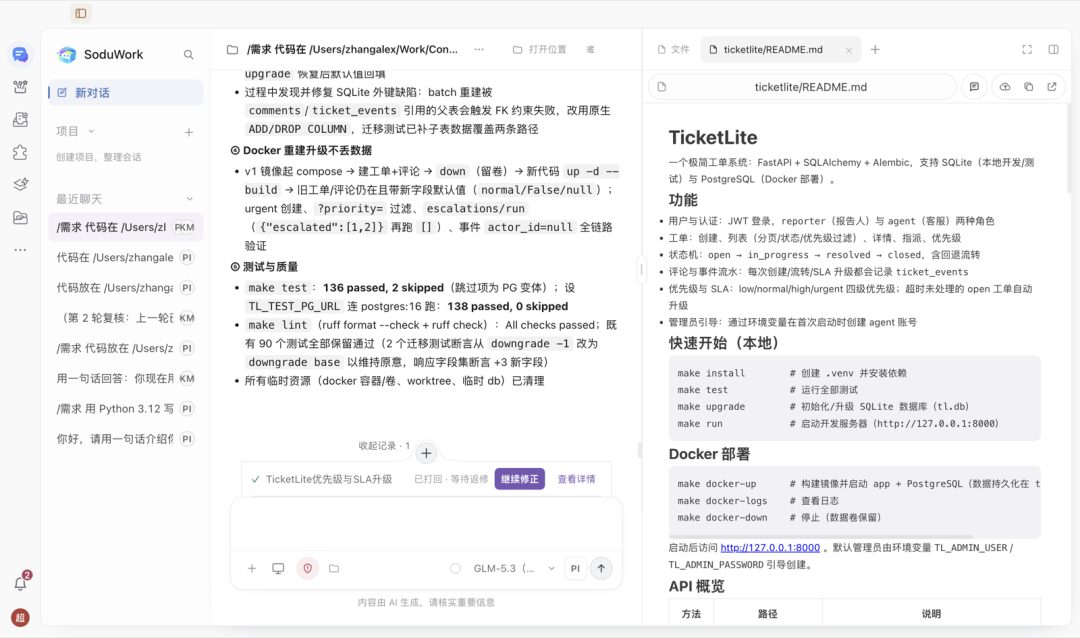
A-T2 返修报告
返修完,需求条又回到“已打回 · 等待返修”。和 T1 一样,SoduWork 没有为返修生成新的交付版本。
六、工程质量对比
两组都以 T2 签收后的版本(t2-done)为准,在干净克隆上度量。
指标 | A(SoduWork 需求流程) | B(直接对话) |
|---|---|---|
隐藏验收(95 条,v1 72 条 + v2 23 条) | 95/95 | 95/95 |
priority=null/ 空过滤值(复核发现的边界) | 422 / 422 / 422 ✅ | 201 / 200 / 200 ❌ |
自带测试数 | 136 | 58 |
业务代码 / 测试代码(行) | 1,077 / 1,632 | 913 / 660 |
平均圈复杂度 / 最大 | 2.49 / 13 | 2.41 / 16 |
模块循环依赖 | 0 | 1 组(deps ↔ main ↔ routers) |
重复代码 | 0.29% | 0.77% |
依赖锁定方式 | pyproject + uv.lock(全闭包) | requirements.txt 精确 pin |
已知漏洞(pip-audit) | 0 | 36 (PyJWT 2.10.1 占 22 个,Starlette 0.41.3 占 14 个) |
认证方式 | 不透明令牌,库里只存 SHA-256 摘要 | JWT,签名密钥默认值 |
硬编码密钥(gitleaks) | 0 | 0 |
make dev在新库上直接可用 | 是(启动前自动迁移) | 否(需先 |
签收检查失败次数 | 1(导出 TL_* 变量后测试互相干扰) | 0 |
我怎么读这张表:
- 用验收测试能测到的功能,流程没有带来差别。
两组都是满分。GLM-5.3 自己就能把一个契约写得很细的 API 做对。
- 差别在验收测试测不到的地方
,测试厚度、依赖卫生、模块边界都是 A 更好。但我不能把这些都归功于 SoduWork 的流程:A 的执行慢了约 3 倍,多出来的时间里,模型把更多事情做细了,这和“有没有复核”未必有关。
- 能明确归功于流程的,是那三个 null 和空值边界。
它们由 Kimi 复核主动探测出来,经过“退回 → 返修”被修掉;B 没有这一步,到现在还在。
- 反过来,复核也有漏掉的东西。
A-T1 的测试隔离缺陷,是靠固定的签收检查抓到的。复核只验证 AI 写下的那几条标准;标准写得窄,复核看的范围也就窄。
七、效率账
任务 | A(SoduWork 需求流程) | B(直接对话) |
|---|---|---|
T1 首轮执行 | 26.5 分钟 | 9.3 分钟 |
T1 从提需求到签收 | 59 分钟,1 轮返修 | 约 17 分钟,0 轮返修 |
T1 token(Pi/GLM) | 871.5 万 | 207.8 万 |
T2 首轮执行 | 42 分钟(做在了错误的代码基上) | 6.3 分钟 |
T2 从提需求到签收 | 约 123 分钟(墙钟 161 分钟,扣掉排队和负载卡顿) | 约 9.5 分钟,0 轮返修 |
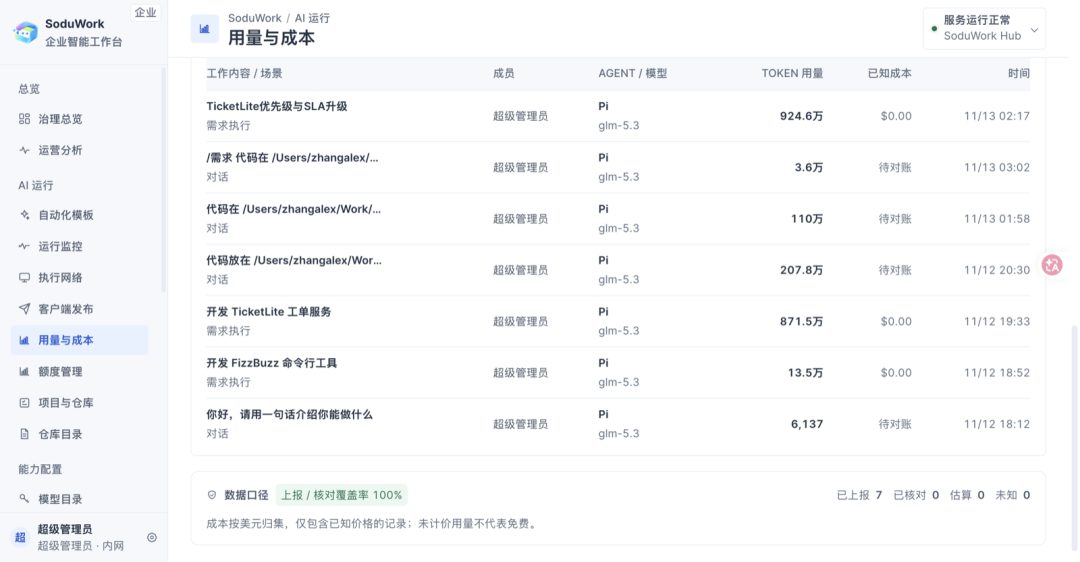
T2 token(Pi/GLM) | 924.6 万 | 110 万 |
复核 | T1 两次、T2 一次,Kimi Code + K3.1 Pro,每次 5–15 分钟,不计入 SoduWork 用量 | 无 |
协议规定的人工动作 | T1 约 14 分钟,T2 约 14 分钟 | T1 约 7 分钟,T2 约 2 分钟 |
人工动作里,A 组大部分花在流程本身:手动提交验收,切换复核底座,绕开退回后无法重新验收的问题,修正 AI 起草里的负责人和路径。按协议做检查、给反馈的时间,两组差不多。
Kimi Code 的复核不进 SoduWork 的用量统计,统计里只有 Pi 的记录。成本一栏是“待对账”,因为模型目录里没有配价格。
用量与成本
八、局限
每个任务每组只跑了一次,没有重复取样,波动有多大不知道。
只评了一个模型组合,一个小项目。
评测由按固定协议执行的自动化评测流程完成,人工时间只代表协议动作的耗时。
只测了不启用插件的直接执行模式,没有测插件工作流。
A 组后半程是在去掉了 Runner 负载门槛、负载很高的机器上跑的。
九、结论与建议
这次能拿到的效率证据是这样的: 对一个契约清晰、规模不大的后端项目,GLM-5.3 直接对话就能在 10 分钟量级做出能通过全部黑盒验收的版本。SoduWork 的需求流程没有让“做对”变得更容易,却让“做细”和“找漏”多了一道关:本次单样本测得它多花 3–8 倍时间和 token(波动范围未知)[2],换来更厚的测试、更干净的依赖,以及一处被独立复核揪出来的真实缺陷[1]。值不值得,取决于你的交付里有多少“验收测试测不到、但上线后会咬人”的东西。
对 SoduWork 本身,我会提这几条:
- 让没有现成插件的需求也能方便地指定复核者。
按节点绑定复核底座目前属于插件工作流,而内置的代码工作流覆盖不到从零开发。可以在「安排执行」里加一个复核者选项,或者提供一个开箱即用的“执行 + 复核”工作流;现在直接执行模式下只能靠手动切换会话底座。
- 退回之后要能重新验收。
直接执行模式下,代码交付一旦被退回,返修完成后既不生成新版本,也提交不了验收,整个验收闭环就断了。
- AI 起草需求时不要改写关键事实。
路径、仓库、环境这类信息应该原样保留,或者显式校验。丢了路径之后,执行方宁可“重建”也不提问,这是这次最危险的一幕。
- 把 Runner 的排队原因显示出来。
机器负载高时,需求会在“正在理解你的要求…”上一直卡着,界面上没有任何提示;而且 CPU 门槛没有配置项可以调。
- 用量统计要覆盖所有底座。
Kimi Code 的复核消耗没有进入统计,算账时会低估流程成本。
对想用它做开发的人,我的建议是: 按任务性质选路径。任务以代码为主、追求效率时,可以在 SoduWork 里让底座直接跑,也就是本文 B 组的做法。需要留下验收证据、多人交接或对外交付时,再走需求流程,同时把完成标准写到行为层面,复核换一个底座和模型。别指望 AI 起草的完成标准替你把关:T1 那 4 条全是交付层面的,复核也就只看了交付层面。
还要说明一点:SoduWork 不替代编程 Agent。按官方 README 的说法,它“不替代它们,而是把它们作为 Harness 接进团队工作台”。它面向的也不只是研发岗位,官方典型场景还包括客诉工单总结、合同初审、变更与成本管理。本文只测了研发这一种用法。
参考链接
本文转载自微信公众号「觉学社」,查看原文。版权归原作者所有,如有侵权请联系删除。