为什么 AI 代码审计不敢信:一个审计 Harness 的死结、解法与哲学
原创 NOP Team 2026-11-20 18:02 北京
这两年 AI 审计工具井喷。拿一个大模型读一读仓库,报一堆"疑似漏洞",演示效果惊艳。但真把它放进安全团队的工作流,大家的反应通常是:「看个热闹,不敢用结论」。
问题不出在模型不够聪明,而出在"审计 Harness"(把工具、AI、流程组织起来的那层壳)的设计。我们做 fiora 的过程,本质上是把这层壳上的死结一个一个解开的过程。这篇文章讲四个死结是什么、我们的解法、效果怎么保证,以及一路沉淀下来的开发哲学。
一、门类的四个死结
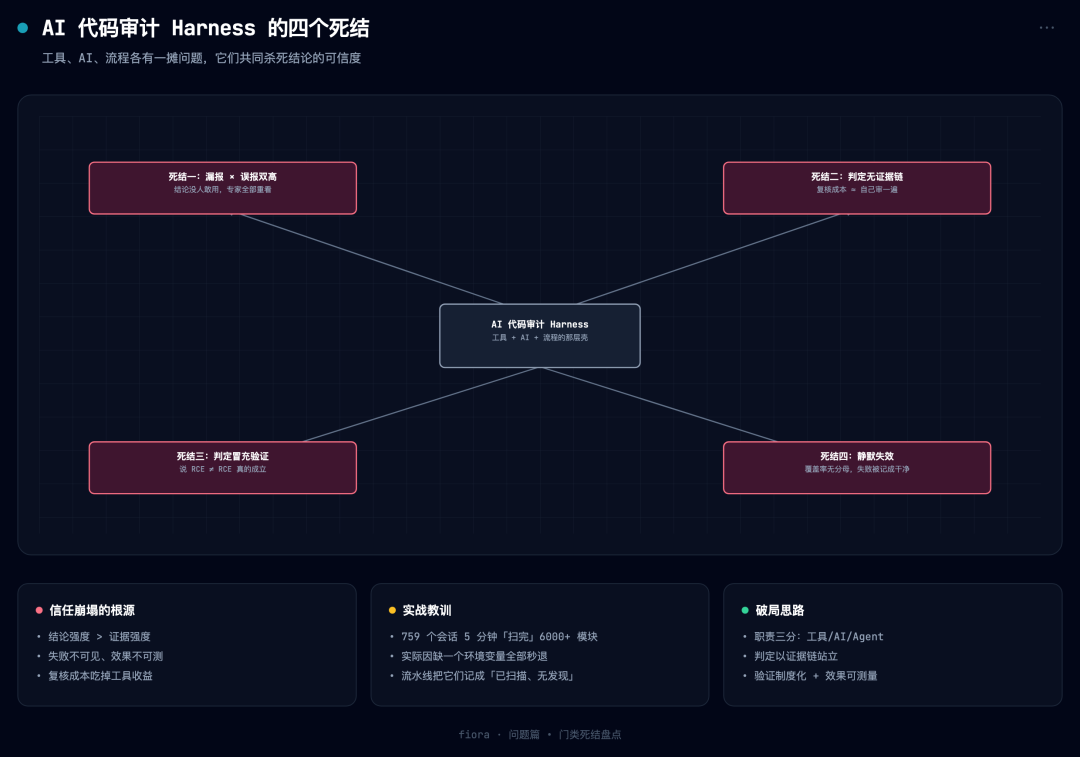
「死结一:漏报与误报双高。」 静态规则工具漏报多(它只认得写死的模式),AI 判定误报多(它擅长把"可疑"讲成"确凿")。两边的结论都不敢直接交付,专家还得自己重看一遍。
「死结二:判定无证据链。」 AI 给一句"此处存在 SQL 注入",却不给完整推理链。安全专家复核一条结论的成本,接近自己从头审一遍。结论再准,验不动就没有工程价值。
「死结三:判定冒充验证。」 静态分析说"这里是 RCE",和"这台服务器上真的能执行代码",隔着十万八千里。工具给到的最强结论其实是"代码形态像漏洞",但报告口吻常常写成"存在 RCE"。承诺透支,信任归零。
「死结四:覆盖率无分母、效果无护栏。」 审计最怕"不知道漏了什么":没查的区域和查过没发现的区域,在输出里长得一模一样。更隐蔽的是,AI 通道自己会静默失效。讲一个我们踩过的真事:早期版本里,模型运行时缺一个环境变量,几百个分析会话全部秒退——但流水线把它们记成"已扫描、无发现"。「5 分钟报出"扫过 6067 个模块",实际一条都没跑」。失败不可见、效果不可测,是这类工具最危险的形态。
二、内核思路:三个责任,各归其位
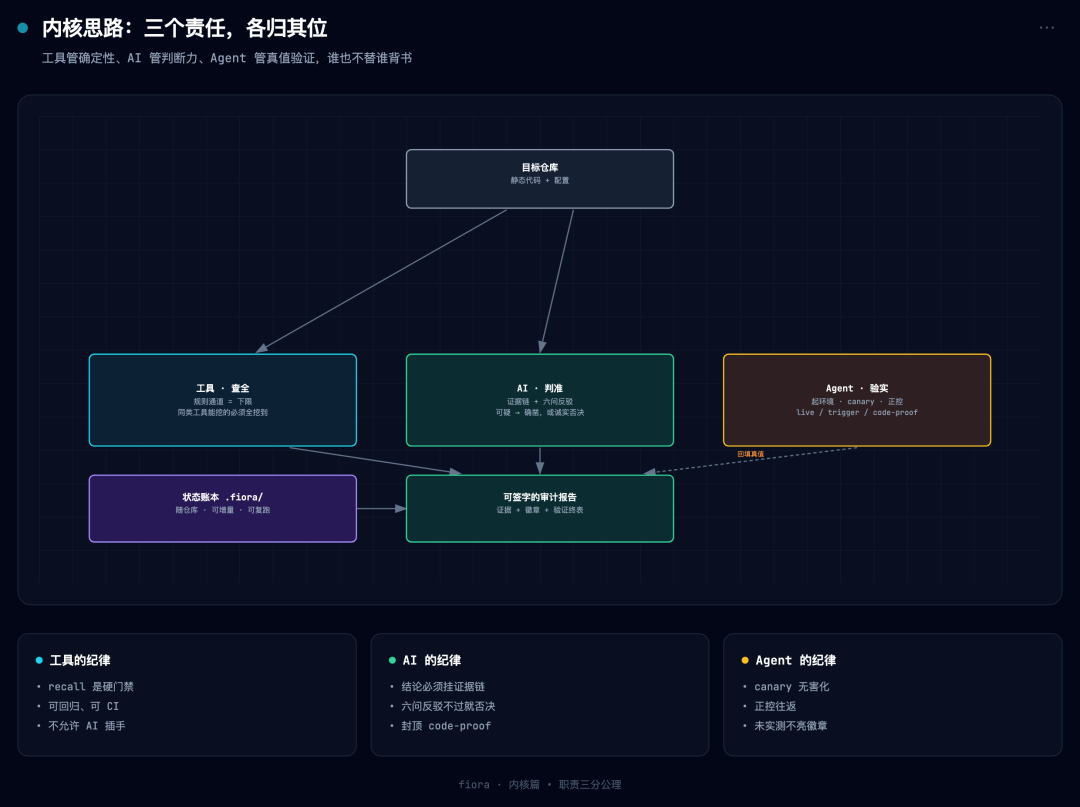
我们的第一条设计公理是「职责三分」:
「工具负责查全」。确定性的规则通道是下限:同类静态工具能挖出来的,一条都不许漏。这层不许 AI 插手,因为它是可回归、可门禁的部分。
「AI 负责判准」。模型的价值不在"看见模式"(工具看得见),而在"判得准":把可疑变成确凿,或者诚实地否决。
「Agent 负责验实」。真正把漏洞"跑出来"的是工作台 Agent:起环境、发载荷、看 canary。判定永远不该冒充这一步。
三层各自有各自的产出和纪律,谁也不替谁背书。报告里"判定"与"验证"是两个独立的章,验证徽章只有真实跑过才亮。
三、方法:让每一个结论都站得住
1. 双通道候选:下限与上限
规则通道做下限(recall 是硬门禁),语义探索通道做上限:让模型带着狩猎计划去挖规则看不见的组合缺陷和 0day。两条通道的候选进同一本账本,身份稳定(同一处问题重跑不会重复计数),可增量、可复跑。
2. 判定必须以证据链站立
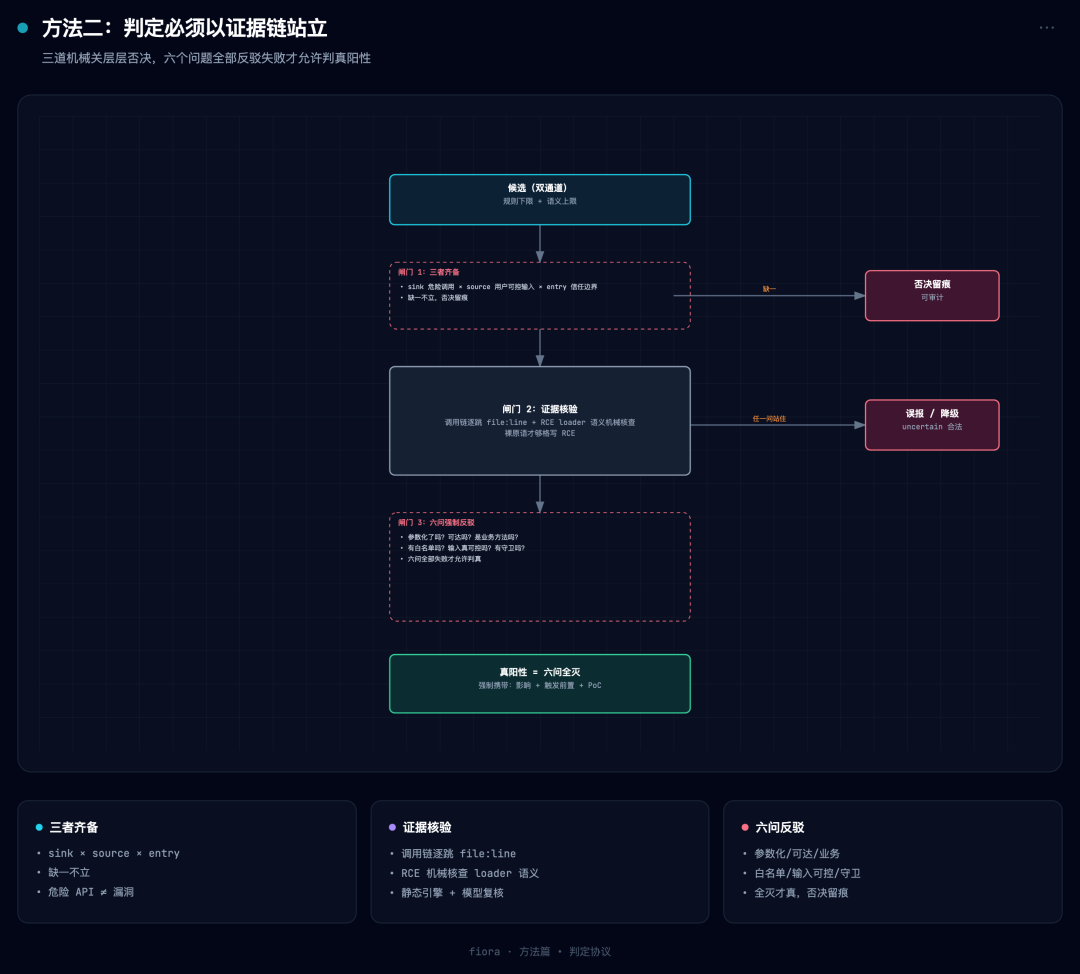
模型下结论之前,要过三道机械关:
「三者齐备」:sink(危险调用)× source(用户可控输入)× entry(信任边界入口),缺一不立。光有危险 API 不算漏洞。
「调用链核验」:静态调用链引擎先追 2-3 跳,模型逐跳用 read/grep 复核,链断了自己补,每一跳都标 file:line。声称 RCE 的还必须引用 sink 的加载语义(
pickle.loads这类裸原语才够格,torch.load(weights_only=True)不许写成 RCE)。「六问强制反驳」:参数化了吗?可达吗?是业务方法吗?有白名单吗?输入真可控吗?有守卫吗?「六个问题全部反驳失败,才允许判真阳性」。任何一问站住,就降级或否决,而且否决同样留档可审计。
真阳性还被强制携带三件套:影响分析、触发前置条件、可复现的 PoC。没有这三样的"发现"在契约层直接拒收。
3. 验证制度化:判定 ≠ 验证
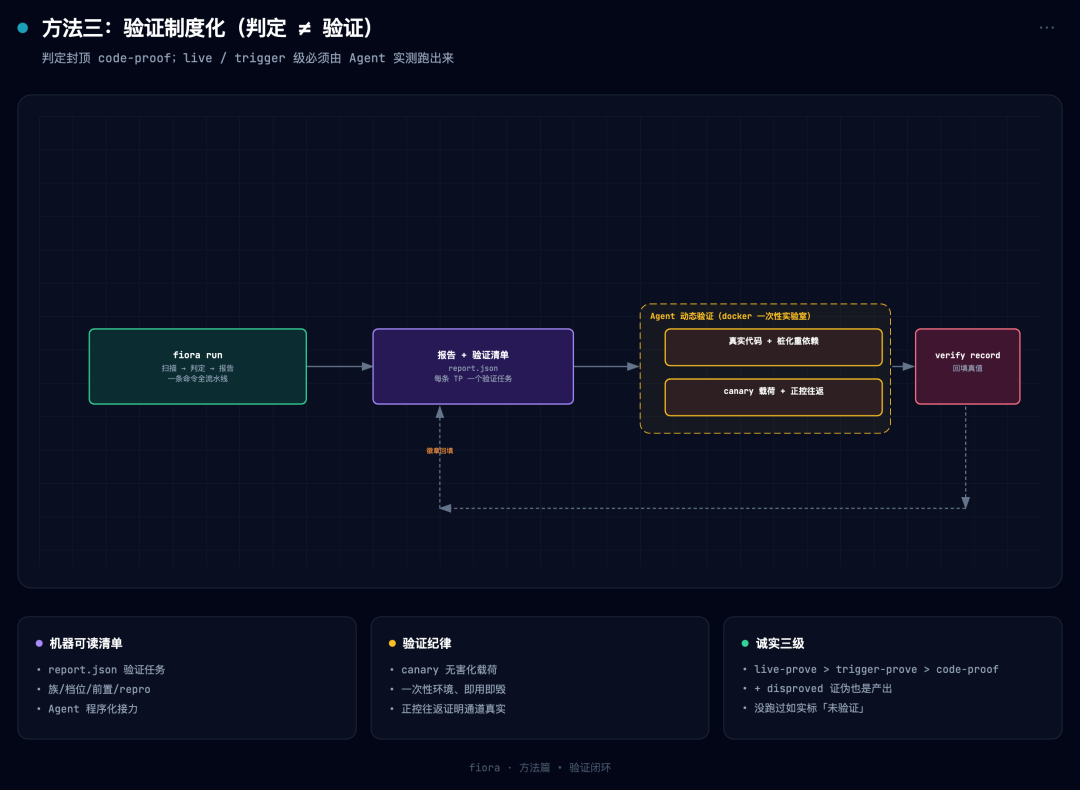
fiora 的判定封顶到 code-proof(代码级论证)。更高的两档必须由 Agent 实测获得:live-prove(真实执行实锤)、trigger-prove(真实代码加载触发)、外加 disproved(证伪,同样是宝贵的审计产出)。Agent 按报告附带的验证清单起 docker 实验室:真实代码 + 桩化重依赖 + canary 无害化载荷 + 正控往返,验完用 verify record 回填真值,报告自动带徽章。没跑过的,报告里如实标"未验证"。
这套闭环在实战里还反向救过判定:一次对预编译 wheel 解压漏洞的动态验证中,负控实验证明判定给的触发前置写错了,正确的前置是另一个配置门——复验结论回填后,清单和判定一并修正。
四、效果怎么保证
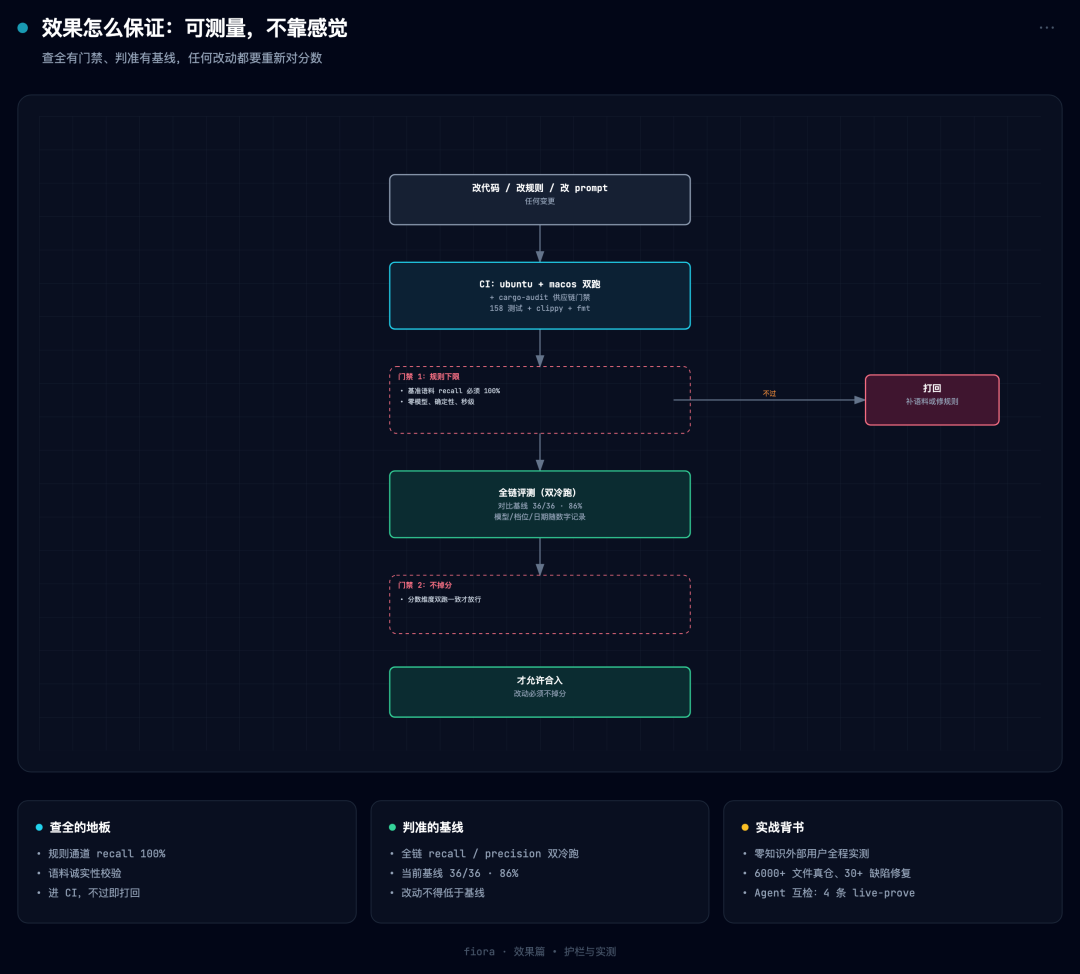
靠"可测量"而不是"感觉不错":
「规则下限门禁」:基准语料上规则通道 recall 必须 100%,进 CI、进不来就打回。这是"查全"的地板。
「全链基线」:完整流水线在标注语料上跑出 recall / precision 基线(我们当前的双冷跑:36/36、86%),「任何改动不得低于基线」。改 prompt、改规则、改引擎,都要重新对分数。
「零知识实测」:开源前让一个"什么都不了解的外部用户"从安装文档开始走完全程,在一个 6000+ 文件的真实开源项目上跑完整审计。这一轮挖出 30 多个真缺陷(包括上面那个假账问题),全部修复后才敢发布。
「Agent 互检」:再让工作台 Agent 用 skill 驱动整套工具做动态验证,4 条高危拿到 live-prove 实锤,其中一条验证过程还推翻并修正了判定的前置条件。工具审代码,Agent 审工具,互为对照。
五、开发哲学
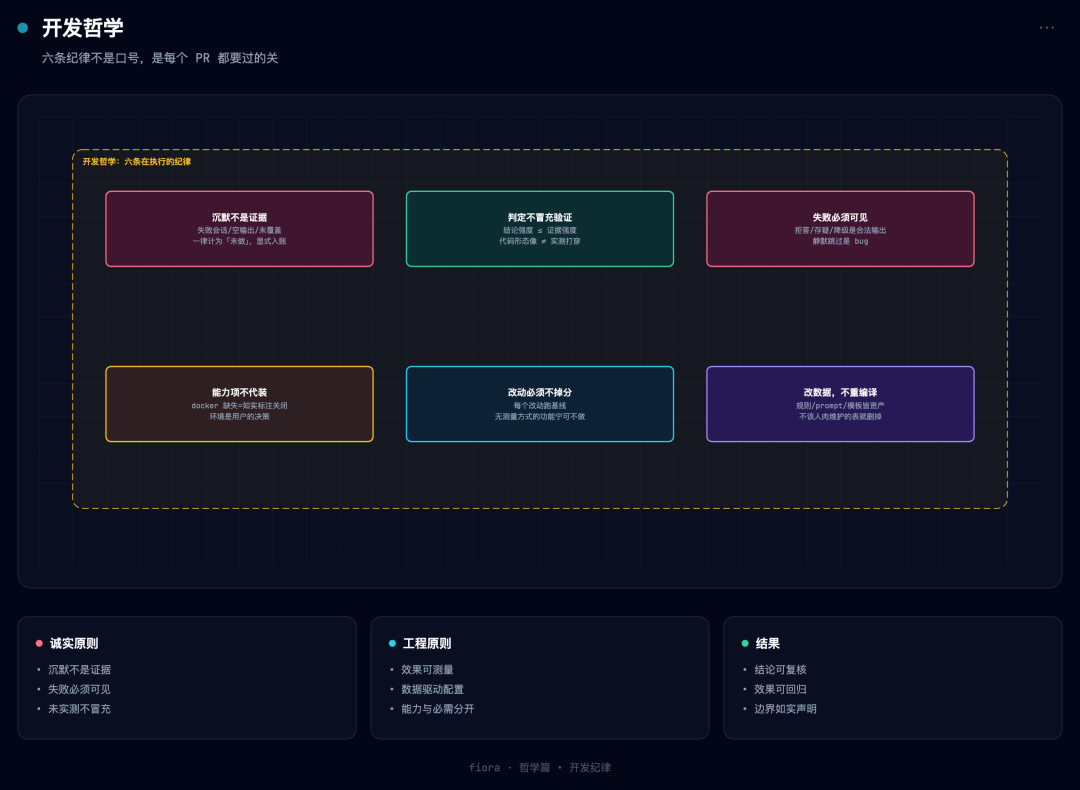
最后是几条我们真的在执行的纪律:
「沉默不是证据。」 会话失败、输出为空、覆盖没做,都必须计为"未做",不许记成"做过且干净"。假账事件之后,所有失败路径都改为显式入账:失败会话数、未交账会话数,和"已扫描"并排打印。
「判定不冒充验证。」 报告里每句话的强度,不超过证据的强度。"代码形态像 RCE"和"实测打穿了"是两个徽章,谁也不许多说一个字。
「失败必须可见。」 拒答、存疑、降级都是合法输出,比硬凑结论诚实。静默跳过是 bug。
「能力项与必需项分开。」 docker 这类"验证能力"的依赖缺失时,如实标注"主动验证关闭",绝不代替用户去安装。环境是用户的决策,工具只报告事实。
「改动必须不掉分。」 每个改动跑基线;效果没有测量方式的功能,宁可不做。
「改数据,不重编译。」 规则、prompt、模板都是运行时数据资产,用户改文件即生效。连"项目画像"这种最初靠人工词表维护的部分,也换成了让模型自己读仓库提取——不该由人肉维护的表,就删掉。
写在最后
fiora 的全部设计,可以压缩成一句话:「让"查全"可门禁、让"判准"可复核、让"验实"可回填」。它不追求替安全专家做决定,而是让每一个决定都有证据链、每一次失败都有痕迹、每一个结论的强度都对得起它的证据。
项目已开源,单二进制、一条命令跑完审计闭环:
「github.com/Ryze-T/fiora」
欢迎拿你自己的仓库试试,也欢迎把你踩到的规则盲区用 fiora draft-rules 起草成规则回馈回来。
本文转载自微信公众号「NOP Team」,查看原文。版权归原作者所有,如有侵权请联系删除。