A*STAR & 南开提出 UNVEIL:重新审视 SAM 3 对非类别概念的分割,原来它早就学会了!
CV君 2026-11-21 11:42 江苏
揭开封印,性能跃迁!
作为分割大模型的重要里程碑,SAM 3 凭借强大的开放词表检测与实例分割能力备受关注。然而,当开发者尝试用“透明玻璃”、“阴影”、“伪装目标”甚至“物体边缘”这类非具体名词短语提示原生 SAM 3 时,模型却常常交出“白卷”——什么也检测不到。
面对这种失效表现,常规直觉通常认为模型缺乏对应的数据微调或未能编码这些抽象语义。但来自新加坡科技研究局前沿人工智能研究中心(CFAR, A*STAR)与南开大学的研究团队给出了截然相反的结论:SAM 3 内部早已“看见”了这些概念,只是在其最终的输出门控中被误杀了。
研究团队在论文《SAM 3 Sees More Than It Detects: Promptable Concept Maps Beyond Categories》中揭示了这一深层机制——“存在否决”(Presence Veto),并推出了全新的解耦框架 UNVEIL。
【模型命名解释】UNVEIL 是 Uncovering Non-detected Visual Evidence In Latents(揭示潜空间中未被检测到的视觉线索)的首字母缩写,该隐喻形象地概括了模型的核心使命:将深藏在 SAM 3 潜在特征中被压制的视觉证据完整释放并“展露”出来。
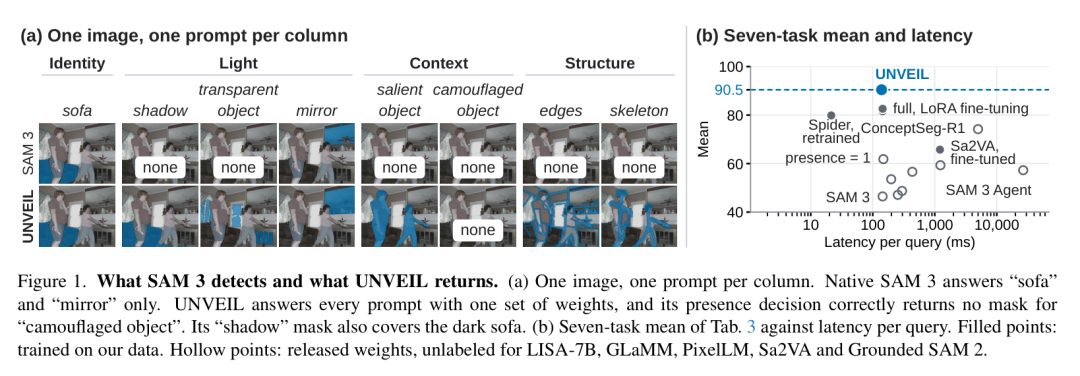
该研究统一了 7 个无类别(class-agnostic)密集预测任务,构建了涵盖 15 个标准测试集、共计 31,175 张图像的评测基准 PCM-Bench。UNVEIL 仅训练了 24.6M 参数(占 SAM 3 总参数量的 2.9%),在 7 项任务的综合平均分上达到了 90.5 分,不仅大幅领先开源多模态大语言模型(MLLM)流水线,更显著超越了 SAM 3 官方全量微调方案(81.6 分),单次推理仅需 138 毫秒。
背景与动机:无类别概念与“存在否决”
在机器视觉系统中,不仅需要识别“这块区域是什么类别(Identity)”,下游任务如机器人抓取、安防监控和图像编辑还频繁依赖一系列无类别的密集信息:
光照属性(Light):哪里有透明玻璃、镜面反射以及阴影遮挡?
环境上下文(Context):哪些目标隐匿在背景中(伪装目标),哪些目标最突出(显著目标)?
几何结构(Structure):物体的边缘线和骨架拓扑落在何处?
这类概念无法归类为离散的具体物体名词,一个显著目标可以属于任意类别,而阴影与边缘本身不属于任何实体。当目标不存在时,模型应准确返回“无(none)”。这种需求被定义为可提示概念图(Promptable Concept Maps, PCM)。
为什么原生 SAM 3 会视而不见?
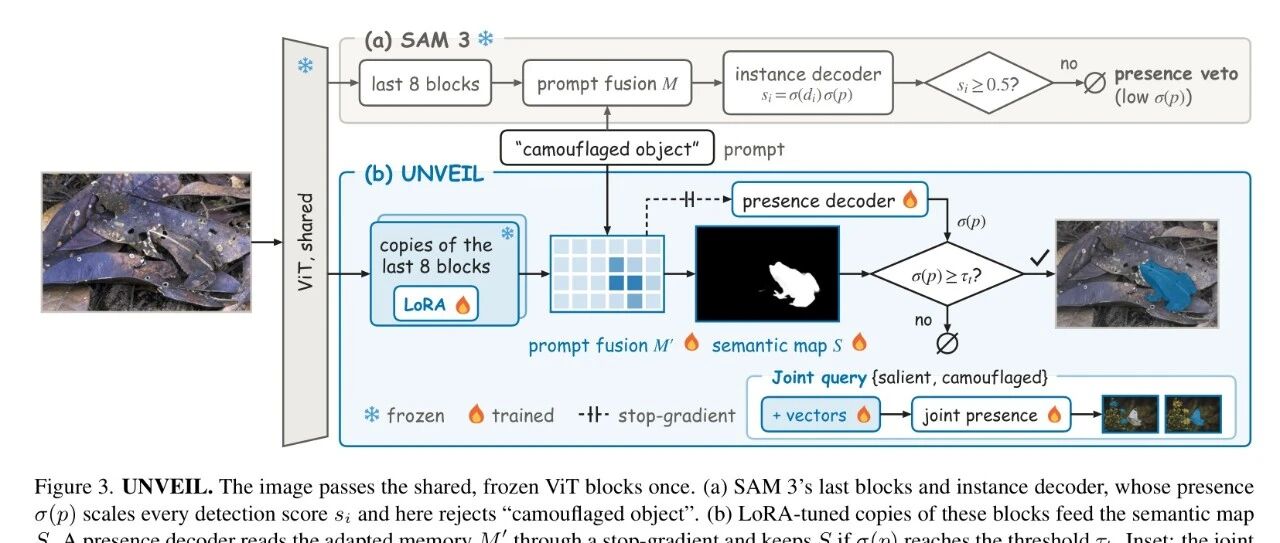
SAM 3 内部采用双分支输出架构:
- 实例路径(Instance Path):采用类 DETR 解码器,利用 200 个 object queries 预测包围盒与实例掩码,同时使用一个存在标记(presence token)输出全图层面的存在对数几率 。第 个检测框的最终置信度得分为:其中 为 Sigmoid 函数。SAM 3 默认仅保留 的目标。这意味着一旦全图存在得分 过低,所有实例都会被无差别过滤。
语义路径(Semantic Path):直接从多模态融合特征中解码出 的连续特征图对数几率 ,该路径在生成特征时不依赖实例级的门控过滤。
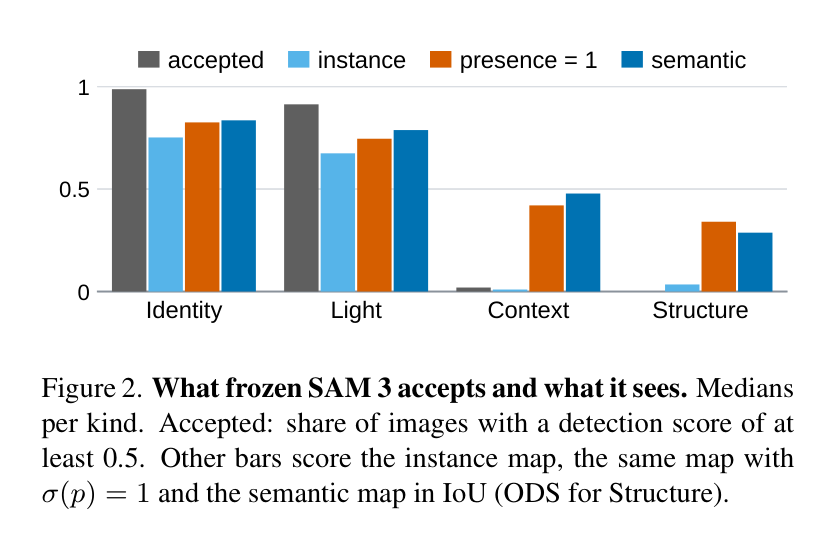
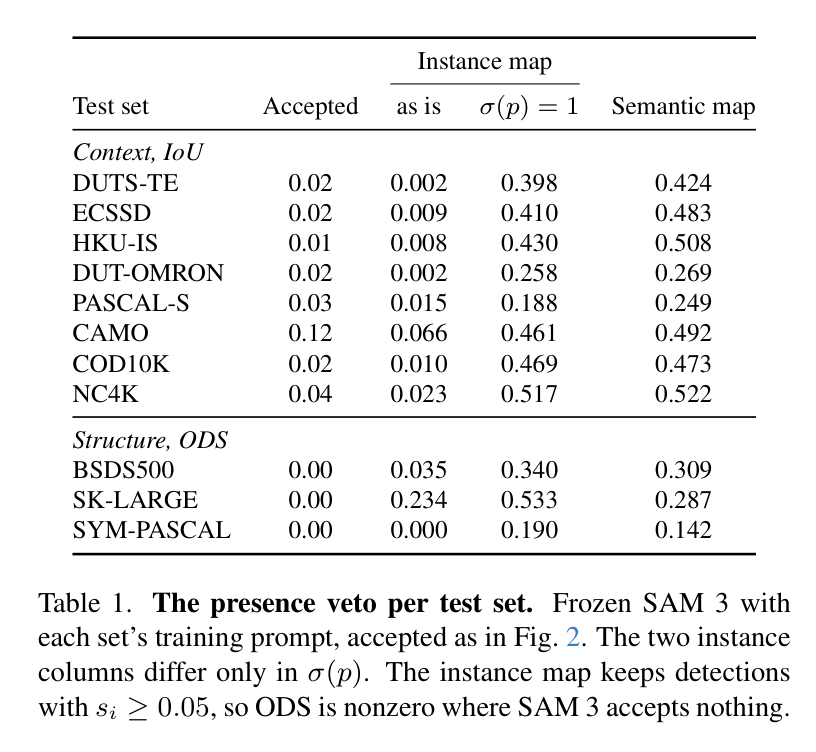
研究团队在 PCM-Bench 上的实验揭开了真相: 如表 1 与图 2 所示,在常规物体识别(Identity)和光照(Light)上,SAM 3 的接受率(即检出得分 的图像比例)中位数高达 0.99 和 0.91;但在上下文(Context)和结构(Structure)概念上,接受率暴跌至 0.02 和 0.00。
然而,如果人为强行将存在门控设为 1(即 ),在不改变任何内部权重的情况下,上下文任务的 IoU 立即大幅恢复 74% 到 99%。在 BSDS500 边缘检测测试集上,ODS 指标从几乎全灭的 0.035 暴增至 0.340。 这证实了 SAM 3 并非无法提取视觉概念,而是被实例路径的存在分类头实施了“一票否决”。
UNVEIL:解耦特征表征与存在判定
既然空间证据完好保存在语义特征中,强行将 置为 1 又会导致模型丧失对“不存在目标”的拒绝能力,UNVEIL 提出了针对性的架构解耦方案。
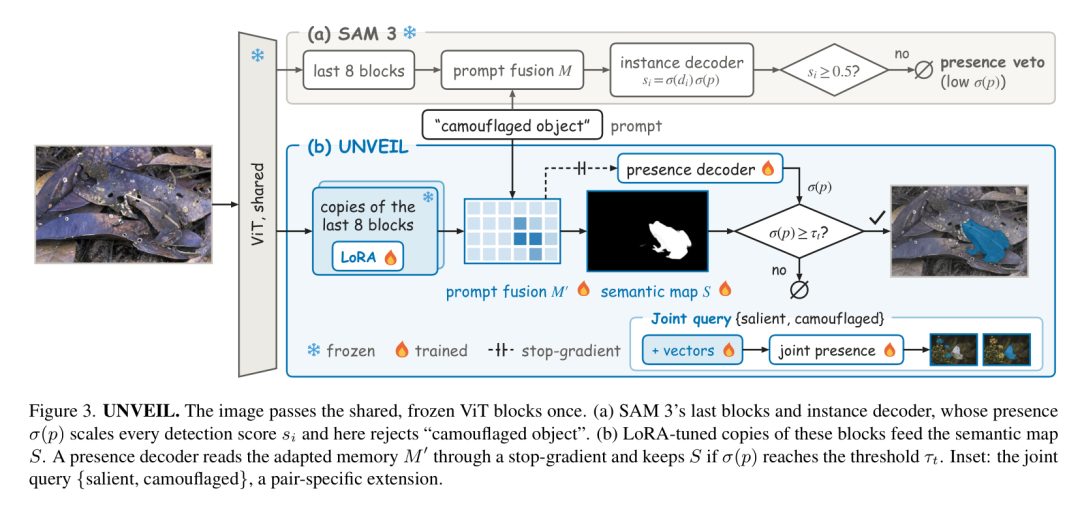
1. 并行语义适配分支与概念回放
如图 3(b) 所示,UNVEIL 保持 SAM 3 的主干网络(ViT 前 24 层)和文本编码器完全冻结,只对 ViT 最后的 8 个 Block(第 24 至 31 层)进行并行复制,并在注意力层与 MLP 中植入 LoRA 适配器(秩 )。
图像特征与文本提示经过提示融合编码器(Prompt Fusion)后形成记忆特征 ,最终由轻量级像素解码器直接输出概念图 。
针对区域任务(透明物体、镜面、显著及伪装目标),采用二值交叉熵(BCE)与 IoU 联合损失监督;
针对阴影任务,采用类别均衡 BCE 联合 IoU 损失;
针对边缘和骨架线条,采用基于边缘检测经典方案的类别均衡损失。
为了防止多任务微调侵蚀 SAM 3 固有的开放词表能力,UNVEIL 引入了概念回放(Concept Replay)机制,在训练过程中混合了 LVIS 图像与类别短语进行联合正则化。
2. 独立存在解码器与梯度截断(Stop-Gradient)
“概念落在何处”和“概念是否存在”是两个不同维度的判断。UNVEIL 采用独立的实例解码器副本专门预测全图存在性对数几率 。
这里的核心设计在于:存在解码器通过截断梯度(Stop-Gradient)接入记忆特征 。 这意味着,利用严密验证的负样本(例如 COD10K 中的无伪装背景图、验证不含目标概念的场景)训练存在分类器时,其分类损失完全不会反向传播污染共享的 LoRA 分支与融合编码器。密集的几何与语义特征学习得以保持纯粹。
推理时,只有当存在概率 超过预设阈值 时,才激活并输出二值化概念掩码 ,否则稳定输出空掩码(“none”)。
3. 约定向量与联合查询
在显著目标检测与伪装目标检测中,学术界存在标注习惯冲突:部分基准单独标记某一类概念,而综合基准(如 USC12K)则将画面互斥地划分为“显著区”与“伪装区”。
针对这一特例,UNVEIL 在提示词输入端引入了可学习的约定向量(Convention Vector)(参数量仅 512)。当遇到联合查询 {显著目标, 伪装目标} 时,模型能够自动协调上下文边界,实现无重叠的场景完美分割。
实验结果与分析
评测基准 PCM-Bench 囊括了 SBU、ISTD(阴影)、Trans10K(透明体)、MSD(镜面)、DUTS-TE、ECSSD、HKU-IS、DUT-OMRON、PASCAL-S(显著目标)、CAMO、COD10K、NC4K(伪装目标)、BSDS500(边缘)以及 SK-LARGE、SYM-PASCAL(骨架)等 15 个基准测试集。
1. 全面领先的综合性能
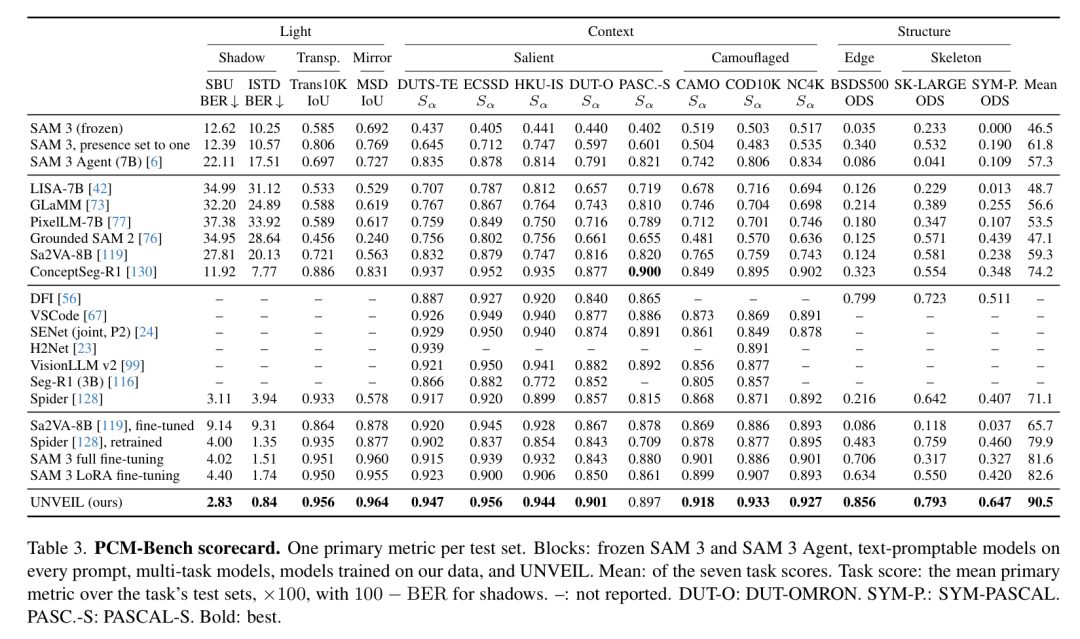
如表 3 所示:
基线表现:冻结的原生 SAM 3 任务均分仅 46.5;引入 Qwen2.5-VL-7B 的 SAM 3 Agent 仅达 57.3;采用 MLLM 提示工程的 ConceptSeg-R1 达到 74.2。
同等数据微调:全量微调参数量达 838.5M 的 SAM 3 官方方案取得 81.6 分;基于 SAM 3 实例路径的 LoRA 微调(26.2M 参数)取得 82.6 分。
UNVEIL 表现:训练参数仅需 24.6M,任务平均分跃升至 90.5 分,并在 15 个评测集中独占 14 项头名。
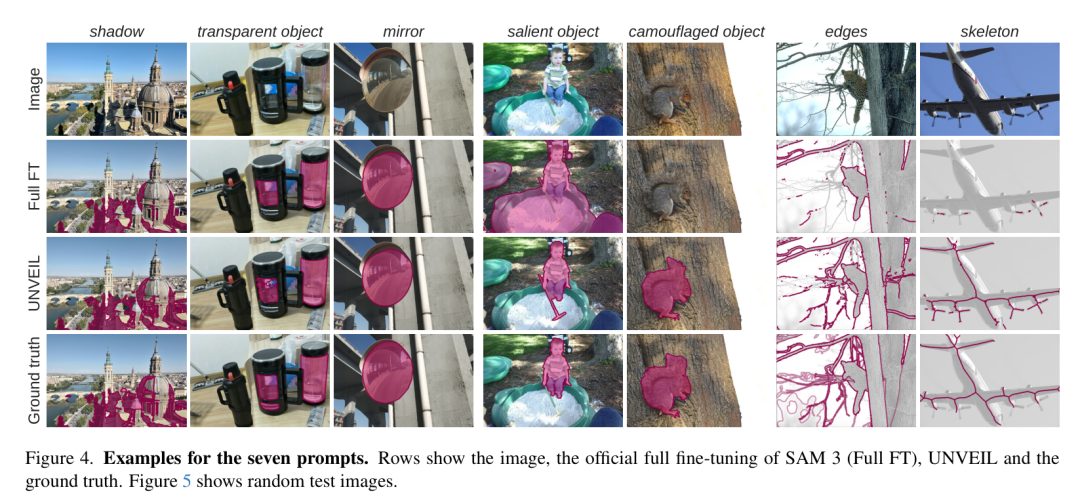
从图 4 的可视化示例可以明显看出,官方全量微调模型在面对极细线条(边缘、骨架)以及大范围半透明折射材质时常出现空洞或轮廓缺失,而 UNVEIL 能够精准还原精细的拓扑几何与光照边界。
2. 训练路径的选择重于参数规模
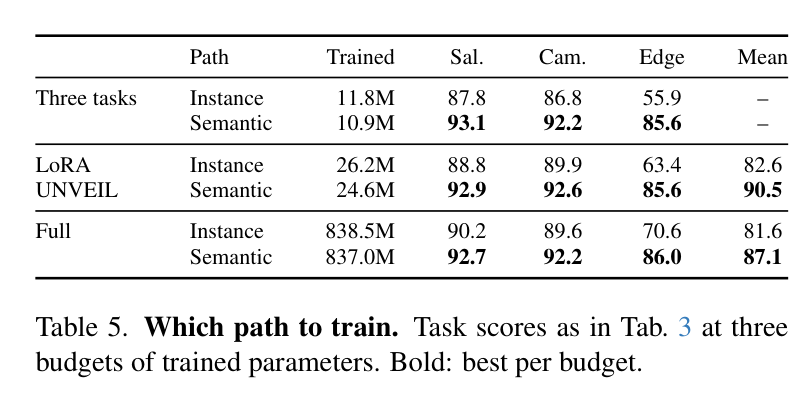
在表 5 的严格受控实验中,作者对比了微调实例路径与微调语义路径的真实效果: 在 11M、25M 与 838M 三种参数预算下,无论参数量如何增大,针对实例路径的训练均显著弱于语义路径。这是因为以检测框和离散实例掩码为核心的 DETR 式输出天生不适于表示连续介质(阴影、玻璃)与纤细结构(像素级边缘与骨架)。
3. 可靠的“拒绝”与零遗忘部署
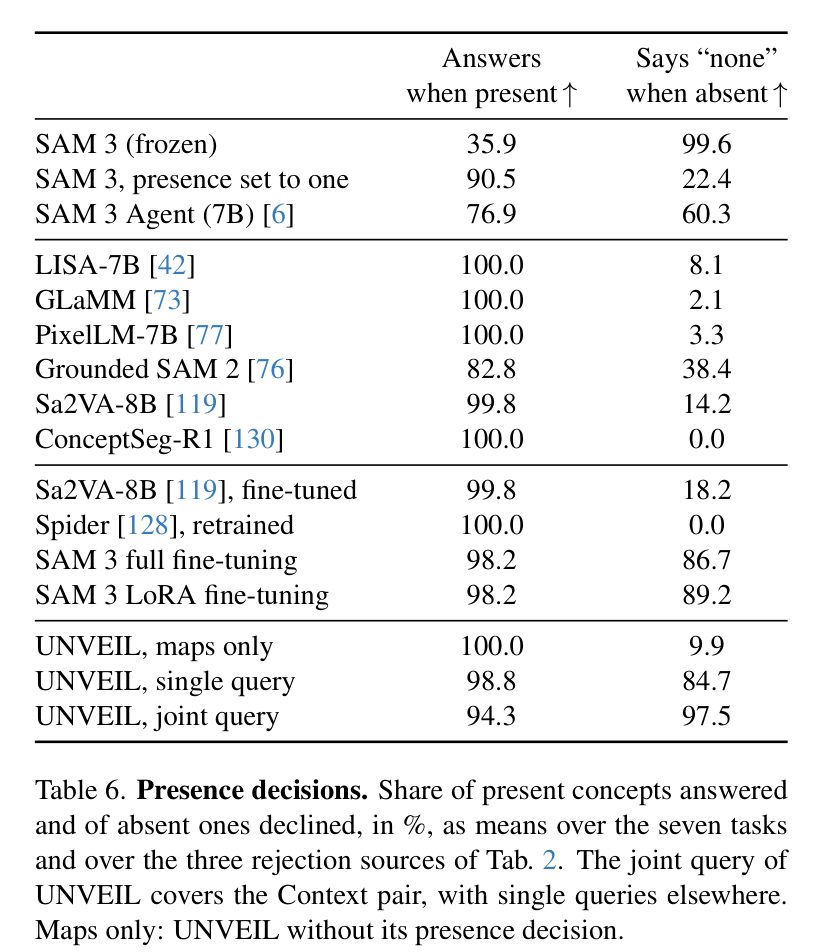
在负样本测试集上(表 6),现有多模态大模型在缺乏目标时展现出极高的虚假检出率(ConceptSeg-R1 的拒识率为 0.0%,即全部误报)。而 UNVEIL 依托独立的截断梯度存在解码器,在目标缺失时的拒识率达到 97.5%(联合查询模式)。
在系统部署层面,UNVEIL 既支持单模型替换推理(仅 138 ms),亦支持并轨运行方案:由于未改动 SAM 3 原始前向网络的核心参数,在 SA-Co/Gold 官方物体基准上,SAM 3 原生检测结果保持 bit-for-bit 完全不变(指标保持 53.92);而直接微调 SAM 3 则会导致该指标大幅跌落至 48.67。
写在最后
UNVEIL 带来了一个富有启发性的视角:当前多模态基础模型在复杂或边缘视觉任务上的“失效”,有时并非模型缺乏表征潜力,而是受制于输出架构与任务对齐方式的局限。通过解耦“表征定位”与“存在判定”,并选择恰当的密集表征路径,仅用极小的适配参数即可唤醒基础模型沉睡的视觉证据。这种高效复用基础模型潜能的方法,对边缘感知、精细操作机器人等领域的密集预测研究具有切实的参考价值。
论文标题: SAM 3 Sees More Than It Detects: Promptable Concept Maps Beyond Categories
所属机构: 新加坡科技研究局前沿人工智能研究中心、南开大学
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。